
large-language-models 第 16 页
本站收录 1059 个带「large-language-models」标签的 AI 开源项目(按 GitHub 星标从高到低,第 16 / 22 页)
 Awesome-VLAAwesome-VLA 是一个精选列表,汇总了视觉-语言-动作(VLA)模型的最新进展。VLA 模型结合视觉、语言和动作,使机器人能够理解自然语言指令并执行相应★ 129
 Qwen3-TTS-EasyFinetuningQwen3-TTS-EasyFinetuning 是一个面向 Qwen3-TTS 模型的简易微调工具,旨在让开发者快速实现声音克隆和多语言高质量语音合成。它解决★ 128
 AAAI2025_MIA-TunerMIA-Tuner 是一个针对大语言模型的预训练文本检测器,核心任务是判断一段文本是否来自模型的预训练数据(即成员推断攻击,Membership Inferen★ 128
 OnlineSPECOnlineSPEC 是一个面向大语言模型推理加速的开源项目,核心思想是将投机解码(Speculative Decoding)与在线学习(Online Lear★ 127
 DeSTA2DeSTA2 是 ICASSP 2025 论文的开源代码与模型,旨在解决语音语言模型(SLM)依赖大量人工标注的语音指令微调数据这一痛点。它提出一种无需语音指令★ 127
 LLM-AutoHotkey-AssistantLLM-AutoHotkey-Assistant 是一个基于 AutoHotkey v2 的桌面工具,通过 OpenRouter.ai 将大语言模型无缝集成到日★ 127
 ai-assisted-task-executor这是一个基于大语言模型的任务驱动型自主代理系统,旨在通过自然语言交互来高效地完成、生成和排序任务。它结合了LangChain框架、向量搜索和多种AI概念,让用户★ 126
 CORECORE 是一个即插即用的对话式智能体,旨在为任意推荐系统赋予自然语言交互能力。它解决了传统推荐系统只能被动接收点击/评分信号、无法理解用户复杂意图的问题。核心★ 126
 agentwatchagentwatch 是一个面向 AI 智能体的可观测性框架,旨在帮助开发者深入洞察智能体与各平台之间的交互过程。它解决了 AI 应用调试和优化中“黑盒”问题,★ 126
 druggptDrugGPT 是一个基于 GPT 策略的早期开源项目,旨在设计针对特定蛋白质的潜在配体分子,即利用生成式预训练模型辅助药物发现中的分子设计环节。它解决的是传统★ 126
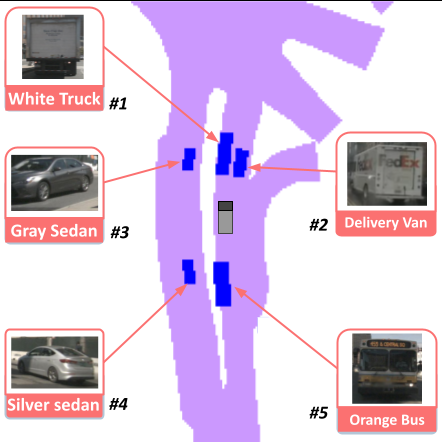 talk2bevTalk2BEV 是一个面向自动驾驶场景的语言增强型鸟瞰图(BEV)地图开源项目,发表于 ICRA 2024。它解决了传统 BEV 感知结果难以被自然语言直接查★ 126
 LatteReviewLatteReview 是一个低代码 Python 包,旨在通过 AI 代理自动化系统文献综述流程。它解决了传统文献综述耗时、费力且容易遗漏关键信息的问题,利用★ 123
 S-EvalS-Eval 是一个面向大型语言模型(LLM)的自动化、综合性安全评估框架。它旨在解决当前 LLM 安全评估中依赖人工、覆盖面窄、难以标准化的问题。项目通过构建★ 123
 awesome-deliberative-prompting这是一个精选资源列表,专注于'审慎提示'(deliberative prompting)技术,旨在指导用户如何向大型语言模型(LLM)提问,以促使其产生可靠推理★ 123
 SLEDSLED 是一种用于提升大语言模型事实准确性的解码策略,通过自我逻辑演化(Self Logits Evolution)在生成过程中动态调整输出概率分布,减少幻觉★ 123
 awesome-ai-eval这是一个关于AI评估领域的精选资源清单,旨在帮助开发者和研究者系统性地了解如何评估AI系统在真实应用中的可靠性。项目汇集了各类工具、方法和平台,覆盖评估框架、指★ 122
 MachineSoMMachineSoM 是一个基于社会心理学视角探索大语言模型智能体协作机制的研究项目,对应 ACL 2024 论文。它旨在回答“多个 LLM 智能体如何像人类社★ 122
 LLM-PuzzleTestLLM-PuzzleTest 是一个专注于多模态谜题推理的开源项目,主要发布用于评估和提升大语言模型(LLM)在多模态谜题场景下推理能力的数据集和模型。该项目针★ 122
 Awesome-Large-Recommendation-Models这是一个精选大型推荐模型(LRMs)最新进展的资源列表,旨在跟踪该领域的前沿研究和开源实现。项目解决了推荐系统领域信息过载、研究进展分散的问题,通过系统化整理相★ 122
 GRAPEGRAPE 是一个面向图神经网络的表示位置编码方法,由 ICLR 2026 论文提出。它通过将节点分组并学习组级别的表示位置编码,解决了传统位置编码在捕捉图结构★ 121
 FollowBenchFollowBench 是一个用于评估大型语言模型(LLM)遵循细粒度指令能力的基准测试集,由 ACL 2024 论文提出。它针对现有基准测试中指令约束过于简单★ 121
 automixautomix 是一个用于混合语言模型的开源项目,核心思路是通过自验证(self-verification)和元验证(meta-verification)机制,★ 121
 SUR-adapterSUR-adapter 是一个为预训练扩散模型设计的轻量级适配器,旨在解决文本到图像生成中文本语义理解不足的问题。它通过从大型语言模型中蒸馏知识,将强大的语义理★ 120
 MAS-ZeroMAS-Zero 是一个专注于多智能体系统设计的开源框架,核心理念是“零监督”,即无需人工标注或外部监督信号,自动构建和优化多智能体协作流程。它解决的是传统多智★ 120
 chat-llama-discord-bot这是一个将大型语言模型接入 Discord 的聊天机器人项目。它解决了在 Discord 服务器中直接使用 LLaMA、Vicuna、Alpaca、MPT 等开★ 119
 manim-generatormanim-generator 是一个基于大语言模型(LLM)的自动视频生成工具,它利用 manim 库将文本描述转化为数学动画视频。该项目通过一个代码编写器(★ 119
 dscdsc 是一个用 C++ 实现的机器学习张量库与推理框架,旨在为深度学习模型提供基础的数据结构和计算能力。它解决的是在资源受限或需要定制化部署环境中,开发者难以★ 119
 Awesome-LLM-Enhanced-Recommender-SystemsAwesome-LLM-Enhanced-Recommender-Systems 是一个由 KDD'25 论文衍生的精选资源列表,系统梳理了大型语言模型(LLM★ 119
 SuperKnowaSuperKnowa 是一个面向企业的 RAG(检索增强生成)管道构建框架,旨在通过类似乐高积木的组件拼装方式,快速搭建面向各类生成式 AI 场景的检索增强应用★ 118
 awesome-data-contamination这是一个关于大语言模型评估中数据污染问题的论文列表项目。数据污染指预训练数据中混入下游评估测试集,导致模型评估分数虚高、结果失真。该项目系统整理了相关研究论文,★ 118
 JacobiForcingJacobiForcing 是一个面向扩散式解码(diffusion-style decoding)的高效推理加速方法,由 ICML 2026 论文提出。它针对★ 118
 BlaGPTBlaGPT 是一个用于基准测试语言模型架构、层和技巧的实验性游乐场,专注于在较小数据集上进行灵活实验。它解决了研究人员和开发者难以快速对比不同模型设计(如注意★ 117
 docwireDocWire SDK 是一个基于 C++20 的本地优先文档数据处理框架,主打确定性、可审计、可私有化部署的工作流。它解决的是企业或开发者在处理大量异构文档时★ 117
 Omni-SafetyBenchOmni-SafetyBench 是一个用于评估音视频大语言模型(AV-LLMs)安全性的基准测试工具,源自 ACM MM 2026 Oral 论文。它解决当前★ 116
 OceanGPTOceanGPT(沧渊)是面向海洋科学任务的大语言模型,由ACL 2024论文提出。它解决通用大模型在海洋领域知识匮乏、专业任务理解不足的问题,通过领域指令微调★ 116
 Flipped-LearningFlipped-Learning 是一个基于 ICLR 2023 论文的开源实现,提出了一种新颖的零样本学习范式。传统方法直接让模型根据输入预测输出,而该方法先★ 116
 HALCHALC 是一个针对多模态大语言模型(如 LLaVA)的物体幻觉抑制工具,基于 ICML 2024 论文实现。它通过自适应焦距-对比解码(Adaptive Fo★ 116
 hallucination-index这是一个评估和排名主流大语言模型(LLM)幻觉倾向的开源项目。它针对常见的任务类型(如问答、摘要、代码生成等),系统性地测试不同模型产生幻觉(即生成与事实不符或★ 115
 open-csai-wikiopen-csai-wiki 是一个开放式的计算机科学与人工智能知识库,将分散的学习笔记整理为体系化内容,覆盖基础知识、数据结构与算法、软件开发、大模型等核心方★ 115
 OgbujiPTOgbujiPT 是一个面向大语言模型(LLM)的客户端工具包,特别强调支持自托管场景。它提供了一套简洁的 Python 接口,帮助开发者统一接入多种 LLM ★ 115
 RLCSDRLCSD 是论文《RLCSD: Reinforcement Learning with Contrastive On-Policy Self-Distilla★ 115
 pII-guardPII Guard 是一个基于大语言模型的工具,用于检测和管理日志中的个人身份信息(PII),旨在支持数据隐私和 GDPR 合规。它解决了开发者在日志中意外记录★ 115
 voyageai-pythonVoyage AI 的官方 Python 库,用于调用其嵌入(Embedding)和重排序(Rerank)API。它解决了开发者在应用中集成高质量文本向量化能力★ 114
 SensorLLMSensorLLM是EMNLP 2025的官方实现,旨在将大语言模型与运动传感器数据对齐,用于人类活动识别。它解决了传统HAR模型泛化能力差、难以理解复杂活动语★ 114
 SatoriSatori是一个基于强化学习的开源模型,旨在通过链式动作思维(Chain-of-Action-Thought)增强大语言模型的推理能力。它由ICML 2025★ 114
 CntxtPYCntxtPY 是一个针对 Python 代码库的发现与压缩工具,旨在为大型语言模型(LLM)生成高效的项目上下文。它通过静态分析构建代码知识图谱,将项目结构、★ 114
 PairCoderPairCoder 是一个面向代码生成的结对编程框架,采用多方案探索与反馈驱动的细化机制,相关论文发表于 ASE 2024 并获杰出论文奖。它解决的是单一代码生★ 114
 dialopDialOp 是一个面向协作型语言代理的决策导向对话环境框架。它解决了当前多智能体对话系统缺乏明确决策目标和结构化评估的问题,提供了一套可配置的对话环境,让语言★ 114
 Advanced_RAGAdvanced_RAG 是一个专注于高级检索增强生成(RAG)技术的开源项目,通过一系列实用 Notebook 展示如何利用 Langchain、OpenAI★ 113
 MineLandMineLand 是一个基于 Minecraft 的大规模多智能体交互仿真框架,旨在研究智能体在有限多模态感知和物理需求下的行为协作。项目解决了现有仿真环境在规★ 113