
computer-vision 第 6 页
本站收录 377 个带「computer-vision」标签的 AI 开源项目(按 GitHub 星标从高到低,第 6 / 8 页)
 world-in-worldworld-in-world 是一个基于闭环世界模型(Closed-Loop World Models)的视频生成开源项目,核心论文发表于 ICLR'26 并获★ 211
 noai-watermarknoai-watermark 是一个开源的 Python 命令行工具,用于移除图像中的隐形 AI 水印(如 SynthID、StableSignature、Tr★ 210
 Matlab-GANMatlab-GAN 是一个基于 MATLAB 实现多种生成对抗网络(GAN)的开源项目,涵盖从基础 GAN 到 Pixel2Pixel、CycleGAN 等经★ 209
 BCIBCI 是一个基于 Pyramid Pix2pix 的乳腺癌免疫组化(IHC)图像生成工具,旨在通过生成对抗网络(GAN)将 H&E 染色的病理图像转换为对应的★ 205
 practical-computer-vision这是一个面向计算机视觉学习者的实战训练营开源项目,以 Jupyter Notebook 为主要载体,配套测验与视频讲解。它解决的是传统 CV 教程偏理论、代码零★ 205
 Data-science-ML-and-DL-Resources这是一个面向机器学习、深度学习和数据科学学习者的免费资源集合仓库。它系统地整理了笔记、课程、视频、项目、文章和代码仓库链接,覆盖了从Python、SQL基础到C★ 200
 HugsVisionHugsVision 是一个基于 Hugging Face 生态的计算机视觉工具包装库,旨在让开发者用极简的代码调用最新的视觉模型。它解决了传统视觉任务中模型集★ 199
 GammaCVGammaCV 是一个面向浏览器环境的 WebGL 加速计算机视觉库,使用 JavaScript 编写。它把图像处理与特征提取等常见 CV 操作搬到 GPU 上★ 195
 DistanceGANDistanceGAN 是论文《One-Sided Unsupervised Domain Mapping》(NIPS 2017)的 PyTorch 实现,用于★ 194
 scene_generation这是一个基于PyTorch的交互式场景生成模型实现,对应ICCV 2019论文《Specifying Object Attributes and Relatio★ 193
 Paint-by-SketchPaint-by-Sketch 是一个基于 Stable Diffusion 的图像编辑方法,用户提供一张草图和一个参考图像,模型将参考图像的内容(如颜色、纹理★ 183
 ML-news-of-the-week这是一个每周更新的机器学习与人工智能新闻精选集,旨在帮助从业者和爱好者高效获取领域内的重要动态。项目将分散在网络各处的优质内容(包括最新研究论文、行业新闻、实用★ 183
 react-mindee-jsreact-mindee-js 是 Mindee 推出的前端计算机视觉 SDK,专为 React 应用设计。它把原本需要后端处理的图像识别能力搬到浏览器端,让开★ 183
 DCLGANDCLGAN 是一个基于 PyTorch 的无监督图像到图像翻译框架,源自 CVPRW 2021 论文《Dual Contrastive Learning fo★ 179
 GestureGANGestureGAN 是一个基于生成对抗网络(GAN)的手势到手势转换工具,发表于 ACM MM 2018(Oral)。它解决的是在自然场景(非受控环境)中,如★ 176
 lucidalucida 是一个基于 BiRefNet 微调的图像抠图工具,专注于处理传统背景移除方法容易失败的复杂场景,如玻璃、迷彩、文字、发光物体和线条艺术。它利用高精★ 174
 custom-diffusion360CustomDiffusion360 是一个基于 Stable Diffusion 的文本生成图像定制化扩展项目,核心解决现有定制化模型(如 DreamBoot★ 173
 Synthesize3DviaDepthOrSil这是一个2017年CVPR论文的开源实现,用于通过多视图深度图或轮廓图来生成和重建3D形状。项目核心是训练一个生成对抗网络(GAN)和变分自编码器(VAE)模型★ 171
 weightslabweightslab 是一个面向 AI 工程师的数据处理基础设施,专注于处理真实世界中杂乱的数据,包括图像、视频和 LiDAR 点云。它解决了 AI 项目在数据★ 168
 PaDTPaDT 是一个面向多模态大语言模型(MLLM)的统一视觉任务框架,其核心思想是将图像分割为可解码的视觉 token(Patch-as-Decodable-To★ 166
 cerulCerul 是一个面向 AI 产品的视频记忆基础设施,为开发者提供 SDK、CLI、MCP 及多种集成方式,帮助 AI 应用理解和利用视频内容。它解决的是 AI★ 164
 locate-anythinglocate-anything 是一个为 NVIDIA LocateAnything-3B 模型打造的轻量级 Web 界面,通过一条 docker compos★ 164
 awesome-ai-services这是一个汇总AI即服务(AI-as-a-Service)领域资源与工具的精选列表项目。它系统梳理了当前市场上各类AI服务,覆盖计算机视觉、人脸识别、实体识别、关★ 162
 instant-nvrinstant-nvr 是 CVPR 2023 的官方代码实现,专注于在几分钟内学习动态人体的神经体积表示。它解决了传统动态人体重建方法训练时间长、计算资源消耗★ 162
 AnomagicAnomagic 是一个面向工业异常检测的零样本异常图像生成框架,对应 AAAI 2026 论文的官方实现。它解决的是工业场景中异常样本稀缺、难以收集的问题,通★ 161
 PromptGallery-stable-diffusion-webuiPromptGallery-stable-diffusion-webui 是一个为 Stable Diffusion WebUI 设计的提示词图库扩展,旨在解决★ 161
 babylogbabylog 是一个面向机器学习团队的轻量级日志工具,专门用于在生产环境中记录图像和模型预测结果。它解决了 ML 系统在部署后缺乏可观测性的问题,帮助团队监控★ 154
 InfiGUI-G1InfiGUI-G1 是一个针对图形用户界面(GUI)智能体的强化学习训练框架,旨在解决 GUI 智能体在语义对齐上的瓶颈问题。它提出了自适应探索策略优化(AE★ 152
 MapReaderMapReader 是英国国家档案馆等机构合作开发的开源计算机视觉流水线,专为大规模地图图像的分析与探索而设计。它将深度学习模型(基于 PyTorch)与地理空★ 150
 LiveWorldLiveWorld 是 ECCV 2026 论文的官方实现,旨在解决生成式视频世界模型中“视野外动态”的模拟问题。传统视频生成模型只能基于可见帧进行预测,而 L★ 147
 faster_coco_evalfaster_coco_eval 是已废弃项目 fast-coco-eval 的延续维护版本,用 Python 重写并加速了 COCO 数据集的目标检测/实例分★ 147
 Mamba-in-Computer-Vision这是一个关于Mamba模型在计算机视觉领域应用的综合性综述项目,系统梳理了Mamba(状态空间模型)在视觉任务中的技术进展与应用场景。Mamba是一种新兴的序列★ 144
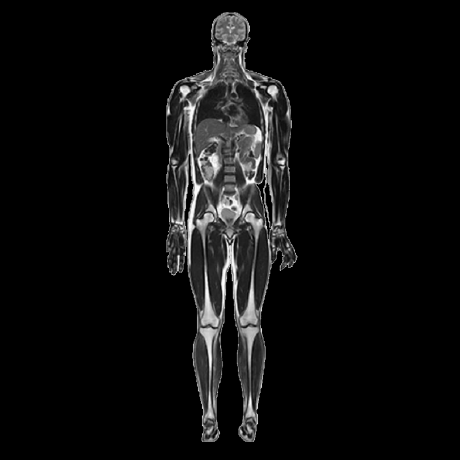 MuscleMapMuscleMap 是一个开源、社区支持的全身肌肉定量 MRI 分析平台。它解决的是肌肉萎缩、肥胖、代谢疾病等研究中缺乏标准化、可重复的全身肌肉影像分析工具的问★ 144
 ConffusionConffusion 是论文《Conffusion: Confidence Intervals for Diffusion Models》的官方实现,旨在为扩散★ 143
 pyxuPyxu是一个专注于计算成像的Python开源库,旨在提供模块化、可扩展的成像算法开发框架。它解决的是传统成像算法实现中代码复用性差、难以扩展到大规模数据或GP★ 142
 ppu-paddle-ocrppu-paddle-ocr 是一个用 TypeScript 重写的 PaddleOCR 轻量级 SDK,目标是在任何能运行 JavaScript 的环境里做多★ 142
 OneShotTranslationOneShotTranslation 是论文《One-Shot Unsupervised Cross Domain Translation》(NIPS 2018★ 141
 ZeroShapeZeroShape是一个基于回归的零样本三维形状重建项目,旨在从单张图像直接恢复物体的三维几何结构。它解决了传统三维重建方法依赖大量标注数据、泛化能力差的问题,★ 141
 articles-codearticles-code 是一个解码机器学习文章的中心,提供带有代码的实战文章,专注于生产级机器学习。该项目以 Jupyter Notebook 为主要载体,★ 141
 Ground-A-VideoGround-A-Video 是一个基于扩散模型的零样本视频编辑工具,来自 ICLR 2024 论文。它解决了传统视频编辑需要逐帧处理、难以保持时空一致性的痛点★ 140
 TokenComposeTokenCompose 是一个基于扩散模型的文本到图像生成方法,核心创新在于引入 token 级别的监督信号,以解决多物体组合生成中常见的问题,如物体遗漏、属★ 138
 simple-diffusionsimple-diffusion 是一个用 PyTorch 实现的最小化去噪扩散模型,旨在以极简代码展示扩散模型的核心原理。它解决了初学者理解扩散模型门槛高的问★ 137
 ASHASH 是 CVPR 2024 论文《Ash: Animatable Gaussian Splats for Efficient and Photoreal H★ 137
 awesome-artificial-intelligence-research这是一个面向 AI 研究者的精选资源清单(Awesome List),系统整理了人工智能各子领域的前沿论文、工具、数据集与学习资料,覆盖推荐系统、计算机视觉、机★ 133
 ExprGANExprGAN 是一个基于 TensorFlow 实现的面部表情编辑开源项目,核心创新在于可控的表情强度编辑。它解决了传统 GAN 只能生成固定表情、无法精细控★ 126
 awesome-ai-tutorials这是一个精选AI教程的集合仓库,旨在帮助学习者系统掌握数据科学和人工智能的核心技能。项目将分散在网络上的高质量教程、课程和资源进行整理归类,覆盖机器学习、深度学★ 124
 albucorealbucore 是 Albumentations 团队拆分出的底层图像处理库,用 OpenCV、NumPy、SimSIMD 等实现高性能基础算子,供 Albu★ 123
 wechat-mac-rpawechat-mac-rpa 是一个面向 macOS 微信客户端的视觉 RPA 自动化框架,核心思路是用多模态视觉感知代替传统控件抓取,再叠加 LLM Agen★ 122
 NAFNAF(Neighborhood Attention Filtering)是一个用于零样本特征上采样的开源模型实现,由微软研究院和威斯康星大学麦迪逊分校的研究者★ 120
 ai-image-clean-eraserai-image-clean-eraser 是一个基于浏览器的 AI 图像文字擦除工具,主打 2026 年式的自动检测与手动精修双模式。它要解决的问题很直接:日★ 120