
项目预览
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-11-08 · 当前星标 ★ 224
核心亮点
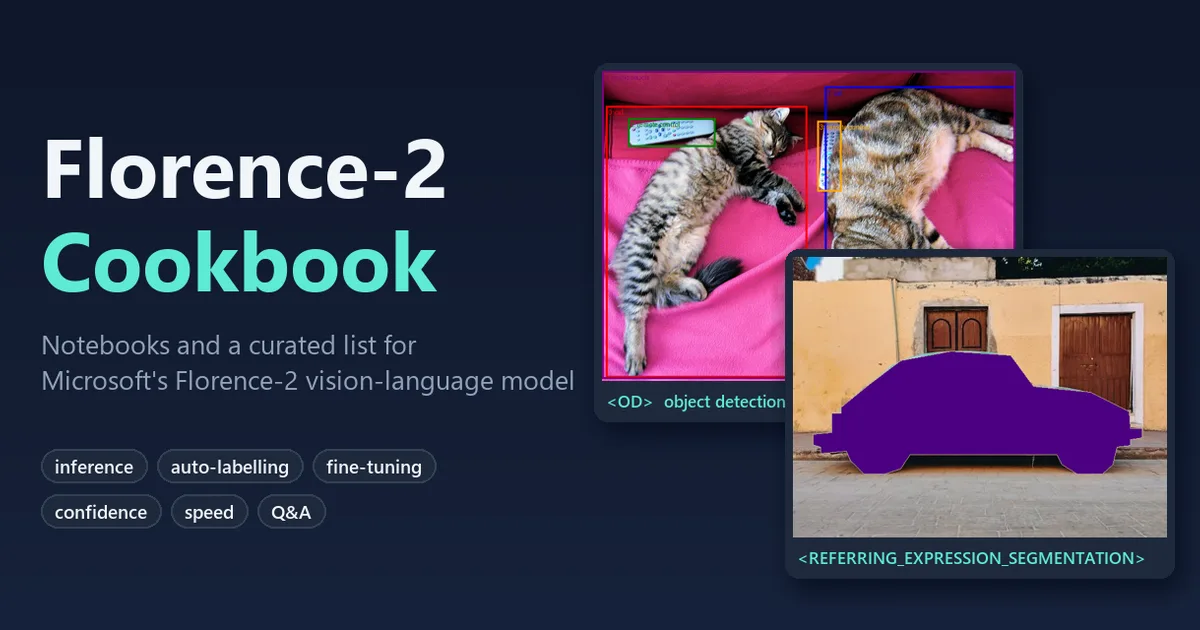
- 以 Notebook 组织,推理、自动标注、微调分文件演示,可逐格运行并直接改参数验证
- 覆盖目标检测、OCR、区域描述等多任务提示写法,并给出输出解析示例,省去读源码摸索
- 包含用模型批量生成标注再回流训练的完整思路,对构建自有数据集有直接参考价值
不足之处
- 非官方项目,与 Florence-2 上游版本更新不同步,模型接口变动后示例可能失效
- Notebook 偏演示性质,缺少工程化封装、批量推理与性能优化内容
- 微调部分依赖具体硬件与数据格式,文档对显存要求和常见报错说明有限
适用场景
- 快速验证 Florence-2 在检测、OCR、图像描述等任务上的实际效果
- 为自有图像数据集批量生成预标注,减少人工标注成本
- 在垂直领域小样本上微调 Florence-2,做场景化适配实验
替代项目
Florence-2、transformers、ultralytics
上一篇:ssocr
下一篇:stb-tester
同类项目推荐
 ccv
开源
纯 C 写的轻量视觉库,不装大框架也能跑人脸检测和图像分类
C-based/Cached/Core Computer Vision Library, A Modern Computer Vision Library
 jietuba
开源
Windows 截图后长截图、OCR、翻译、录屏一站搞定
Open-source Windows screenshot tool with scrolling capture, annotation, OCR, transla···
 core
开源
把零散 OCR 工具串成标准化流水线,古籍数字化更省心
Collection of OCR-related python tools and wrappers from @OCR-D
 diffusion-vas
开源
用扩散先验,让视频分割看穿遮挡,补全完整物体。
[CVPR 2025] Official code for Using Diffusion Priors for Video Amodal Segmentation
 PGS
开源
在Processing里轻松搞定复杂几何处理,让创意不卡壳。
Processing Geometry Suite
 ArtEq
开源
让AI看懂没见过的姿势,人体重建更稳更准
Generalizing Neural Human Fitting to Unseen Poses With Articulated SE(3) Equivarianc···
 bootcamp
开源
一套代码搞定图像、音频、分子等非结构化搜索
Dealing with all unstructured data, such as reverse image search, audio search, mole···
 MovieChat
开源
把整部电影装进模型,问啥答啥,长视频理解不再难。
[CVPR 2024] MovieChat: From Dense Token to Sparse Memory for Long Video Understandin···
 EndoDAC
开源
让基础模型秒变内窥镜深度感知专家,无需标注即可用
[MICCAI 2024] EndoDAC: Efficient Adapting Foundation Model for Self-Supervised Depth···