
semantic-search
本站收录 143 个带「semantic-search」标签的 AI 开源项目(按 GitHub 星标从高到低,此处展示前 50 个)
 generative-ai-for-beginners这是微软出品的面向初学者的生成式 AI 课程,共 21 节课,涵盖生成式 AI 的基础概念、提示工程、大语言模型、RAG、AI Agent 以及相关应用开发。课★ 120,786
 khoj可自托管的 AI 第二大脑,支持联网搜索与本地文档问答,能构建自定义智能体、定时自动化任务并进行深度研究。可将 GPT、Claude、Gemini、Llama、★ 37,537
 WeKnora腾讯开源的 LLM 知识平台,将原始文档转化为可查询的 RAG、自主推理 Agent 与自动维护的 Wiki。构建企业级知识中枢,让知识自动沉淀、检索与推理,助★ 31,212
 RAG_TechniquesRAG_Techniques 是一个专注于检索增强生成(RAG)技术的开源教程仓库,汇集了从基础到前沿的多种 RAG 实现方法。它通过一系列详细的 Jupyte★ 29,631
 haystackHaystack 是一个开源的 AI 编排框架,用于构建生产级、上下文工程化的 LLM 应用。它通过模块化管道和代理工作流,让开发者对检索、路由、记忆和生成等环★ 26,634
 DocsGPTDocsGPT 是一个面向企业的私有 AI 平台,专注于智能文档问答与知识检索。它解决了企业内部文档分散、查找困难、信息利用率低的问题,通过自然语言交互,让用户★ 18,295
 weaviate开源向量数据库,同时存储对象与向量,将向量相似度检索与结构化过滤无缝结合,兼具云原生数据库的容错性与可扩展性。支持多种嵌入模型与模块化扩展,常被用于构建语义搜索★ 16,860
 memvidmemvid 是一个为 AI 代理提供记忆层的开源项目,旨在用无服务器、单文件的记忆层替代复杂的 RAG 流水线。它解决了 AI 代理在长期对话或任务中缺乏持久★ 16,566
 zveczvec 是一个轻量级、极速的进程内向量数据库,专为需要高性能向量检索的 AI 应用设计。它解决的是传统向量数据库部署重、延迟高的问题,将向量索引和检索能力直接★ 16,030
 semantica以图为核心的 AI 基础设施,致力于为上下文管理与可问责 AI 系统提供支撑。通过知识图谱表达实体关系与上下文,为智能体提供结构化、可追溯的推理依据,在需要透明★ 13,540
 txtaitxtai 是一个全栈 AI 框架,旨在将语义搜索、大语言模型编排和语言模型工作流整合到一个统一的工具中。它解决了从非结构化文本中高效检索信息、构建 RAG 应★ 12,988
 claude-context专为 Claude Code 打造的代码搜索 MCP 服务,让整个代码库都能成为任意编程代理的上下文。通过精准的代码检索,Agent 无需翻阅大量文件即可找到关★ 12,575
 cocoindexcocoindex 是一个面向长时程智能体的增量计算引擎,用 Rust 编写。它解决的是智能体在长时间运行中需要持续感知和利用不断变化的数据(如代码库、文档、用★ 11,630
 lancedbLanceDB 是一个用 Rust 编写的开源嵌入式向量检索库,面向多模态 AI 应用。它把向量数据库能力做成可嵌入的库,无需单独部署服务,开发者可以直接在应用★ 11,562
 GPTCacheGPTCache 是一个面向大语言模型(LLM)的语义缓存工具,核心解决 LLM 推理成本高、响应慢的问题。它通过缓存相似的查询结果,让重复或相近的请求直接命中★ 8,206
 airweave面向 AI Agent 的开源上下文检索层,专注解决智能体的上下文获取问题。它支持连接多种数据源、清洗并向量化数据,为 Agent 提供高质量、低延迟的检索能力★ 6,560
 obsidian-smart-connectionsobsidian-smart-connections 是一个 Obsidian 插件,旨在写作时自动发现并展示相关笔记和摘录,充当链接构建的副驾驶。它利用本地嵌★ 5,473
 superduperSuperduper 是一个端到端的开源框架,用于构建自定义 AI 应用和智能代理。它解决了将 AI 模型(如 LLM、预训练模型)与现有数据基础设施(尤其是 ★ 5,327
 code-graph-ragcode-graph-rag 是一个面向大型代码仓库(monorepo)的检索增强生成(RAG)系统,旨在解决传统 RAG 在代码理解上的不足。它通过构建代码知★ 5,190
 SimpleMemSimpleMem 是一个为大型语言模型(LLM)智能体设计的终身记忆模块,旨在解决智能体在长期交互中遗忘历史信息、缺乏持续学习能力的问题。它通过高效的记忆存储★ 3,819
 zvec-grepzvec-grep 是一个用 Rust 编写的本地优先搜索工具,面向开发者和 AI Agent 场景,目标是在整个工作区里做统一检索。它把传统全文搜索(BM25★ 3,796
 awesome-generative-ai这是一个精心整理的生成式AI资源清单,汇总了工具、模型、论文和参考链接,覆盖ChatGPT、Midjourney、DALL-E等主流技术。它解决了AI领域信息过★ 3,546
 siesie 是一个开源的推理服务器和生产级集群,专为智能体(agent)所需的各类模型提供统一部署和调度。它解决了多模型、多副本在生产环境中难以统一管理的问题,提供★ 3,337
 SocratiCodeSocratiCode 是一款面向企业级大型代码库的智能分析工具,专为处理超过 4000 万行代码的复杂项目而设计。它无需复杂配置即可本地运行,保护代码隐私,可★ 3,326
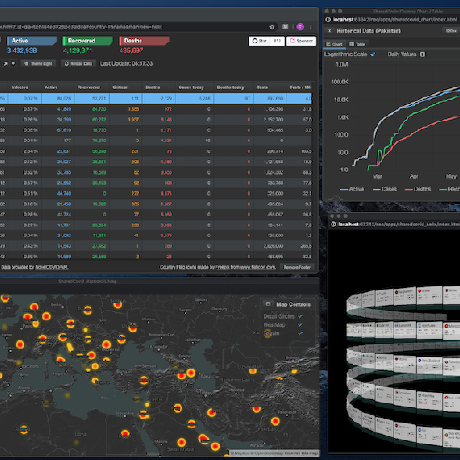 neoNeo.mjs 是一个自我进化的软件有机体,本质上是一个端到端的专业 AI 工程团队。它通过 Neural Link 让跨模型智能体群组直接嵌入到实时前端应用中★ 3,280
 examplesPinecone 官方提供的 Jupyter Notebook 示例集合,帮助开发者快速上手 Pinecone 向量数据库。它通过一系列可交互的 noteboo★ 3,044
 databerrydataberry 是一个无代码平台,用于快速构建自定义的 LLM 智能体(Agent)和聊天机器人。它解决了非技术人员难以将大语言模型接入私有数据、构建对话应★ 2,965
 ReadAnyReadAny 是一款基于 AI 的跨平台电子书阅读器,支持 EPUB 等格式,内置语义搜索、RAG 聊天、本地向量存储、笔记、TTS 朗读和 WebDAV 同★ 2,687
 memsearchmemsearch 是一个为 AI 智能体(如 Claude Code、Codex)设计的持久化统一记忆层,基于 Markdown 和 Milvus 向量数据库★ 2,684
 xerjXERJ 开创了 AI 搜索数据的新方式,其自动索引能力让智能体无需消耗大量 token 即可掌握你的数据。一条命令即可索引代码、文档、日志与 PDF,服务于搜★ 2,563
 bootcampBootcamp 是一个专注于非结构化数据搜索与分析的教程型开源项目,涵盖反向图像搜索、音频搜索、分子搜索、视频分析、问答系统及 NLP 等主题。它通过 Jup★ 2,445
 JustHireMeJustHireMe 是一个本地优先的 AI 求职情报工作台,专为求职者设计。它通过爬取招聘信息、评估职位匹配度,并自动生成定制化的申请材料,帮助用户高效管理求★ 2,255
 kernel-memorykernel-memory 是微软开源的认知记忆服务,专为 AI 应用和智能代理设计。它解决的是大语言模型缺乏长期记忆和私有知识检索的问题,允许开发者将文档、网★ 2,235
 SeekStormSeekStorm 是一款用 Rust 实现的高性能搜索库,同时支持向量检索与词法检索,提供进程内库和多租户服务器两种形态。它兼具速度与灵活性,适合构建高性能、★ 1,917
 grepaigrepai 是一个面向 AI 编程代理的本地语义搜索与调用图工具,用 C 语言编写,主打 100% 本地运行、隐私优先。它解决的核心问题是:传统 grep 只★ 1,894
 yt-ftsyt-fts 是一个命令行工具,用于对 YouTube 视频进行全文搜索。它允许用户下载视频字幕,建立本地索引,并通过命令行快速搜索所有已索引视频中的文字内容。★ 1,812
 fastRAGfastRAG是一个专注于高效检索增强生成(RAG)的开源框架,旨在解决企业落地RAG时面临的性能瓶颈和部署复杂性问题。它基于Haystack构建,但针对生产环★ 1,787
 lotusLotus 是一个专注于大规模数据处理的开源框架,旨在为代理(Agent)和大型语言模型(LLM)提供高效的批量处理能力。它解决了传统 LLM 在处理海量数据时★ 1,707
 mcp-server-qdrantmcp-server-qdrant 是 Qdrant 官方推出的模型上下文协议(MCP)服务器实现,旨在将 Qdrant 向量数据库无缝集成到支持 MCP 的 ★ 1,540
 chunkhoundchunkhound 是一个本地优先的代码库智能工具,旨在帮助开发者快速理解和检索大型代码库。它通过将代码库分割成语义化的块(chunk),并利用嵌入模型生成向★ 1,441
 aws-genai-llm-chatbot这是一个基于AWS CDK构建的多LLM与多RAG聊天机器人解决方案,旨在帮助企业快速在AWS上部署生产级生成式AI助手。它解决了单一模型或检索方案难以满足多样★ 1,400
 obsidian-Smart2BrainSmart2Brain 是一个 Obsidian 插件,旨在将你的笔记库变成可对话的“第二大脑”。它通过本地或远程 AI 模型(如 Ollama、OpenAI)★ 1,304
 SearchCLISearchCLI 是火山引擎推出的开源命令行工具,帮助开发者把 AI 搜索、推荐与对话式检索能力集成到智能体系统和业务系统中。通过简洁的 CLI 即可接入强大★ 1,188
 fessFess 是一款基于 OpenSearch 构建的开源企业级搜索服务器,支持自托管,可爬取网页、文件、数据库与云端数据源,支持 20 多种语言,提供 REST ★ 1,138
 xiaoyaosearch小遥搜索(XiaoyaoSearch)能听懂你的话、看懂你的图,用 AI 帮你找到本地任何文件,让搜索像聊天一样简单自然。它融合多模态理解与本地检索,是个人文件★ 1,090
 FlashRankFlashRank 是一个轻量级、超快的重排序库,专为搜索和检索管道设计。它解决了在生产环境中部署大型重排序模型时面临的延迟和资源消耗问题,通过优化推理过程,实★ 1,008
 octocodeoctocode 是一个面向 AI 代理的代码研究平台,旨在帮助 AI 代理在代码库和整个 GitHub 上快速找到、理解并验证上下文,同时大幅减少 token★ 945
 codegraph-rustcodegraph-rust 是一个基于 Rust 实现的开源代码图谱与智能分析工具,专注于为 AI 编程代理提供高效的代码上下文管理。它通过 AST 和 Fa★ 885
 stashbasestashbase 是一个本地优先的知识库工具,旨在将本地文件转化为 AI 智能体可搜索的上下文。它通过语义搜索和 RAG 技术,让 AI 助手能快速检索和理解★ 821
 mossmoss 是一个面向生产环境 AI 系统的检索层,主打闪电般的搜索速度(<10ms),且无需依赖向量数据库。它专为浏览器、边缘设备、端侧和云端场景设计,旨在解决★ 790