
pipeline
本站收录 33 个带「pipeline」标签的 AI 开源项目
 kestraKestra 是一个面向关键任务应用的事件驱动编排与调度平台。它解决了复杂工作流中数据管道、任务调度和自动化流程难以统一管理的问题。核心能力包括:基于 YAML★ 28,501
 airbyteAirbyte 是一个开源数据集成平台,专注于 ELT 管道和 AI 应用的数据搬运。它解决的核心问题是:企业数据散落在 API、数据库、文件等数百种来源中,要★ 22,140
 serve基于云原生技术栈构建多模态 AI 应用的框架,让开发者可以像搭积木一样编排微服务化的 AI 流水线。它天然支持文本、图像、音视频等多种模态的模型编排与扩展,配合★ 21,864
 taipy让数据与 AI 算法快速变成生产级 Web 应用的开源框架。开发者只需少量 Python 代码,就能把数据处理、模型推理和可视化界面整合成可交互的应用程序,同时★ 19,439
 great_expectationsGreat Expectations 是一个开源的数据质量工具,帮助数据团队定义、验证和文档化数据的期望。它解决了数据管道中数据质量不可控的问题,通过声明式的期★ 11,851
 AutoRAGAutoRAG 是一个基于 TypeScript 构建的本地智能搜索工具,旨在让 AI 代理能够快速查找你电脑中的任何内容。它通过索引文件、应用数据、浏览器历史★ 5,112
 cube-studiocube-studio 是一个开源的云原生一站式 AI 平台,覆盖机器学习、深度学习和 LLMOps 全链路。它解决了 AI 开发中环境搭建复杂、资源利用率低、★ 5,079
 pipelinespipelines 是 Kubeflow 项目下的机器学习流水线组件,用于在 Kubernetes 上构建、部署和管理端到端的 ML 工作流。它解决了机器学习实★ 4,230
 towheeTowhee 是一个专注于神经数据处理的 Python 框架,旨在让构建和运行 AI 驱动的数据管道变得简单高效。它解决的是从原始数据(文本、图像、音视频等)到★ 3,450
 quant-mindQuantMind 是一个面向量化金融的智能体原生知识抽取与检索框架。它解决的是量化研究过程中信息过载和知识分散的问题,能够从海量研报、财报、新闻等非结构化文本★ 3,032
 cube-studiocube-studio 是一个基于云原生的开源 AI 平台,旨在统一管理机器学习、深度学习及大模型的完整生命周期。它解决企业在算法开发、训练、部署和运维中的碎片★ 2,529
 HuixiangDouHuixiangDou 是一个基于大语言模型(LLM)的技术问答助手,专门解决群聊场景中的技术咨询问题。它针对微信群、飞书群等多人对话环境,通过检索增强生成(R★ 2,501
 instill-coreInstill Core 是一个全栈式 AI 基础设施工具,专注于数据、模型和流水线的编排,旨在简化构建 AI 原生应用的各个环节。它解决了 AI 开发中数据预★ 2,321
 CGraphCGraph 是一个基于 DAG(有向无环图)的通用并行计算框架,使用 C++ 编写,同时提供 Python 绑定。它解决了复杂任务编排和并行调度的问题,让开发★ 2,303
 EmbedAnythingEmbedAnything 是一个基于 Rust 构建的高性能、模块化、内存安全的向量嵌入与索引引擎,专为生产环境设计。它解决了传统 Python 嵌入库在性能★ 1,309
 sematicSematic 是一个开源的机器学习流水线开发平台,旨在解决 ML 工程中实验、调度和部署的复杂性问题。它允许开发者用纯 Python 编写流水线,通过装饰器将★ 1,003
 NeumAINeumAI 是一个专注于大规模向量嵌入创建与同步的框架,旨在解决 RAG(检索增强生成)应用中数据管道复杂、难以维护的痛点。它提供了一套声明式配置,让开发者能★ 869
 lingooseLinGoose 是一个用 Go 语言编写的 AI/LLM 应用开发框架,旨在简化构建基于大语言模型的应用程序。它解决了 Go 生态中缺乏成熟 LLM 工具链的★ 833
 vertex-ai-samplesvertex-ai-samples 是 Google Cloud 官方维护的 Vertex AI 示例集合,包含 Notebooks、代码示例、示例应用等资源,★ 791
 DeepZeroDeepZero 是一个面向 Windows 内核驱动漏洞挖掘的自动化研究框架,核心目标是帮助安全研究人员在无人值守的情况下发现潜在的零日漏洞。它能够批量解析、★ 734
 bkit-claude-codebkit-claude-code 是一个面向 AI 原生开发的插件仓库,核心是结合 PDCA 方法论与 Claude Code 工具链,为开发者提供一套结构化的★ 599
 research-units-pipeline-skillsresearch-units-pipeline-skills 是一套把研究流程拆成「语义执行单元」的开源技能集,面向需要写研究论文、做调研报告或系统性文献分析的★ 510
 bodywork-corebodywork-core 是一个基于 Kubernetes 的机器学习流水线编排与模型部署工具。它旨在解决 ML 工程中从模型训练到线上服务的复杂流程管理问题★ 436
 fondantFondant 是一个面向生产环境的数据处理框架,旨在简化并共享大规模数据流水线的构建。它解决了机器学习项目中数据准备阶段繁琐、重复且难以协作的问题,提供了一套★ 359
 dfserverdfserver 是一个用 Go 语言编写的分布式后端 AI 流水线服务器,专注于图像生成场景。它解决了 Stable Diffusion 等 AI 绘画模型在★ 343
 automlopsautomlops 是一个用于快速构建 MLOps 管道的开源基础设施工具,旨在将机器学习项目的开发到部署流程自动化。它解决了 MLOps 落地过程中常见的工程★ 257
 OpenConstructionEstimate-DDC-CWICR这是一个面向AI代理的开源多语言建筑成本估算数据库,包含超过5.5万个施工项目、2.7万个资源条目,覆盖30个地区。项目旨在解决建筑行业成本估算数据分散、格式不★ 240
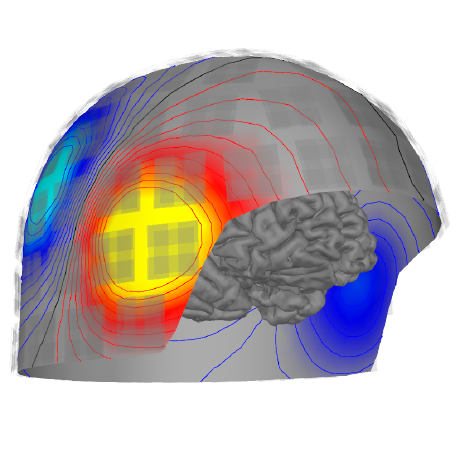 mne-bids-pipelinemne-bids-pipeline 是一个基于 MNE-Python 的自动化神经电生理数据处理流水线,专门针对符合 BIDS 标准的脑电(EEG)、脑磁(ME★ 170
 best-llm-finder-pipeline这是一个用于寻找最佳大语言模型(LLM)的自动化流水线项目,基于Agentic RAG、多智能体系统和视觉推理三种技术路线构建。它解决的是在众多LLM中如何高效★ 143
 monai-deploy-app-sdkMONAI Deploy App SDK 是 MONAI 项目的一部分,专注于医疗影像 AI 应用的全生命周期管理。它提供了一套框架和工具,帮助开发者设计、开发★ 138
 krshkrsh 是一个声明式的 KubeFlow 管理工具,旨在简化 KubeFlow 的部署、配置和生命周期管理。它通过声明式配置(如 YAML)定义所需的 Kub★ 129
 runandread-audiobook这是一个开源项目,旨在让用户在家就能制作高质量的AI配音有声书。它通过整合多种TTS模型(如Zonos、Kokoro-82M)和商业服务(如Deepgram、E★ 63
 papercastpapercast 是一个基于 Python 的管道工具和插件生态系统,用于将技术文档(如 arXiv 论文、SemanticScholar 条目或本地 PDF★ 52