
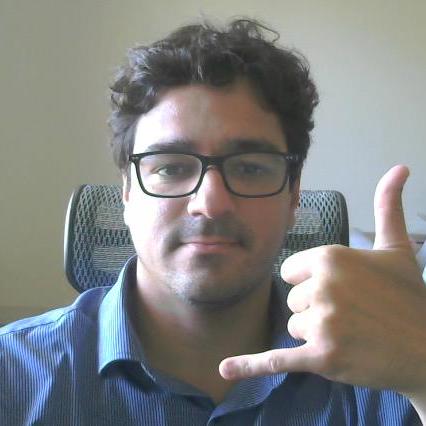
项目预览
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-09-19 · 当前星标 ★ 429
使用教程
环境要求
- Node.js 18+
- Chrome 或 Firefox
安装与启动步骤
-
1拉仓库装依赖
扩展工程与构建脚本在同一仓库。
git clone https://github.com/thiagotigaz/ocr-it.git -
2构建两个版本
一次构建同时产出 Chrome 与 Firefox 两份。
npm install -
3跑构建命令
产物分别落在两个目录里。
npm run build -
4按浏览器加载
Chrome 走开发者模式的加载已解压扩展,Firefox 走临时加载。
如何确认成功
在一个禁止复制的分页文档页面上,能把整篇内容连续抓下来并导出成可读文本,分页之间没有断句
注意事项
- 它解决的是「分页文档没法一次复制」这类具体场景,不做通用网页抓取。
- 识别靠浏览器本地能力,不联网也不调外部 OCR 服务。
- 扫描版图片型 PDF 仍需要真正的 OCR,这个扩展对付不了。
- 只在页面结构常见的站点上稳定,改版后可能失效。
- 抓取内容涉及版权,只用于自己有权访问的材料。
核心亮点
- 框选区域后可用快捷键反复识别,翻页阅读场景下省去重复框选
- Tesseract 与 WASM 全部打包在扩展内,识别完全离线,截图不外传
- 基于 Manifest V3,安装即用,不需要 API Key 或后端服务
不足之处
- Tesseract 对复杂排版、低分辨率或手写体识别准确率有限
- 仅支持 Chrome 系浏览器,无法在 Firefox 或 Safari 使用
适用场景
- 阅读扫描版 PDF 或图片型文档时逐页提取文字
- 在禁止复制的网页或在线课件中快速取词
- 对照纸质书或另一块屏幕上的内容做笔记摘录
替代项目
Tesseract.js、Copyfish、Project Naptha
上一篇:pdf-ocr-obsidian
下一篇:SimdPaddleOCR
同类项目推荐
 Pair-VPR
开源
用视觉Transformer让机器人认路更准,不怕光照季节变化
[IEEE RA-L 2025] The official repository for Pair-VPR: Place-Aware Pre-training and ···
 QMUPD
开源
无需配对数据,自动生成高质量人像线条画
Code for TPAMI "Quality Metric Guided Portrait Line Drawing Generation from Unpaired···
 cvkit
开源
轻量 C++ 工具,快速查看图像与 3D 模型
Computer Vision Toolkit. cvkit is available for Linux as well as for Windows. It off···
 Occular-ocr
开源
俄语文档扫描件一键转文字,快且准
Fast and accurate OCR for Russian documents
 paddleocr-local
开源
本地把 PDF/Office 转 Markdown,五种 OCR 模型随你换
Local-first document parsing workbench for five OCR models: PDF/Office to Markdown w···
 deepdoctection
开源
一行代码搭建文档解析流水线,快速提取版面、表格与文本。
A Repo For Document AI
 RapidOCR
开源
多语言、多引擎的OCR工具集,一行代码搞定文字识别
Awesome OCR multiple programing languages toolkits based on ONNX Runtime, OpenVINO, ···
 snow-apps
开源
一站式搞定截图、录屏和OCR,替代系统自带工具
Snow Apps repository, providing source code for Snow Shot and Snow Image Viewer.
 AliceVision
开源
多张照片一键生成带纹理三维模型
3D Computer Vision Framework