
 MaterialPalette
开源
一张照片,提取材质贴图,直接用于渲染和编辑。
MaterialPalette 是 CVPR 2024 的官方实现,旨在从单张真实世界图像中提取材质属性(包括反照率、法···
汇聚全球AI计算机视觉项目,OCR识别、目标检测、图像分割、人脸识别工具大全。
共收录 447 个开源项目
MaterialPalette
开源
一张照片,提取材质贴图,直接用于渲染和编辑。
MaterialPalette 是 CVPR 2024 的官方实现,旨在从单张真实世界图像中提取材质属性(包括反照率、法···
 SLiMe
开源
一张示例图,让Stable Diffusion学会分割任意目标
SLiMe是一个基于Stable Diffusion的单样本图像分割工具,只需一张标注示例图像即可分割出目标对象,···
 sd-webui-reactor-sfw
开源
在 Stable Diffusion 里一键换脸,安全无 NSFW,快速出图
sd-webui-reactor-sfw 是一个面向 Stable Diffusion WebUI 的快速人脸替换扩展,兼容 A1111、SD.Ne···
 talk2bev
开源
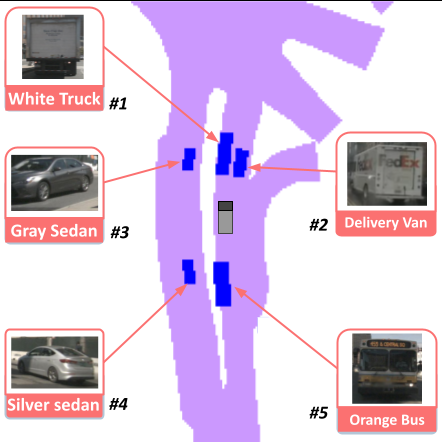
让自动驾驶地图能听懂人话,直接问答周围环境
Talk2BEV 是一个面向自动驾驶场景的语言增强型鸟瞰图(BEV)地图开源项目,发表于 ICRA 2024。它解···
 GraspGPT_public
开源
从图像直接预测机器人抓取姿态,快速复现SOTA抓取模型。
GraspGPT_public 是 GraspGPT 和 FoundationGrasp 模型的官方代码实现,专注于机器人抓取领域。它解···
 GPT4Point
开源
让AI看懂3D点云,听懂人话,直接生成和编辑3D模型。
GPT4Point 是一个面向3D点云与语言统一理解与生成的框架,来自CVPR 2024 Highlight。它解决的是3D点···
 DriveLM
开源
用图问答让自动驾驶学会推理和解释
DriveLM 是一个面向自动驾驶的视觉问答(VQA)基准与数据集,源自 ECCV 2024 Oral 论文。它提出用图···
 RawMangaReader
开源
本地离线识别日文漫画文字,保护隐私免上传
RawMangaReader 是一款面向漫画爱好者的 OCR 桌面应用,主要解决生肉日文漫画阅读时的文字识别与翻···
 LISA
开源
让大模型看懂指令,直接分割出你想要的物体
LISA 是一个基于大型语言模型(LLM)的推理分割(Reasoning Segmentation)项目。它解决的是传统图···
 DZ-FaceDetailer
开源
在 ComfyUI 中一键修复和增强生成图像的人脸细节。
DZ-FaceDetailer 是一个专为 ComfyUI 设计的节点,用于人脸修复、编辑和增强。它利用人脸识别技术,···
 llm_aided_ocr
开源
用 LLM 把扫描 PDF 变成干净 Markdown,识别更准、格式更规整。
llm_aided_ocr 是一个利用大语言模型(LLM)增强 Tesseract OCR 输出的开源工具。它解决传统 OCR 识···
 Awesome-LLMs-for-Video-Understanding
开源
一页看全视频大模型论文代码数据集
这是一个面向视频理解领域的大语言模型(Vid-LLMs)资源汇总仓库,系统整理了最新论文、代码与数据···
 MovieChat
开源
把整部电影装进模型,问啥答啥,长视频理解不再难。
MovieChat 是一个面向长视频理解的开源模型,由 CVPR 2024 论文提出。它解决了现有视频理解模型难以···
 APTM
开源
用自然语言精准找目标人物,多属性提示学习提升检索准确率
APTM 是论文《Towards Unified Text-based Person Retrieval: A Large-scale Multi-Attribute and ···
 STU-Net
开源
14亿参数医学分割大模型,预训练即拿高分
STU-Net 是一个基于大规模预训练的医学图像分割模型,参数量达 14 亿,是目前已知最大的医学分割模···
 universal-medical-image-segmentation
开源
一个模型搞定多种医学图像分割任务
这是一个面向医学图像分割的开源项目,旨在提供统一的医学图像分割解决方案。它解决了医学影像分析···
 Conceptor
开源
读懂扩散模型的隐藏语言,精准操控图像生成
Conceptor 是论文《The Hidden Language of Diffusion Models》的官方实现,旨在揭示并操控 Stable···
 VisCy
开源
显微图像自动提取单细胞特征,省去人工分析
VisCy 是一个面向单细胞表型分析的开源计算机视觉工具库,主要服务于生物图像分析场景。它把深度学···
 gen-cv
开源
用自然语言搞定视觉任务,快速搭建生成式视觉应用
gen-cv 是微软推出的视觉 AI 解决方案加速器,旨在帮助开发者快速构建基于生成式计算机视觉的应用。···
 AL_Yolo
开源
实时检测画面目标并自动跟踪,低延迟响应
AL_Yolo 是一个基于 YOLOv5 的实时计算机视觉系统,专注于低延迟的视觉目标检测与跟踪。它把 YOLOv···
 FasterViT
开源
让视觉 Transformer 又快又准,高分辨率图像处理利器
FasterViT 是一个面向视觉任务的高效 Transformer 模型,由 NVIDIA 研究人员开发,相关论文发表于 ···
 OpenShape_code
开源
让AI看懂任意3D形状,零样本也能分类检索
OpenShape是面向开放世界3D形状理解的表示学习框架,旨在解决传统3D模型在类别覆盖和语义泛化上的局···
 darknet
开源
轻量 C 框架,CPU 也能跑 YOLO 实时检测
Darknet 是一个用 C 和 CUDA 编写的开源神经网络框架,由 Joseph Redmon 创建,最著名的用途是训练···
 ladi-vton
开源
上传衣服和模特图,AI 生成自然逼真的试穿效果
LaDI-VTON 是一个基于潜在扩散模型(Latent Diffusion)的虚拟试穿项目,发表于 ACM MM 2023。它解···