
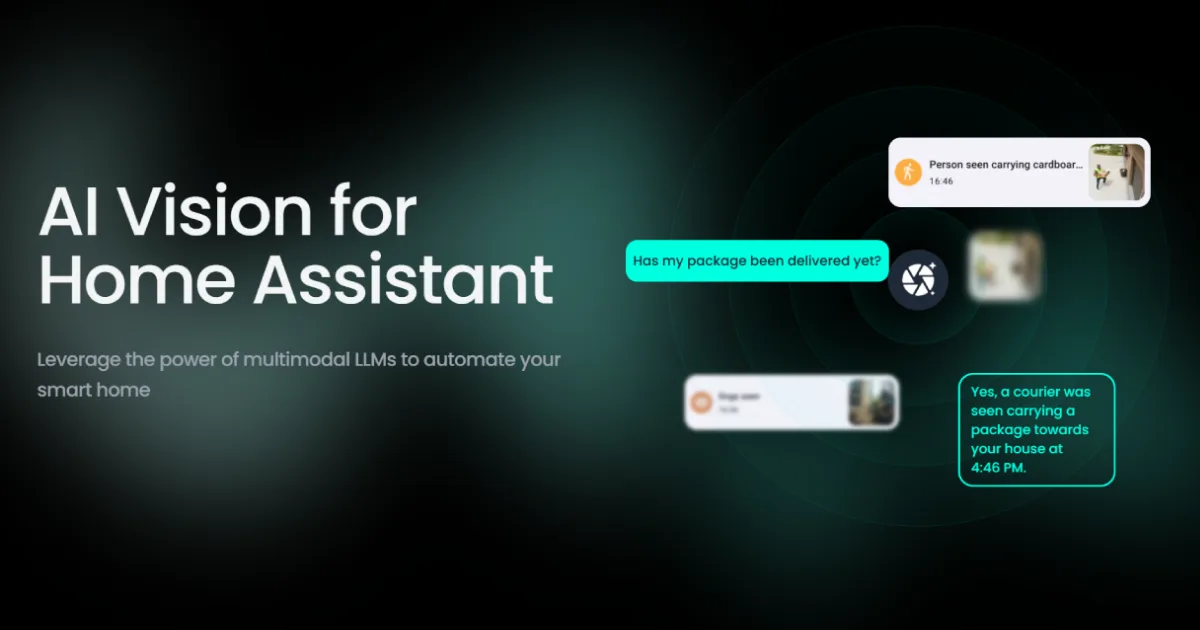
项目预览
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-09 · 当前星标 ★ 1524
技术标签
使用教程
环境要求
- 已安装并可正常运行的 Home Assistant
- 已安装 HACS(LLM Vision 在默认 HACS 仓库中,可直接搜索安装)
- Home Assistant Container 用户需要一个可挂载到容器 /media 的宿主机文件夹
- 一个可用的 AI 提供商账号或本地推理服务(如 OpenAI、Google Gemini、Ollama 等)
安装与启动步骤
-
1在 HACS 中安装
打开 HACS,搜索 LLM Vision 并安装。它已在默认 HACS 仓库中,无需手动添加自定义仓库。
-
2重启 Home Assistant
安装完成后必须重启 Home Assistant,集成才会被加载。在 设置 → 系统 中执行重启。
-
3添加 LLM Vision 集成
进入 设置 → 设备与服务,点击添加集成并搜索 LLM Vision。
-
4提交默认设置
选择 LLM Vision 后直接按提交(submit),先用默认设置完成初步配置。
-
5准备 media 文件夹
LLM Vision 使用更安全的 /media 目录存放快照。若用 Home Assistant Container,需在容器设置里把宿主机目录挂载到 /media,例如加上 -v /your/path:/media。
-
6添加 AI 提供商
回到 LLM Vision 集成页面,点击 Add Entry 添加你的第一个 AI Provider,按官方文档填写对应参数。
关键配置
| 配置项 | 必填 | 说明 | 示例 |
|---|---|---|---|
AI Provider | 是 | 在 LLM Vision 集成页面通过 Add Entry 添加的 AI 提供商 | Ollama |
容器 /media 挂载 | 否 | Home Assistant Container 需把宿主机目录挂载到 /media 以存储快照 | -v /your/path:/media |
如何确认成功
在 设置 → 设备与服务 中能看到 LLM Vision 集成,并且已成功添加至少一个 AI Provider 条目。
常见问题
Q:在 Home Assistant 里搜不到 LLM Vision 怎么办?
A:先确认已通过 HACS 安装该集成并重启了 Home Assistant,然后到 设置 → 设备与服务 → 添加集成 中搜索“LLM Vision”。
Q:支持哪些 AI 提供商?
A:支持 OpenRouter、OpenAI、Anthropic、Google Gemini、AWS Bedrock、Azure、Groq、Ollama、Open WebUI、LocalAI,以及任何提供 OpenAI 兼容接口的服务。
Q:摄像头快照保存在哪里?
A:存放在 /media 文件夹。如果你使用 Home Assistant Container,需要在容器设置中把一个宿主目录挂载到 /media。
Q:安装完成后下一步该做什么?
A:回到 LLM Vision 集成页面,点击 Add Entry 添加第一个 AI Provider,再进行摄像头与提示词配置。
注意事项
- LLM Vision 已收录在默认 HACS 仓库中,可直接在 HACS 内安装,无需手动添加仓库地址。
- 该集成可分析图片、视频文件、实时摄像头流以及 Frigate 事件,并可用 Timeline Card 在仪表盘上展示事件时间线。
- 详细的提供商配置说明见官方文档:https://llm-vision.gitbook.io/getting-started/setup/providers
- 官网:https://llmvision.org
核心亮点
- 支持多种视觉模型(云端+本地),灵活适配不同隐私和成本需求
- 与 Home Assistant 自动化深度集成,可基于视觉结果触发复杂规则
- 配置界面友好,无需编写代码即可快速部署
不足之处
- 依赖摄像头画质和模型精度,复杂场景下误报率可能较高
- 本地推理需要较高硬件配置,入门门槛略高
适用场景
- 家庭安防:检测陌生人或异常行为并推送警报
- 宠物监控:识别宠物活动状态,自动投喂或提醒
- 老人看护:检测跌倒或长时间未活动,及时通知家人
替代项目
Frigate、Double Take、Viseron
上一篇:docstrange
下一篇:Sa2VA
同类项目推荐
 setvae
开源
用层次化VAE生成集合数据,搞定点云等无序结构
[CVPR'21] SetVAE: Learning Hierarchical Composition for Generative Modeling of Set-S···
 eomt
开源
仅编码器搞定图像分割,又快又准
[CVPR 2025 Highlight] Official code and models for Encoder-only Mask Transformer (Eo···
 ISAT_with_segment_anything
开源
点几下就自动抠图,图像分割标注提速数倍
Labeling tool with SAM(segment anything model),supports SAM, SAM2, SAM3, sam-hq, Mob···
 Stable-Diffusion-Seg
开源
用 Stable Diffusion 单步反演,让医学图像分割又快又准
[MICCAI 2024] Codebase for "Stable Diffusion Segmentation for Biomedical Images with···
 trackers
开源
换检测器就能跑的主流多目标跟踪算法合集
Trackers gives you clean, modular re-implementations of leading multi-object trackin···
 OnnxTR
开源
用 ONNX 跑 docTR OCR,不装 PyTorch 也能识别文档文字
OnnxTR a docTR (Document Text Recognition) library Onnx pipeline wrapper - for seaml···
 geti
开源
少数据快训练,轻松搞定计算机视觉模型
Build, train, optimize, and run computer vision models locally, from raw images to l···
 PaddleOCR
开源
把图片和 PDF 变成 AI 能用的结构化文本数据
Turn any PDF or image document into structured data for your AI. A powerful, lightwe···
 Atlantis
开源
用扩散模型给水下图像补深度,无需真实标注也能测距
Atlantis: Enabling Underwater Depth Estimation with Stable Diffusion (CVPR2024, High···