
项目预览
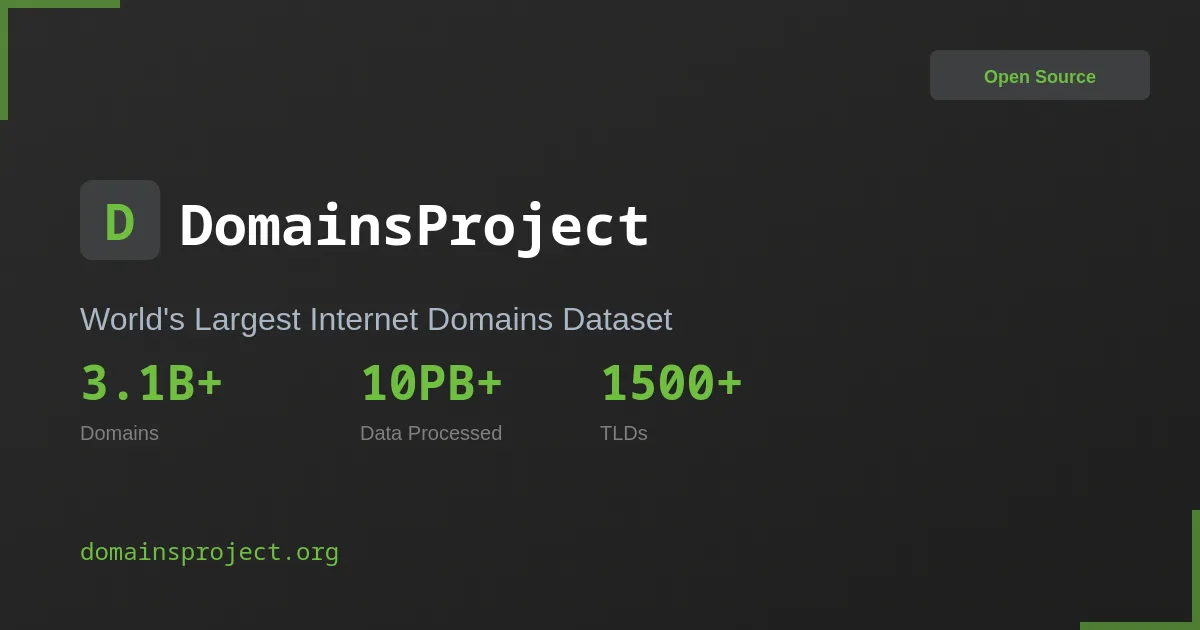
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-11-12 · 当前星标 ★ 1177
技术标签
使用教程
⚠ 该项目 README 未提供完整安装说明,以下步骤为通用流程,请以官方文档为准。
环境要求
- 可访问 GitHub 仓库 https://github.com/tb0hdan/domains 与官网 https://domainsproject.org
- 本地磁盘空间充足(清单规模为十亿级条目)
- 具备查看与处理大体积纯文本文件的基本工具
安装与启动步骤
-
1打开项目仓库
访问 GitHub 仓库页面,浏览根目录里的数据文件与说明文档,先弄清清单的组织方式。
-
2查看数据规模统计
阅读仓库中的 STATS.md 与官网统计页,对比 GitHub 版与订阅版的数据量与覆盖范围。
-
3获取域名清单文件
从仓库中取得已排序的域名列表文件,保存到本地目录备用;文件体积较大,注意磁盘与内存。
-
4了解采集与参与方式
阅读项目博客与 Passive DNS sensor 仓库说明,了解数据的采集来源以及可参与的支持方式。
如何确认成功
仓库文件列表与 STATS.md 能正常打开,并显示十亿级域名条目统计,说明数据可正常获取。
常见问题
Q:需要安装依赖或运行脚本吗?
A:README 未提供安装与运行命令,项目以公开数据清单的形式发布,直接获取清单文件使用即可。
Q:数据量有多大?
A:README 里程碑显示 GitHub 版清单已达 17 亿条,订阅版达 30 亿条,使用前需预留足够磁盘空间。
Q:数据更新频率如何?
A:README 未说明更新周期,可关注仓库提交记录与 STATS.md 的变化来判断数据是否更新。
Q:如何参与或反馈问题?
A:README 建议通过提交 issue 补充缺失的域名数据集,或参与 Passive DNS sensor 等协作项目。
注意事项
- README 仅提供数据集介绍,没有安装与使用命令,动手前请先通读仓库内说明文档
- 域名清单为大体量纯文本,加载与去重时注意内存占用
- 订阅版数据规模更大,获取方式请以官网页面说明为准
核心亮点
- 提供规模领先的全球域名汇总数据,省去从多个来源分别抓取和清洗的重复工作
- 以 Shell 脚本组织采集流程,配合 colly、scrapy 等组件,来源与生成过程相对透明可复现
- 数据集形态便于直接导入数据库或分析流水线,适合做域名统计、资产盘点和测量研究的初始语料
不足之处
- 以脚本采集公开来源为主,数据新鲜度与完整性依赖上游来源,缺少明确的质量校验与更新频率说明
- 数据集类项目缺少配套的查询工具、API 或可视化界面,使用门槛偏向需要自行处理数据的用户
适用场景
- 安全团队做外部攻击面梳理时,用域名清单作为资产发现的初始底表
- 学术机构开展互联网测量、DNS 生态或域名分布研究时作为样本数据
- 数据工程团队构建域名情报库或搜索索引时,用作批量导入的语料来源
替代项目
Tranco、Common Crawl、OpenPageRank
上一篇:dataset-api
下一篇:CubiCasa5k
同类项目推荐
 Koala-36M
开源
用3600万配对视频,让AI生成更听话的视频
Official implementation of the paper "Koala-36M: A Large-scale Video Dataset Improvi···
 Awesome-Data-Efficient-LLM
开源
一份论文清单,帮你快速掌握LLM数据高效利用的核心方法
A list of data-efficient and data-centric LLM (Large Language Model) papers. Our Sur···
 open-data-registry
开源
一键发现并定位 AWS 上的公开数据集
A registry of publicly available datasets on AWS
 OpusFilter
开源
配置式过滤平行语料,快速清洗出高质量句对
OpusFilter - Parallel corpus processing toolkit
 learning-from-rewards-llm-papers
开源
一站式索引LLM奖励学习论文,快速掌握领域脉络
A comrephensive collection of learning from rewards in the post-training and test-ti···
 Chatito
开源
用简单DSL快速生成海量NLP训练数据,告别手工标注。
Dataset generation for AI chatbots, NLP tasks, named entity recognition or text clas···
 awesome-legal-data
开源
法律文本数据集一页汇总,省去全网搜数据时间
A collection of datasets and other resources for legal text processing.
 Awesome-LLM4RS-Papers
开源
一页看懂LLM+推荐系统论文全景,紧跟前沿不迷路
Large Language Model-enhanced Recommender System Papers
 ObjaversePlusPlus
开源
想要高质量3D数据?Objaverse++ 帮你筛选出精品,训练效果更稳。
[ICCV 2025] Repo for Objaverse++, Curated 3D Object Dataset with Quality Annotations