
项目预览
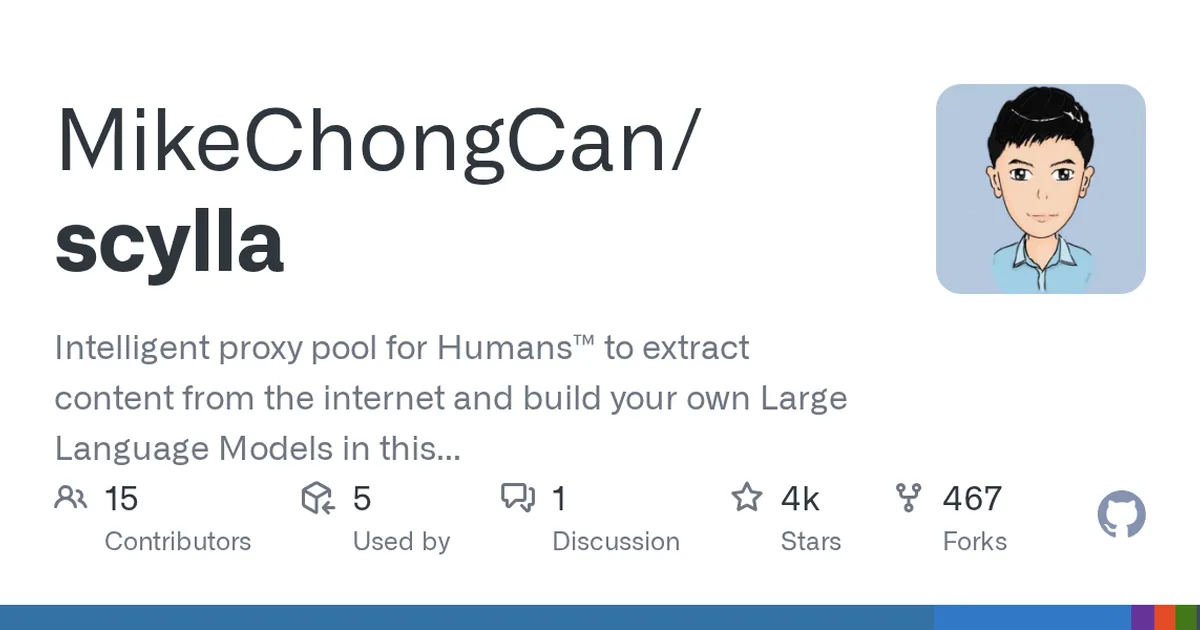
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-11-11 · 当前星标 ★ 4020
使用教程
环境要求
- 已安装 Docker 环境
- 本机 8899 与 8081 端口未被占用
- 首次启动后需等待 1~2 分钟才有代理数据入库
- 如改用 pip 方式,需要本地 Python 环境与 pip
安装与启动步骤
-
1启动 Docker 容器
一条命令即可启动爬虫与 Web 服务,映射 8899 与 8081 两个端口,并把数据目录挂载到宿主机实现持久化。
docker run -d -p 8899:8899 -p 8081:8081 -v /var/www/scylla:/var/www/scylla --name scylla wildcat/scylla:latest -
2确认容器在运行
查看容器列表,确认 scylla 容器状态为 Up;若启动失败可用日志命令排查。
docker ps docker logs scylla -
3调用 JSON API 验证
浏览器或命令行访问代理列表接口,返回 JSON 即表示服务已正常对外提供接口。
curl http://localhost:8899/api/v1/proxies -
4打开 Web 管理界面
访问映射出的 8081 端口,可查看代理分布等可视化页面(以实际端口映射为准)。
-
5备选:pip 方式安装
不想用 Docker 时,可直接用 pip 安装并运行,同一进程同时跑爬虫与 JSON API 服务。
pip install scylla scylla --help scylla -
6备选:源码方式安装
从源码构建需额外安装前端依赖并执行 make assets-build,最后以模块方式启动。
git clone https://github.com/imWildCat/scylla.git
cd scylla
pip install -r requirements.txt
cd frontend
npm install
cd ..
make assets-build
python -m scylla
关键配置
| 配置项 | 必填 | 说明 | 示例 |
|---|---|---|---|
-p 8899:8899 | 是 | JSON API 服务端口映射,示例中通过 8899 访问接口 | 8899:8899 |
-p 8081:8081 | 否 | Web 管理界面端口映射,可按需调整宿主机端口 | 8081:8081 |
-v /var/www/scylla:/var/www/scylla | 否 | 数据目录挂载,用于代理数据持久化,容器重建后不丢失 | /var/www/scylla:/var/www/scylla |
--name scylla | 否 | 为容器指定名称,方便后续查看日志、停止与重启 | scylla |
如何确认成功
执行 curl http://localhost:8899/api/v1/proxies 能返回 JSON 列表,且等待 1~2 分钟后列表中出现可用代理 IP。
常见问题
Q:启动后接口返回空数据怎么办?
A:README 说明首次使用需等待 1~2 分钟,让爬虫抓取并校验代理 IP 入库,稍后重新请求接口即可。
Q:容器启动失败或端口被占用?
A:先用 docker logs scylla 查看报错;若端口冲突,可修改 -p 参数中冒号左侧的宿主机端口后重新运行。
Q:Docker 和 pip 两种方式怎么选?
A:README 推荐使用 Docker,一条命令即可完成部署;已有 Python 环境时也可用 pip 安装后直接运行 scylla。
Q:源码安装时 make assets-build 报错?
A:该步骤需要先进入 frontend 目录执行 npm install 安装前端依赖,并确保系统已具备 make 与 Node.js 环境。
注意事项
- 推荐使用 Docker 方式部署,命令最少、依赖隔离最好;源码方式需要额外的前端构建工具链。
- 数据目录建议挂载到宿主机,避免容器删除后代理数据丢失。
- 首次启动请预留 1~2 分钟等待代理 IP 抓取与校验完成,再判断服务是否正常。
核心亮点
- 代理自动校验与评分排序,失效节点会被定时剔除,减少手工维护成本
- 提供 REST API 和命令行两种使用方式,可直接对接 requests、Scrapy 等常见爬虫框架
- 基于 Python 实现并支持 Docker 部署,配置集中、上手门槛低
不足之处
- 代理来源依赖公开渠道,可用率与稳定性受外部环境影响较大
- 高并发抓取场景下的调度与去重能力有限,缺少分布式多节点协同
适用场景
- 为训练或微调大语言模型批量采集公开网页语料
- 中小规模爬虫任务中轮换出口 IP,降低被目标站点限流的概率
- 对公开数据源做周期性抓取与内容更新
替代项目
proxy_pool、Scrapy
上一篇:Flide
下一篇:Project_Chronos
同类项目推荐
 envd
开源
一条命令搞定可复现开发环境,人和 AI 都能用
️ Reproducible development environment for humans and agents
 eternal
开源
一个平台跑通多种 AI 模型,快速搭建图像生成工作流
Eternal is an experimental platform for machine learning models and workflows.
 Sentinel_Guard
开源
给 AI 应用加一道安全网关,拦截注入与越权调用
Security first LLM gateway and guardrails for AI applications, agents and AI powered···
 tiygate
开源
给 LLM 服务加个高可用保险,自动切换不宕机
TiyGate is a lightweight gateway for highly available LLM services. 一款致力于提供高···
 toolport
开源
一个端口管所有 AI 工具,省 token 又安全
Local-first MCP gateway. Set up MCP servers once and use them in every AI client, wi···
 qaboard
开源
把实验记录整理成册,一键对比调参结果
Quality tracking for people and agents Tests tell you it runs. QA-Board shows you i···
 lilypad
开源
用区块链调度全球闲置 GPU,跑 AI 任务更便宜透明
Run AI workloads easily in a decentralized GPU network. https://www.youtube.com/wat···
 featureform
开源
把已有数据库变成特征存储,无需迁移,快速上线ML特征。
The Virtual Feature Store. Turn your existing data infrastructure into a feature sto···
 LightLLM
开源
轻量部署 LLM,推理快人一步
LightLLM is a Python-based LLM (Large Language Model) inference and serving framewor···