

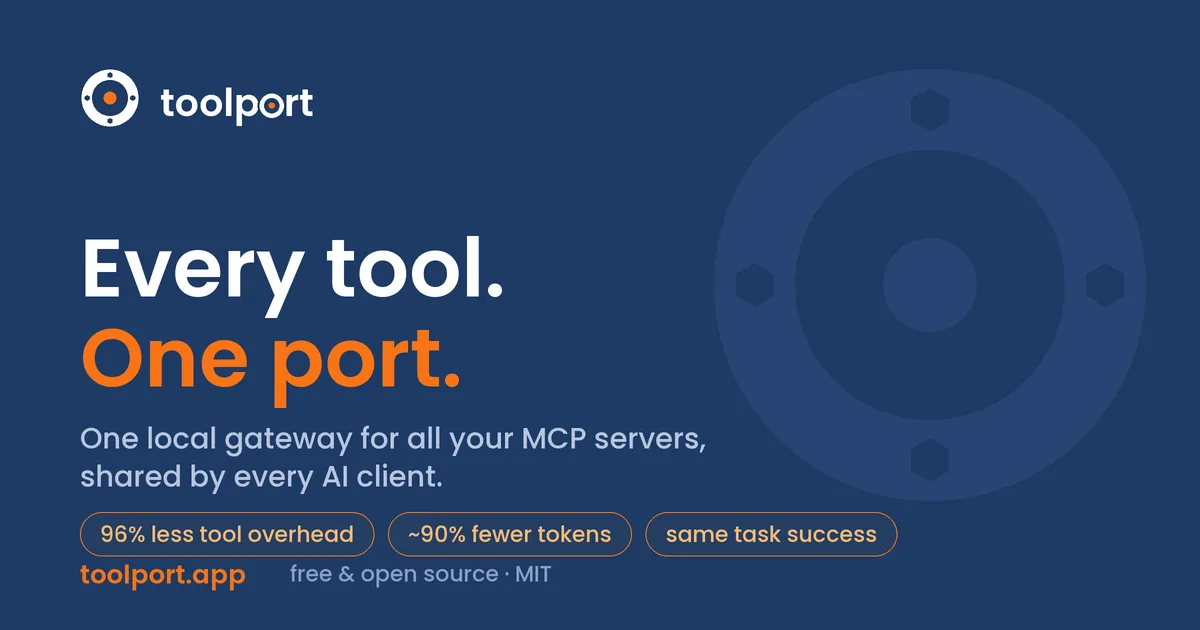
项目预览
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-09 · 当前星标 ★ 238
核心亮点
- 懒加载发现机制大幅减少 token 消耗,实测可节省约 90%
- 工具隔离与完整性校验,防止单个工具异常拖垮整个会话
- 密钥存入系统钥匙串,避免硬编码或明文配置文件
不足之处
- 项目处于早期阶段,文档和社区生态尚待完善
- 仅支持 Rust 技术栈,对非 Rust 开发者有一定上手门槛
适用场景
- 本地开发环境统一管理多个 AI 客户端的 MCP 工具
- 需要高安全性的企业内 AI 工具接入场景
- 对 token 成本敏感的大规模工具调用场景
替代项目
mcp-proxy、mcp-gateway、mcp-router
同类项目推荐
 ODS
开源
一键将电脑变成全能 AI 服务器,本地运行 LLM、语音、图像与自动化。
ODS V3 Pre-Release: Public testing and refinement ahead of the official V3 launch. T···
 M365-Copilot2API
开源
把 M365 Copilot 变成 OpenAI 接口,客户端零改动直接调
Microsoft 365 Copilot → OpenAI / Anthropic 兼容 API 网关。
 sdk
开源
用 Python 轻松在 K8s 上跑 AI 任务,无需懂运维
Universal Python SDK to run AI workloads on Kubernetes
 cache-dit
开源
让大 DiT 模型在有限显存下跑得更快更省
A PyTorch-native inference engine with cache, parallelism, quantization and cpu offl···
 WebAI-to-API
开源
把网页版AI变成API,轻松接入你的应用
Webchat to API
 full-stack-on-prem-cv-mlops
开源
一条命令,从Notebook到百万级CV服务
"1 config, 1 command from Jupyter Notebook to serve Millions of users", Full-stack O···
 vLLM-2080Ti-Definitive
开源
双2080Ti+NVLink跑Qwen 27B,单请求破100 tok/s
The definitive vLLM runtime for dual RTX 2080 Ti 22GB + NVLink, delivering Qwen 27B ···
 emmy
开源
选配方或自调优,让 LLM 推理在 GPU 上跑得更快
Optimized GPU compiler for LLM inference. Choose from a list of optimized recipes or···
 unbody
开源
像用 Supabase 一样,快速搭建 AI 应用的知识后端。
The Supabase of AI era. A modular, open-source backend for building AI-native softwa···