
项目预览
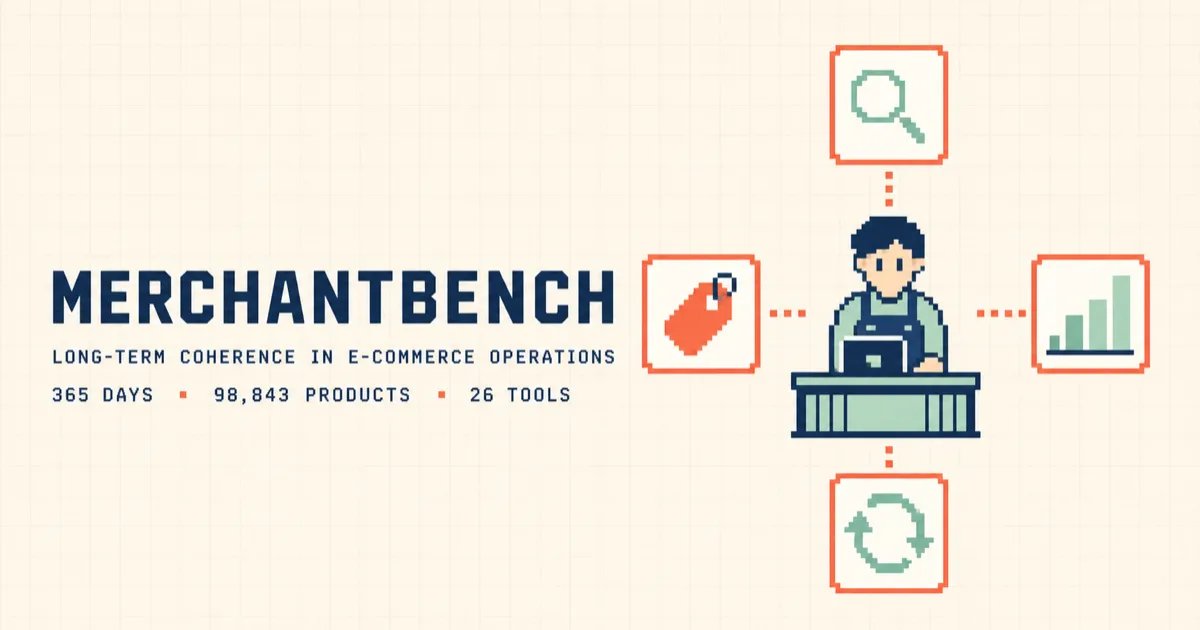
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-11-06 · 当前星标 ★ 172
技术标签
核心亮点
- 以365天、订单粒度构造长程任务,能暴露短程评测看不到的记忆漂移与策略矛盾
- 仿真环境按天推进且可复现,便于横向对比不同智能体的长期连贯性
- 基于Python实现,任务与指标易扩展,适合作为电商运营智能体的研究基准
不足之处
- 项目处于早期,星标与社区规模较小,任务覆盖面和评测结论的外部验证有限
- 仿真环境与真实电商平台存在差距,结论迁移到生产场景需谨慎
适用场景
- 研究LLM智能体长程规划与记忆一致性
- 对比不同智能体在电商卖家运营中的长期决策质量
- 作为电商运营自动化产品的内部回归评测基准
替代项目
AgentBench、WebArena、τ-bench
上一篇:aacr-bench
下一篇:ResolveLab
同类项目推荐
 L1B3RT4S
开源
玩转 AI 提示词,用幽默解锁创意交互
TOTALLY HARMLESS LIBERATION PROMPTS FOR GOOD LIL AI'S!
 awesome-ai-agents-security
开源
一张地图看懂AI代理安全生态,快速找到关键资源
A living map of the AI agent security ecosystem.
 evals
开源
给 AI Agent 做统一考试,改一版测一版
A comprehensive evaluation framework for AI agents and LLM applications.
 langfair
开源
给LLM做公平性体检,防偏见翻车
LangFair is a Python library for conducting use-case level LLM bias and fairness ass···
 watchtower
开源
扫描AI模型漏洞,守护AI供应链安全
AIShield Watchtower: Dive Deep into AI's Secrets! Open-source tool by AIShield for ···
 VibeSearchBench
开源
专治搜索系统'听不懂人话',用200个模糊任务测出真实力
The hardest search benchmark in the wild — vague, multi-turn, proactive. 200 long-h···
 CS-Eval
开源
给网络安全大模型打分,快速找出安全能力短板
CS-Eval is a comprehensive evaluation suite for fundamental cybersecurity models or ···
 LLM-Agent-Benchmark-List
开源
一站式查找 LLM 智能体评估基准,省去全网搜索时间
A banchmark list for evaluation of large language models.
 VLGuard
开源
给视觉大模型加安全锁,几乎零成本防恶意图片诱导
[ICML 2024] Safety Fine-Tuning at (Almost) No Cost: A Baseline for Vision Large Lang···