

项目预览
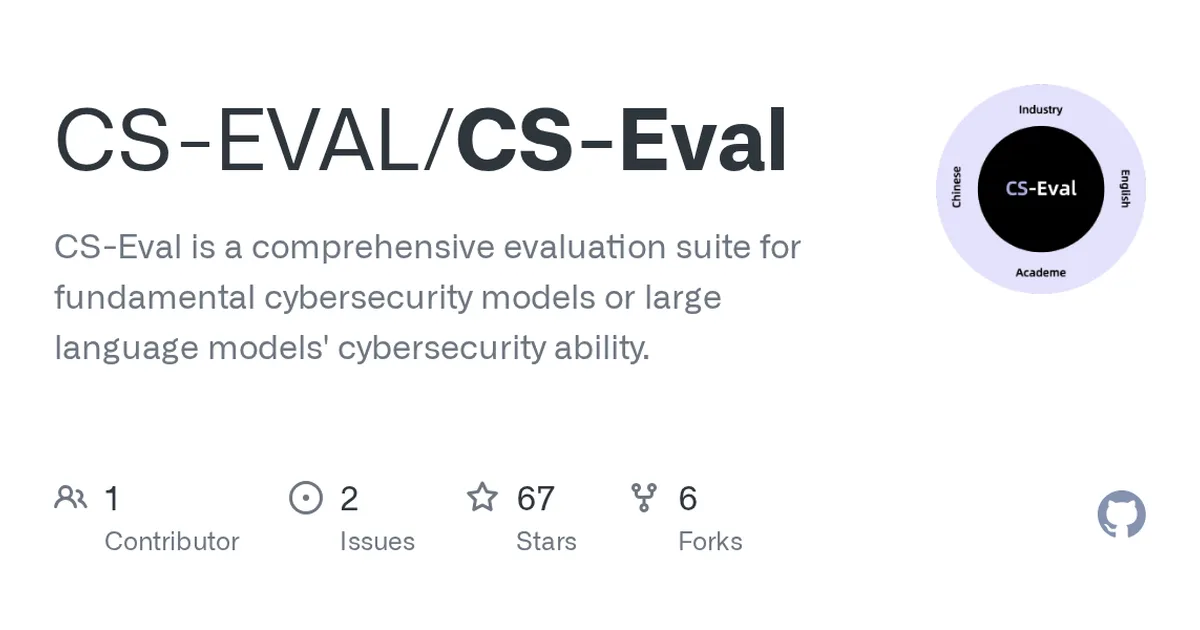
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-09 · 当前星标 ★ 68
核心亮点
- 专注网络安全垂直领域,评测维度更贴近实战场景
- 提供标准化测试集和自动化评分,支持模型间横向对比
- 框架可扩展,允许自定义测试用例和任务类型
不足之处
- 项目处于早期,测试集覆盖度和成熟度有限
- 文档和社区支持尚不完善,上手门槛可能偏高
适用场景
- 安全团队评估自研或开源大模型的网络防御能力
- 研究者对比不同模型在漏洞检测、恶意代码识别等任务上的表现
- 企业选型时筛选具备安全能力的AI模型
替代项目
CyberBench、SecurityEval、SafeRLHF
上一篇:BrainBench
下一篇:MixEval
同类项目推荐
 evals-skills
开源
让编码代理手把手帮你搭产品专属 AI 评测
Skills that guide AI coding agents to help you build product-specific AI evals.
 Awesome-LLM-Quantization
开源
一页看清大模型量化方法与工具
Awesome list for LLM quantization
 Awesome-Trustworthy-AudioLLMs
开源
音频大模型可信性论文一站查,快速建立研究地图
A reading list for trustworthy audio large language models.
 Awesome-LLM-Red-Teaming
开源
一站式收集 LLM 红队测试资源,快速上手安全攻防
A curated list of awesome LLM Red Teaming training, resources, and tools.
 ai-jailbreaks
开源
现成越狱提示词库,快速测模型安全边界
AI jailbreaks: 35 paste-ready AI jailbreak prompts for 25+ frontier and open-weight ···
 Awesome-Evaluation-of-Visual-Gen···
开源
一页看懂视觉生成模型怎么评测,省去翻论文的麻烦
A list of works on evaluation of visual generation models, including evaluation metr···
 auto_eval
开源
让机器人策略评估全自动,省时省力又客观
AutoEval: Autonomous Evaluation of Generalist Robot Manipulation Policies in the Rea···
 guardrails
开源
给大模型输出装上安全阀,让生产更可靠
Adding guardrails to large language models.
 alpaca_eval
开源
自动评估指令跟随模型,快、便宜、且靠谱。
An automatic evaluator for instruction-following language models. Human-validated, h···