
项目预览
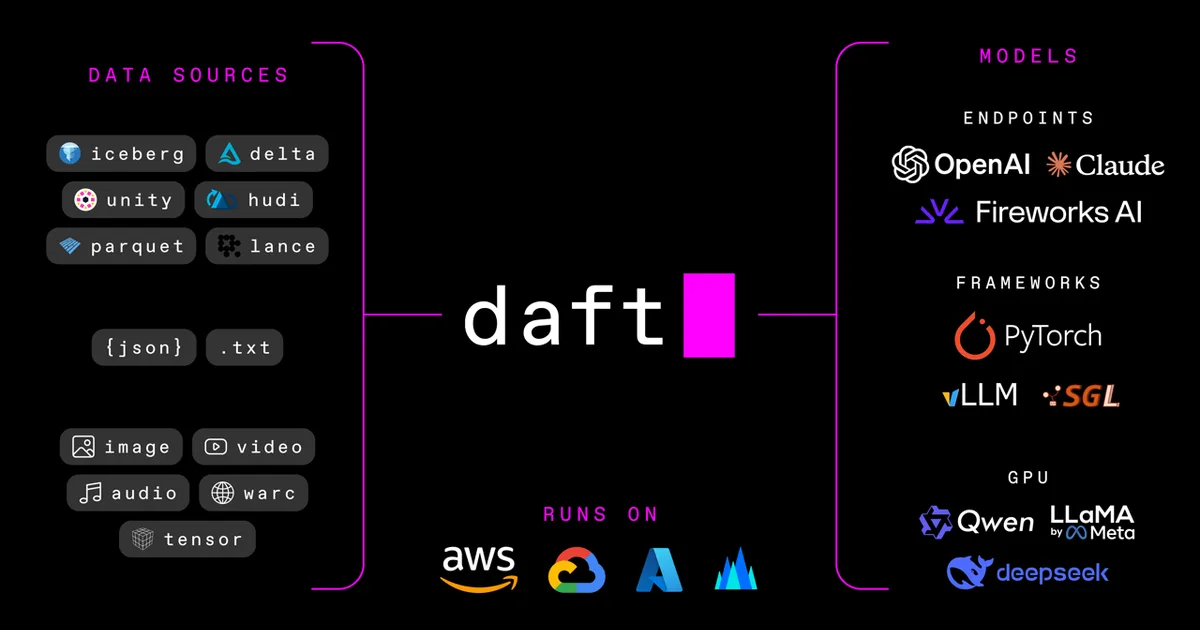
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-11-01 · 当前星标 ★ 5819
使用教程
⚠ 本教程由 AI 依据该项目 README 整理;原始文档不完整,部分步骤为通用流程推断,实际安装请以项目官方文档为准。
⚠ 该项目 README 未提供完整安装说明,以下步骤为通用流程,请以官方文档为准。
环境要求
- Python 环境与 pip(具体版本要求以官方安装文档为准)
- 无需 JVM:Python 接口加 Rust 底层
- 分布式执行按需接入 Ray 或 Kubernetes,可选
- 访问 S3、GCS、Iceberg、Delta Lake 等数据源时需准备对应凭据
安装与启动步骤
-
1确认 Python 环境
README 通过 PyPI 分发 Python 包,先确认本机 Python 与 pip 可用;具体要求以官方安装页为准。
python --version -
2创建虚拟环境
建议在独立虚拟环境中安装,避免与其他 Python 项目依赖冲突。
python -m venv .venv source .venv/bin/activate -
3安装 Daft
从 PyPI 安装名为 daft 的包;README 节选未给出完整安装命令,请同步核对官方安装文档。
pip install daft -
4验证安装
导入库并打印版本号,能正常输出版本即表示安装完成。
python -c "import daft; print(daft.__version__)" -
5阅读快速上手
按官方 Quickstart 了解惰性 DataFrame 接口与多模态列的基本用法,再写业务代码。
-
6按需配置分布式
单机够用可跳过;需要扩展时按官方文档接入 Ray 或 Kubernetes 集群执行。
如何确认成功
执行 python -c "import daft; print(daft.__version__)" 能正常输出版本号,就表示安装成功。
常见问题
Q:需要安装 Java 或 JVM 吗?
A:不需要。README 说明 Daft 以 Python 为核心、Rust 为底层,无需 JVM 环境。
Q:数据量变大后怎么扩展?
A:README 支持从本地起步扩展到分布式集群,可通过 Ray 或 Kubernetes 方式部署,具体步骤见官方分布式文档。
Q:安装命令或版本与文档不一致怎么办?
A:README 节选未给出具体版本号,请以官方 Installation 页面和 PyPI 页面显示的包名、版本为准。
Q:如何读取对象存储里的数据?
A:README 列出支持 S3、GCS、Iceberg、Delta Lake、Hugging Face 等数据源,凭据与参数配置请查阅官方文档。
注意事项
- README 节选只给出官网、文档与安装页链接,未包含完整安装命令,执行前请核对官方安装文档。
- 分布式能力(Ray、Kubernetes)属于可选项,本地单机即可开始使用。
- 包版本与 Python 版本兼容性以官方 Installation 页面与 PyPI 页面为准。
核心亮点
- 基于 Rust 与 Arrow 实现,列式内存布局和向量化执行带来较高吞吐
- 原生支持图像、音频、视频等非结构化列类型,减少多系统拼接
- 提供分布式执行与惰性求值,兼顾单机开发与集群扩展
不足之处
- 项目仍处成长阶段,API 与生态成熟度不及老牌 DataFrame 引擎
- 多模态算子与分布式调优的文档和最佳实践仍在完善中
适用场景
- 构建多模态训练数据集,批量解码与预处理图像、音频、视频
- 对大规模结构化数据做清洗、转换与特征工程
- 在分布式集群上运行统一的 AI 数据流水线
替代项目
Polars、Apache Spark、Ray Data
上一篇:hyperspace-db
下一篇:foxglove-sdk
同类项目推荐
 openeverest
开源
在 K8s 上一键自动创建和管理多种数据库
OpenEverest is an open-source platform for automated database, storage and LLMs prov···
 haupt
开源
为 Polyaxon 提供元数据与工件流管理底座
Lineage metadata API, artifacts streams, sandbox, API, and spaces for Polyaxon
 mlstacks
开源
一行配置,云端一键拉起完整 MLOps 平台
A series of Terraform based recipes to provision popular MLOps stacks on the cloud.
 pai
开源
管好 GPU 集群,让 AI 训练快人一步
Resource scheduling and cluster management for AI
 wirken
开源
给企业智能体装上安全闸门,身份、审计、隔离一步到位
The enterprise gateway for autonomous agents. Identity management, per-channel isola···
 LLaMA_MPS
开源
在 Mac 上让 LLaMA 跑得更快,用上 GPU 加速推理。
Run LLaMA (and Stanford-Alpaca) inference on Apple Silicon GPUs.
 kronotop
开源
用 FoundationDB 撑起的强一致文档库,还带 AI 记忆检索
Distributed, transactional document database backed by FoundationDB.
 kite
开源
一个界面管多集群,AI 帮你运维 K8s
A lightweight, modern Kubernetes dashboard. All your clusters. One workspace.
 openai-compatible-api-migration-···
开源
换 AI 网关不翻车,示例+回滚+清单一次给齐
OpenAI-compatible API migration kit: drop-in /v1/images/generations and chat example···