
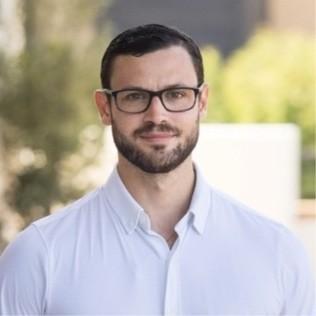
项目预览
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-10-31 · 当前星标 ★ 132
核心亮点
- 同时提供 Sigma、YARA、Suricata 三种格式,可对接 SIEM、EDR、NDR 等主流安全平台
- 覆盖 LLM 应用、MCP 服务器、ML 供应链、RAG/向量库等较新的攻击面,填补传统规则库空白
- 厂商中立,规则以文本形式组织,便于按自身环境裁剪和二次开发
不足之处
- 项目处于早期,规则数量与覆盖面仍在积累,部分场景可能只有少量规则
- 缺少配套的规则部署说明与误报调优指南,落地需要一定检测工程经验
适用场景
- 安全团队为自建 LLM 应用和 MCP 服务搭建检测告警基线
- DFIR 分析师在 AI 系统入侵事件中快速套用现成规则进行排查
- 企业将规则导入现有 SIEM/EDR,补齐 AI 基础设施的监控盲区
替代项目
SigmaHQ/sigma、Neo23x0/signature-base、elastic/detection-rules
上一篇:Jailbreaks-GPT-Gemini-deepseek-
下一篇:crust
同类项目推荐
 python-sdk
开源
官方 Python 客户端,几行代码接入标准化 AI 评测
The official Python SDK for Eval Protocol
 trulens
开源
给LLM应用装上仪表盘,量化评估效果,快速定位问题。
Evaluation and Tracking for LLM Experiments and AI Agents
 Spiritual-Spell-Red-Teaming
开源
用现成越狱提示快速测出大模型安全漏洞
A repo for jailbreaking various LLMs, mainly Claude
 OpenRT
开源
一键对多模态大模型发起42+攻击,快速暴露安全漏洞
Open-source red teaming framework for MLLMs with 42+ attack methods
 secure-ai-tooling
开源
给AI系统做安全体检,用统一框架识别和缓解风险
The CoSAI Risk Map is a framework for identifying, analyzing, and mitigating securit···
 M3Exam
开源
全球大模型谁更聪明?多语言考卷测出真实力
Data and code for paper "M3Exam: A Multilingual, Multimodal, Multilevel Benchmark fo···
 AgentBench
开源
一套基准测出 LLM 当智能体到底行不行
A Comprehensive Benchmark to Evaluate LLMs as Agents (ICLR'24)
 auto_LiRPA
开源
给神经网络算严格上下界,验证对抗鲁棒性
auto_LiRPA: An Automatic Linear Relaxation based Perturbation Analysis Library for N···
 AssetOpsBench
开源
工业设备运维智能体,一套基准直接评测落地
AssetOpsBench - Industry 4.0: A unified benchmark and framework for building, orches···