

项目预览
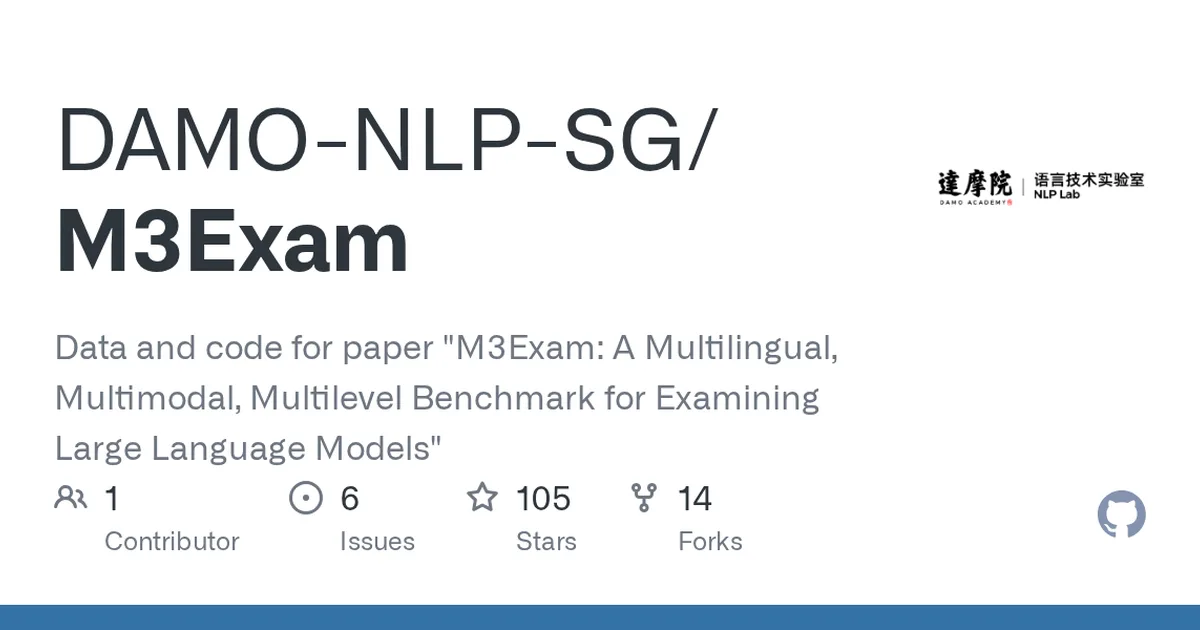
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-09 · 当前星标 ★ 105
核心亮点
- 首个多语言、多模态、多级别的LLM评估基准,覆盖9种语言和3种教育阶段,数据规模大且真实(小学至高中题目)
- 代码与数据完整开源,支持自定义评估流程,便于复现论文结果
- 提供GPT-4等主流模型的评测结果,为后续研究提供直接对比基线
不足之处
- 项目较早期,文档和社区支持待观察
- 评估数据可能受限于教育体系差异,跨文化适用性需进一步验证
适用场景
- 多语言LLM能力横向对比评测
- 教育领域AI辅助教学效果验证
- 多模态模型在真实考试场景中的鲁棒性测试
替代项目
MMLU、C-Eval、M3G
下一篇:agentic_security
同类项目推荐
 Deco
开源
让多模态模型少说瞎话,动态纠错解码即插即用
[ICLR 2025] MLLM can see? Dynamic Correction Decoding for Hallucination Mitigation
 Awesome-Machine-Generated-Text
开源
一站式找全大模型生成文本的检测与分析资源
Continuously updated list of related resources for generative LLMs like GPT and thei···
 ai-eval-platform
开源
一站式评测 AI 应用,让质量看得见
开源 AI 应用评测平台,支持 RAG、AI Agent、多轮对话、LLM-as-Judge、接口评测、评测报告···
 every_eval_ever
开源
把散落各处的 AI 评测结果统一成可比较的公共数据库
Every Eval Ever is a shared schema and crowdsourced eval database. It defines a stan···
 SemBench
开源
给语义查询引擎跑分,选型不再靠猜
Benchmarking Semantic Query Processing Engines
 CL4R1T4S
开源
看穿AI底牌,一键获取各大模型系统提示词
LEAKED SYSTEM PROMPTS FOR CHATGPT, CLAUDE, GEMINI, GROK, PERPLEXITY, CURSOR, LOVABLE···
 LooGLE
开源
测长文本模型真实力,看它能否抓住长文关键
ACL 2024 | LooGLE: Long Context Evaluation for Long-Context Language Models
 AssetOpsBench
开源
工业设备运维智能体,一套基准直接评测落地
AssetOpsBench - Industry 4.0: A unified benchmark and framework for building, orches···
 model-community
开源
安全模型开箱即用,Notebook 跑通内容审核评测
Making open safety AI models accessible and beneficial to the safety community