
项目预览
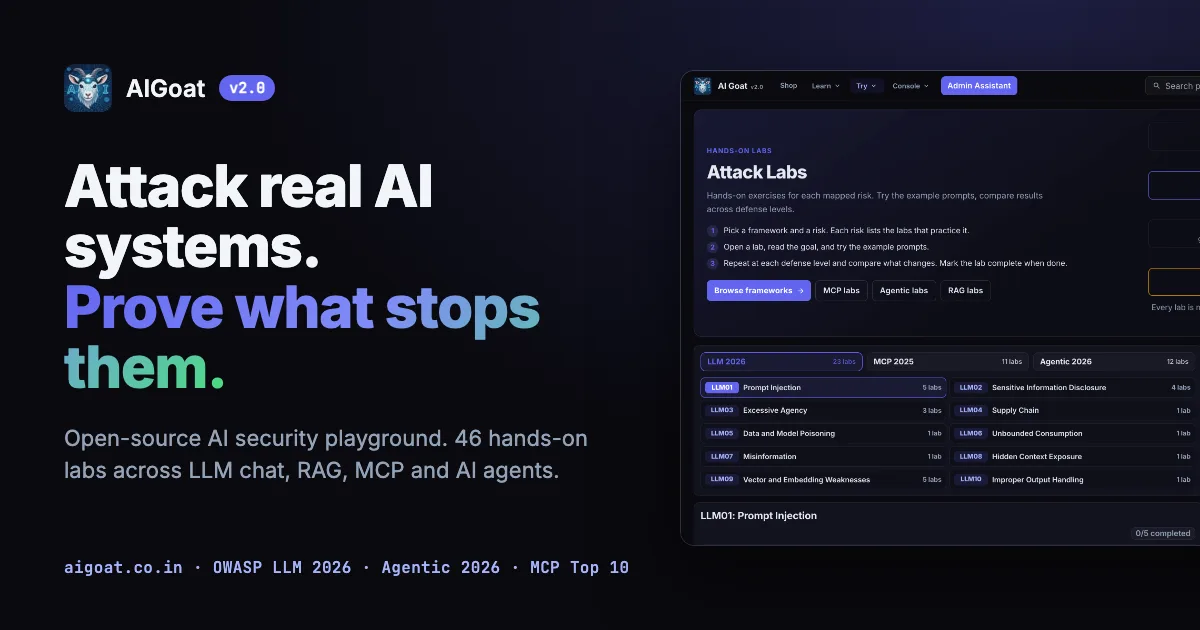
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-11-08 · 当前星标 ★ 271
核心亮点
- 覆盖提示词注入、RAG 投毒、Agent 与 MCP 安全等主流 LLM 风险,主题成体系
- 提供攻击实验加 CTF 挑战加渐进防御三层结构,学习路径清晰可复现
- 全部本地运行,练习环境可控,适合教学与团队内部演练
不足之处
- 项目处于早期,关卡数量与文档完善度仍在迭代
- 社区规模较小,遇到问题可参考的讨论和案例有限
适用场景
- 安全工程师练习 LLM 红队攻击手法
- AI 应用开发者上线前做安全自查演练
- 高校或企业开展 AI 安全课程与内部培训
替代项目
Garak、PyRIT、promptfoo
下一篇:没有了!
同类项目推荐
 clean-fid
开源
让 FID 分数更可信,生成模型评估不踩坑
PyTorch - FID calculation with proper image resizing and quantization steps [CVPR 20···
 agentic_security
开源
给大模型应用做安全体检,自动发现漏洞并生成报告
Agentic LLM Vulnerability Scanner / AI red teaming kit
 Data-Preparation-Bench
开源
用下游效果给训练数据质量打分
A unified, downstream-grounded benchmark for LLM-driven training data construction, ···
 InfiniteBench
开源
测出大模型在10万字长文本下的真实水平
Codes for the paper "∞Bench: Extending Long Context Evaluation Beyond 100K Tokens":···
 crust
开源
给 AI Agent 装上行为拦截闸,危险操作发生前就挡住
Open Source AI Agent Security Infrastructure — intercepts and blocks dangerous agen···
 future-agi
开源
一站式评估、观测和优化你的 AI 智能体,提升可靠性和安全性。
Open-source, end-to-end platform for evaluating, observing, and improving LLM and AI···
 inspect_ai
开源
统一跑大模型评测,结果可复现可回放
Inspect: A framework for large language model evaluations
 awesome-cybersecurity-agentic-ai
开源
一页清单,快速找到能落地的安全智能体方案
 KnowledgeEditingPapers
开源
一榜在手,快速掌握大模型知识编辑前沿论文
Must-read Papers on Knowledge Editing for Large Language Models.