
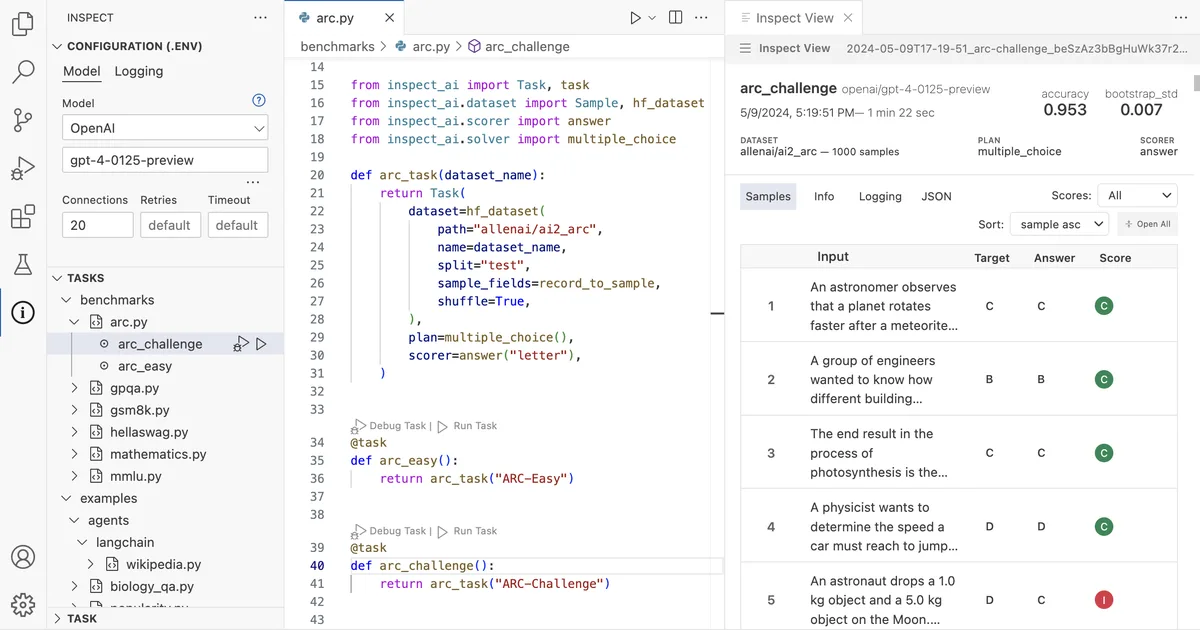
项目预览
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-09-15 · 当前星标 ★ 3156
使用教程
环境要求
- Python 环境(README 未指定具体版本)
- pip,用于安装依赖包
- git,用于克隆仓库
- 可选:uv,README 提到可用它同步开发环境
安装与启动步骤
-
1克隆仓库
从 GitHub 拉取 Inspect 源码到本地,README 给出的官方仓库地址如下。
git clone https://github.com/UKGovernmentBEIS/inspect_ai.git -
2进入项目目录
切换到刚克隆下来的 inspect_ai 目录,后续安装命令都在此目录执行。
cd inspect_ai -
3安装开发依赖
用 -e 可编辑模式安装,并附带 [dev] 可选依赖;引号要保留,避免被 shell 解析。
pip install -e ".[dev]" -
4阅读官方文档
README 未给出更多安装细节,入门用法请直接查阅官网文档首页。
-
5挑选预置评测
Inspect 内置 200 多个可直接运行的评测任务,可先浏览评测目录再决定跑哪个。
如何确认成功
安装过程无报错即完成开发环境搭建;随后按官方文档 https://inspect.aisi.org.uk/ 的指引运行评测,确认可正常调用。
常见问题
Q:应该用 pip 还是 uv 安装?
A:README 给出的方式是 pip install -e ".[dev]";同时提到如果使用 uv,也可以用它同步开发环境。两者择一即可,uv 部分说明在 README 中被截断。
Q:有现成的评测可以直接跑吗?
A:有。Inspect 提供 200 多个预置评测,可运行在任意模型上,详情见 https://inspect.aisi.org.uk/evals/。
Q:文档在哪里看?
A:官网 https://inspect.aisi.org.uk/。另提供结构化索引 llms.txt、合并版用户指南 llms-guide.txt 和含 API/CLI 的 llms-full.txt。
Q:为什么安装命令要加 -e 和 [dev]?
A:-e 是可在本地直接改代码生效的可编辑安装,[dev] 会额外装上开发所需的可选依赖,适合参与框架开发。
注意事项
- README 展示的是开发者安装流程,普通用户使用方式请以官方文档为准。
- 命令中的 ".[dev]" 建议保留双引号,防止 shell 把方括号当通配符处理。
- 官方文档页面在 .html 路径后追加 .md 即可获得 Markdown 版本,例如 /extensions/index.html.md。
- 扩展 Inspect 的组件(如新的提问与评分方式)以独立 Python 包形式提供。
核心亮点
- Task/Solver/Scorer 三层抽象清晰,评测流程可组合复用,不是一次性脚本
- 自带日志查看器,能回放每次对话与工具调用轨迹,方便定位模型失败原因
- 由英国 AI 安全研究所主导,安全评测与红队场景支持较完整,支持沙箱执行
不足之处
- 生态与文档仍在成长期,第三方模型和数据集适配需要自己动手的部分较多
- 偏重评测流程编排,开箱即用的现成基准集合不如部分老牌评测库丰富
适用场景
- 团队搭建可复现的大模型能力基准,横向对比多个模型版本
- 安全团队对大模型做红队测试,记录并回放危险输出与工具调用
- 研究者把自定义数据集和评分逻辑接入统一框架,产出可审计的评测报告
替代项目
lm-evaluation-harness、promptfoo、OpenAI Evals
同类项目推荐
 defenseclaw
开源
给自主 AI Agent 套上可审计的安全护栏
Security Governance for Agentic AI
 empirica
开源
给 AI 装上可靠性仪表盘,让每次输出可测量、可拦截、可信赖。
Make AI agents and AI workflows measurably reliable. Epistemic measurement, Noetic R···
 agentdojo
开源
搭建 LLM 智能体攻防演练场,量化安全风险
A Dynamic Environment to Evaluate Attacks and Defenses for LLM Agents.
 XSafeClaw
开源
给 AI 智能体装上安全盾,自动红队测试找漏洞
Introducing XSafeClaw: The Open-Source Agent Safety Platform from Fudan University
 geobench
开源
用 GeoGuessr 游戏场景,测出 AI 的地理定位智商。
GeoGuessr benchmark for language models
 halo-record
开源
给 AI 代理装上防篡改黑匣子,操作记录人人可验
Tamper-evident audit trails for AI agents: hash-chained Runtime Records, dependency-···
 auto_LiRPA
开源
给神经网络算严格上下界,验证对抗鲁棒性
auto_LiRPA: An Automatic Linear Relaxation based Perturbation Analysis Library for N···
 AgentBench
开源
一套基准测出 LLM 当智能体到底行不行
A Comprehensive Benchmark to Evaluate LLMs as Agents (ICLR'24)
 HallusionBench
开源
测出多模态模型的视觉幻觉,看清谁在瞎猜
[CVPR'24] HallusionBench: You See What You Think? Or You Think What You See? An Imag···