

项目预览
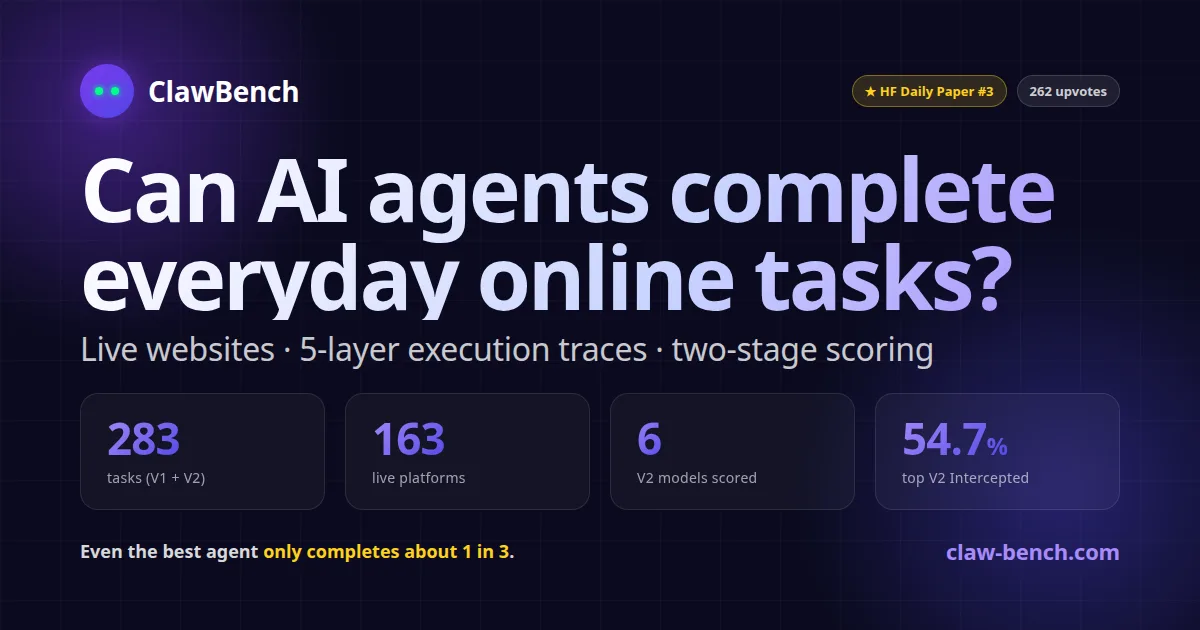
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-09 · 当前星标 ★ 1243
使用教程
环境要求
- Python 3.11 及以上
- uv 包管理器(docs.astral.sh/uv)
- 容器引擎:Docker 或 Podman(ClawBench 自动检测,可用 CONTAINER_ENGINE 强制指定)
- 可在 models/models.yaml 中配置的模型 API Key(如 Claude、DeepSeek 等)
安装与启动步骤
-
1准备运行环境
先安装 Python 3.11+、uv 与容器引擎之一。macOS 可装 Docker Desktop,Linux 用 apt 安装 docker.io 并把当前用户加入 docker 组。
brew install --cask docker -
2克隆并一键启动
从源码克隆仓库后执行根目录的 run.sh,会完成克隆→配置→运行流程,Docker 隔离 harness。
git clone https://github.com/TIGER-AI-Lab/ClawBench.git && cd ClawBench && ./run.sh -
3安装 CLI(可选)
只想跑评测、不改驱动时用 uv 安装发布包,会得到 clawbench 系列命令;pipx / pip 安装同样可行。
uv tool install clawbench-eval -
4配置模型密钥
复制示例配置为 models/models.yaml,然后编辑文件填入你的模型名称与 API Key,这是后续 --models 参数能引用的键。
cp models/models.example.yaml models/models.yaml -
5运行第一个任务
交互式 TUI 会引导选择模型与测试用例(需交互终端);也可直接指定用例与模型跑单个任务,启动后会打印 noVNC 地址。
clawbench uv run clawbench-run test-cases/v1/001-daily-life-food-uber-eats claude-sonnet-4-6 -
6批量跑测试集
用 --models 指定 models.yaml 中配置的模型键,--cases-suite v2 跑完整 V2 集(v1-lite 为 20 条子集),--no-judge 可跳过评分。
clawbench-batch --models your-model --cases-suite v2 --all-cases -
7分析评测结果
对已完成的批量运行目录生成 Markdown 报告,包含 Stage-1/Stage-2 通过率、失败分类与各分类结果。
clawbench-analyze --runs-dir test-output/batch-<timestamp> --out report.md
关键配置
| 配置项 | 必填 | 说明 | 示例 |
|---|---|---|---|
models/models.yaml 中的模型 API Key | 是 | 配置被测模型与裁判模型(judge)的密钥和名称 | sk-xxxxxxxx |
CONTAINER_ENGINE | 否 | 强制指定容器引擎为 docker 或 podman,不设置则自动检测 | docker |
--judge-model | 否 | 批量评测时指定裁判模型,默认使用 deepseek-v4-pro | deepseek-v4-pro |
--max-concurrent | 否 | 并行任务数,本地默认 2,Kernel/Browserbase 默认 1 | 2 |
如何确认成功
运行单任务后终端会打印 noVNC 地址(如 http://localhost:6080/vnc.html),打开即可实时观看智能体操作,结果写入 ./test-output/。
常见问题
Q:8080/6080 端口被占用怎么办?
A:无需处理。ClawBench 检测到端口被占用时会自动选择替代端口,按终端打印的 noVNC URL 访问即可。
Q:在 CI 或管道中运行报错?
A:交互式 TUI(clawbench)需要真实终端,非 TTY 环境请改用 clawbench-run 或 clawbench-batch 直接运行。
Q:如何跳过评测打分?
A:在 clawbench-batch 后加 --no-judge,只跑任务不做裁判打分,节省模型开销。
Q:不想用本地容器浏览器怎么办?
A:可改用托管远程浏览器 Kernel 或 Browserbase,配置方式见仓库 docs/browser-runtimes.md。
Q:如何复现官方榜单结果?
A:用 clawbench-reproduce --model <模型名> --tolerance 2.0 一条命令复现,或下载公开 trace 后用 clawbench-rescore 只重跑裁判。
注意事项
- 首次运行前务必先编辑 models/models.yaml 填入模型 API Key,否则无法选用模型。
- 使用 sudo docker 时容器提取的文件在宿主机上属主为 root,驱动会在每次运行后自动把 test-output/ chown 回当前用户;也可改用 rootless Podman/Docker 彻底避免。
- 单次运行的完整五层记录(录屏、截图、浏览器动作、HTTP 请求、智能体消息)保存在 ./test-output/<model>/<harness>-<case>-<model>-<timestamp>/ 下。
- 修改驱动、内置测试用例或容器构建时,应克隆仓库并使用根目录 uv 包入口,而不是 PyPI 安装包。
核心亮点
- 聚焦真实日常任务,评测结果贴近实际使用价值
- 支持多智能体框架接入,便于横向对比
- 任务场景可扩展,社区可贡献新用例
不足之处
- 早期项目,测试任务覆盖范围有限
- 文档/社区待观察
适用场景
- 浏览器AI智能体开发者的性能评测与调优
- 对比不同智能体框架的日常任务完成能力
- 学术研究中的智能体能力基准测试
替代项目
WebArena、Mind2Web、GAIA
下一篇:halo-record
同类项目推荐
 watchtower
开源
用 LLM 编排本地网站渗透测试,自动出报告
Watchtower - AI-powered penetration testing automation CLI tool that leverages LLMs ···
 common_metrics_on_video_quality
开源
一键计算视频生成质量指标,快速对比模型效果
You can easily calculate FVD, PSNR, SSIM, LPIPS for evaluating the quality of genera···
 MMAD
开源
用统一基准测出多模态大模型在工业质检中的真实水平
The Codes and Data of A Comprehensive Benchmark for Multimodal Large Language Models···
 frontier-evals
开源
用统一标准跑分,快速对比前沿模型真实能力
OpenAI Frontier Evals
 claw-swe-bench
开源
统一接口跑 SWE-bench,横向比出哪个 agent 框架更能修 bug
Unified adapter framework for evaluating agent harnesses (claws) on SWE-bench
 Guardrails
开源
给大模型对话装上可编程的安全护栏,防止跑偏和有害输出。
NeMo Guardrails is an open-source toolkit for easily adding programmable guardrails ···
 openguardrails
开源
给 AI Agent 加本地规则、沙箱和网络管控三道闸
AI agent guardrails for every builder. Local rules, a sandbox and a firewall for you···
 awesome-direct-preference-optimi···
开源
一网打尽DPO论文与代码,快速入门偏好对齐
A Survey of Direct Preference Optimization (DPO)
 Workspace-Bench
开源
在真实文件海洋中,检验智能体自我进化能力
Benchmark self-evolving Agent upon realistic large-scale file workspaces