
项目预览
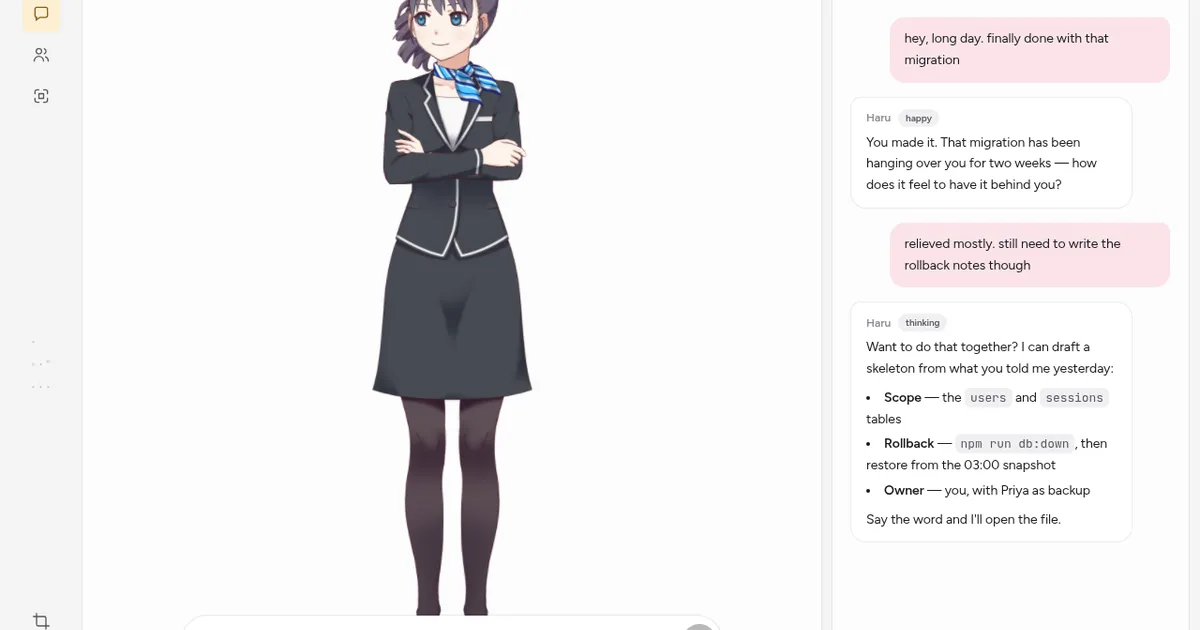
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-09 · 当前星标 ★ 79
核心亮点
- 集成Live2D/VRM,角色表情和口型同步,互动沉浸感强
- 支持文本和语音双模态对话,并带逐句情绪反应
- 自托管部署,数据隐私可控,且技术栈现代(TS+Python)
不足之处
- 项目早期,文档和社区生态待观察
- 依赖多个AI服务(LLM/ASR/TTS),部署配置可能复杂
适用场景
- 个人娱乐:与虚拟角色日常聊天解闷
- 虚拟主播/陪伴直播:用AI角色实时互动
- 技术爱好者:学习多模态AI交互集成
替代项目
SillyTavern、TavernAI、AI-Hobbyist
上一篇:XnneHangLab
下一篇:AI-Waifu-Vtuber
同类项目推荐
 stable-dreamfusion
开源
一句话生成 3D 模型,从文本或图片到可导出网格
Text-to-3D & Image-to-3D & Mesh Exportation with NeRF + Diffusion.
 OliveWolf
开源
说话就能让 3D 人动起来,全身头肩随便切。
OliveWolf — 开源3D数字人引擎: LHM(全身3D)+LivePortrait(2D头肩)双后端, 实时音频驱动问···
 SolidUI
开源
一句话生成可视化图表,告别手写代码
one sentence generates any graph
 prompt-to-animation
开源
打几个字就变动画角色,创意一秒动起来。
Prompt to Animation — turn a text description into a downloadable interactive chara···
 VideoChat
开源
3秒低延迟,自定义形象音色,快速搭建你的实时数字人。
实时交互数字人,可自定义形象与音色,支持音色克隆,对话延迟低至3s。Real-time voice in···
 Matlaber
开源
从文字直接生成带真实材质的 3D 模型,告别塑料感
MATLABER: Material-Aware Text-to-3D via LAtent BRDF auto-EncodeR
 worldexplorer
开源
单图生成可自由行走的 3D 世界,告别固定视角
[SIGGRAPH Asia 2025] WorldExplorer: Towards Generating Fully Navigable 3D Scenes
 digital-human-koubo
开源
一张照片,自动生成带包装的口播数字人视频
AI digital-human talking-head videos from one photo: Renoise MCP generation + 5 edit···
 WorldGen
开源
输入一句话,几秒生成完整 3D 场景,无需建模基础。
WorldGen - Generate Any 3D Scene in Seconds