

项目预览
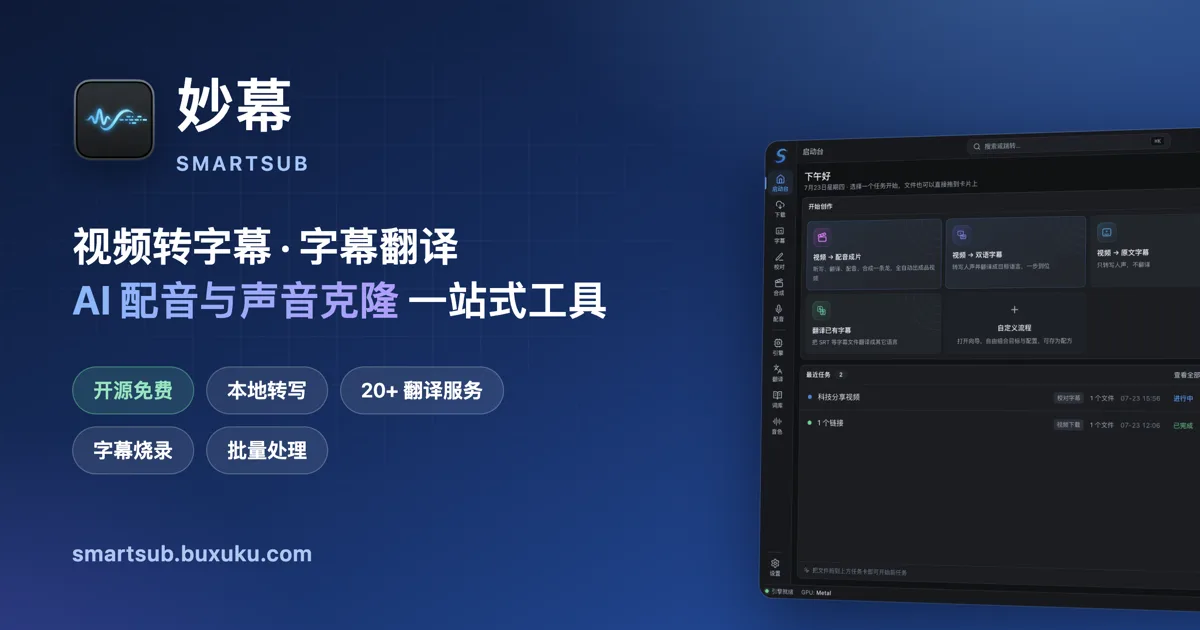
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-10 · 当前星标 ★ 5980
使用教程
环境要求
- Windows x64 系统(NVIDIA 显卡可用 CUDA,AMD / Intel 用 Vulkan,加速包在应用内下载)
- macOS Apple 芯片(自动启用 Core ML / Metal 加速)
- macOS Intel 芯片(仅 CPU,不支持 GPU 加速)
- Linux x64 系统(NVIDIA 用 CUDA,AMD / Intel 用 Vulkan,应用内下载)
- 无 GPU 也可使用,可跟随引导下载模型或配置云端听写
安装与启动步骤
-
1下载安装包
打开 GitHub Releases 或夸克网盘,按系统和芯片选择对应安装包下载并安装,GPU 加速包无需在此处选择。
-
2Homebrew 安装(macOS)
macOS 用户推荐用 Homebrew 安装,会自动匹配芯片类型;第一行只需执行一次。
brew tap buxuku/tap brew install --cask smartsub -
3升级应用(可选)
已通过 Homebrew 安装的用户,后续可直接用该命令升级到新版本。
brew upgrade --cask smartsub -
4下载语音模型
安装后跟随新手引导下载一个语音模型;无 GPU 或不想下载模型时,可改为配置云端听写。
-
5新建并处理任务
在启动台选择任务,拖入音视频或字幕文件(或粘贴在线视频链接下载),设置源语言、目标语言等参数后开始处理。
-
6校对与合成
处理完成后可继续校对字幕、配音或烧录合成,形成完整字幕与配音流水线。
关键配置
| 配置项 | 必填 | 说明 | 示例 |
|---|---|---|---|
API Key | 否 | 接入云端翻译、云端听写或云端配音服务时填写,本地流程不需要 | sk-xxxxxxxx |
如何确认成功
应用安装后能正常打开并出现新手引导,可成功下载语音模型、拖入文件并开始处理任务。
常见问题
Q:整条流程必须付费或用 API Key 吗?
A:不需要。本地模型转写、内置免费翻译源、本地 TTS 配音(含声音克隆)、本地 ffmpeg 烧录可完全免费跑通,本地环节也没有用量限制。
Q:GPU 加速包要在下载时选择吗?
A:不用。GPU 加速包在下载安装包时无需选择,安装后在应用内按需下载,NVIDIA 用 CUDA,AMD / Intel 用 Vulkan。
Q:macOS Intel 机型能 GPU 加速吗?
A:不能。mac-x64 版本仅支持 CPU,不支持 GPU 加速;Apple 芯片机型会自动启用 Core ML / Metal 加速。
Q:文件会被上传到云端吗?
A:转写基于 whisper.cpp、sherpa-onnx 等本地模型完成,文件不出本机;只有按需接入云端服务时才会走网络。
注意事项
- 安装包按操作系统与芯片类型选择,选错芯片版本可能无法正常运行。
- GPU 加速包在应用内按需下载,不必在下载安装包时选择。
- 本地流程无需 API Key,接入 20 个翻译服务、9 家云端听写、6 类云端配音属于可选增强。
核心亮点
- 完全离线运行,保护隐私,无需上传视频或音频到云端
- 支持多种本地模型(Whisper、FunASR 等),灵活适配不同场景和语言
- 全平台 GPU 加速,批量处理大幅提升字幕生成效率
不足之处
- 界面和文档以英文为主,中文用户上手有一定门槛
- 本地模型对硬件要求较高,低配设备可能运行缓慢
适用场景
- 视频创作者快速生成和翻译字幕,提升内容产出效率
- 字幕组批量处理多语言视频,降低人工翻译成本
- 教育机构为课程视频添加多语言字幕和配音,扩大受众
替代项目
Subtitle Edit、VideoSubFinder、Aegisub
上一篇:openwhispr
下一篇:speaches
同类项目推荐
 klaam
开源
一站式搞定阿拉伯语语音识别、分类与合成
Arabic speech recognition, classification and text-to-speech.
 SenseVoice
开源
一个模型搞定多语言识别、情感和事件检测,开箱即用
Open-source SenseVoiceSmall model for Mandarin, Cantonese, English, Japanese, and Ko···
 Llama-AVSR
开源
用大语言模型提升音视频语音识别准确率,解决复杂场景听不清问题
Official Pytorch implementation of "Large Language Models are Strong Audio-Visual Sp···
 whisperx-asr-service
开源
把 WhisperX 变成开箱即用的语音识别 API 服务
 spokestack-android
开源
给安卓应用加上完整语音对话能力,唤醒、识别、理解、合成一步到位。
Extensible Android mobile voice framework: wakeword, ASR, NLU, and TTS. Easily add v···
 mila
开源
Mac 上离线转写音频,还能分清谁在说话
Mila — native macOS local transcription app (whisper.cpp) with optional speaker dia···
 kaldi-active-grammar
开源
解码中随时切换语法,让语音命令和听写自由混用
Python Kaldi speech recognition with grammars that can be set active/inactive dynami···
 wenet
开源
开箱即用的生产级语音识别,从训练到部署一步到位
Production First and Production Ready End-to-End Speech Recognition Toolkit
 lingvo
开源
用 Google 的序列建模框架,快速搞定语音和翻译实验
Lingvo