

talking-avatar-with-ai
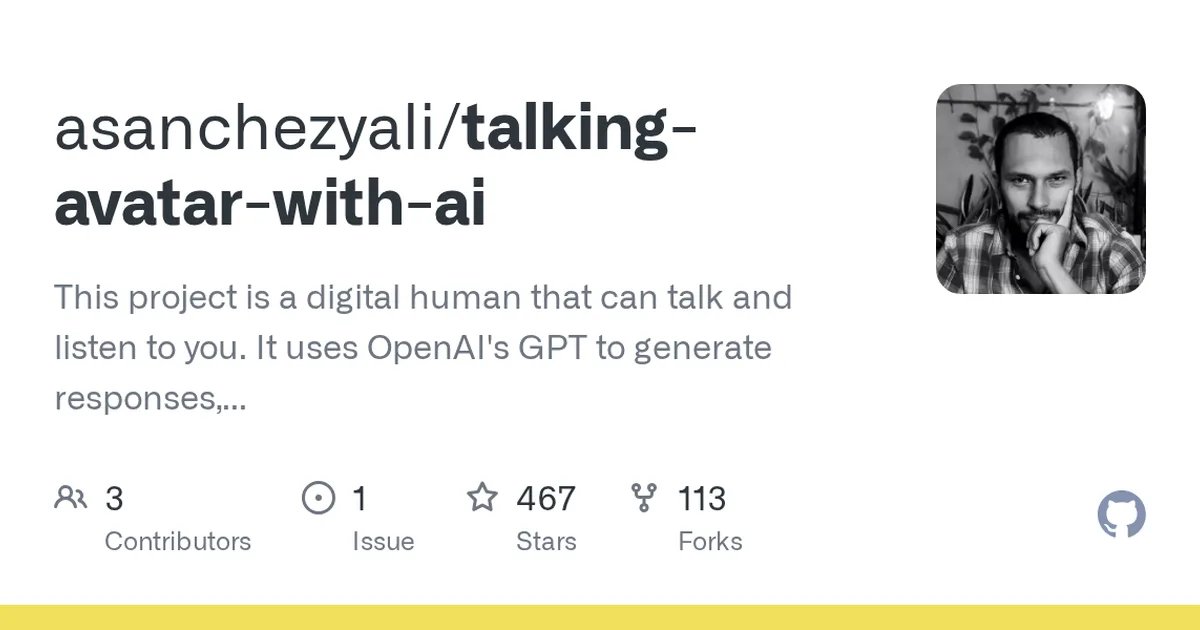
让网页里的虚拟形象开口说话,还能听懂你
项目预览
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-09 · 当前星标 ★ 472
使用教程
ℹ 本教程由 AI 依据该项目 README 整理,个别步骤可能需要按你的环境微调。
环境要求
- Node.js
- 模型 API Key
- 语音合成服务 Key
- ffmpeg
安装与启动步骤
-
1备齐两组订阅
模型与语音合成各需要一份服务,语音合成免费档会频繁失败。
-
2装口型工具
它的口型动画靠本地可执行文件,解压后放进后端的 bin 目录。
-
3装音视频处理依赖
缺这一项会在音频处理阶段报错。
ffmpeg -version -
4起前后端
前端是网页,后端负责调用各家服务。
yarn dev -
5对着麦克风说一句
重点看口型与语音是否同步。
如何确认成功
对着麦克风说一句话,页面上的形象能先转写、再回答、同时口型与语音大致同步
注意事项
- 它把语音识别、对话、语音合成、口型生成串在浏览器里,是一个数字人演示项目。
- 口型工具是本地可执行文件,要手动下载并放到后端指定目录,这一步最容易漏。
- 语音合成的免费档请求过多会失败,作者明确建议用付费档。
- 整条链路要三次外部调用,延迟叠加明显,实时感有限。
核心亮点
- 完整集成语音识别、AI对话、语音合成和口型同步,开箱即用
- 基于Web技术,无需复杂后端,部署简单
- 模块化设计,可替换各AI服务提供商
不足之处
- 依赖多个外部付费API(OpenAI、Eleven Labs),运行成本较高
- 口型同步效果依赖Rhubarb Lip Sync,对复杂表情支持有限
- 文档/社区待观察
适用场景
- 虚拟客服助手,提供语音交互服务
- 在线教育中的虚拟教师,进行语音讲解
- 娱乐互动,如虚拟偶像或游戏NPC对话
替代项目
HeyGen、SadTalker、Wav2Lip
同类项目推荐
 deepopen-3d-webs
开源
一张图加提示词,浏览器里生成可回放的三维场景
Image-driven 3D scene generation system. Users provide a reference image and prompt ···
 MM2022-ViCoPerceptualHeadGenerat···
开源
用一张照片和驱动信号,生成口型同步的逼真说话人视频
MM2022 Workshop-Perceptual Conversational Head Generation with Regularized Driver an···
 OpenAmika
开源
会说话、有形象、记得你的开源虚拟伴侣
OpenAmika: MekaHime's AI companion Amika, open source. Live2D avatar, real-time voic···
 OTAvatar
开源
一张照片,秒级生成可说话的3D数字人头像
[CVPR2023] OTAvatar: One-shot Talking Face Avatar with Controllable Tri-plane Render···
 PartCrafter
开源
一句话生成带部件结构的3D网格,可编辑可重组
[NeurIPS 2025] PartCrafter: Structured 3D Mesh Generation via Compositional Latent D···
 reflect3r
开源
单张照片+镜子,重建出完整 3D 立体模型
[3DV 2026] Reflect3r: Single-View 3D Stereo Reconstruction Aided by Mirror Reflectio···
 NOC3D-chapter6
开源
把《代码本色》的智能体算法搬进 3D 世界,边看边学
Nature of Code - Autonomous Agents examples in 3D
 worldexplorer
开源
单图生成可自由行走的 3D 世界,告别固定视角
[SIGGRAPH Asia 2025] WorldExplorer: Towards Generating Fully Navigable 3D Scenes
 kimodo
开源
扩散模型一键生成自然人体动作序列
Official implementation of Kimodo, a kinematic motion diffusion model for high-quali···