
项目预览
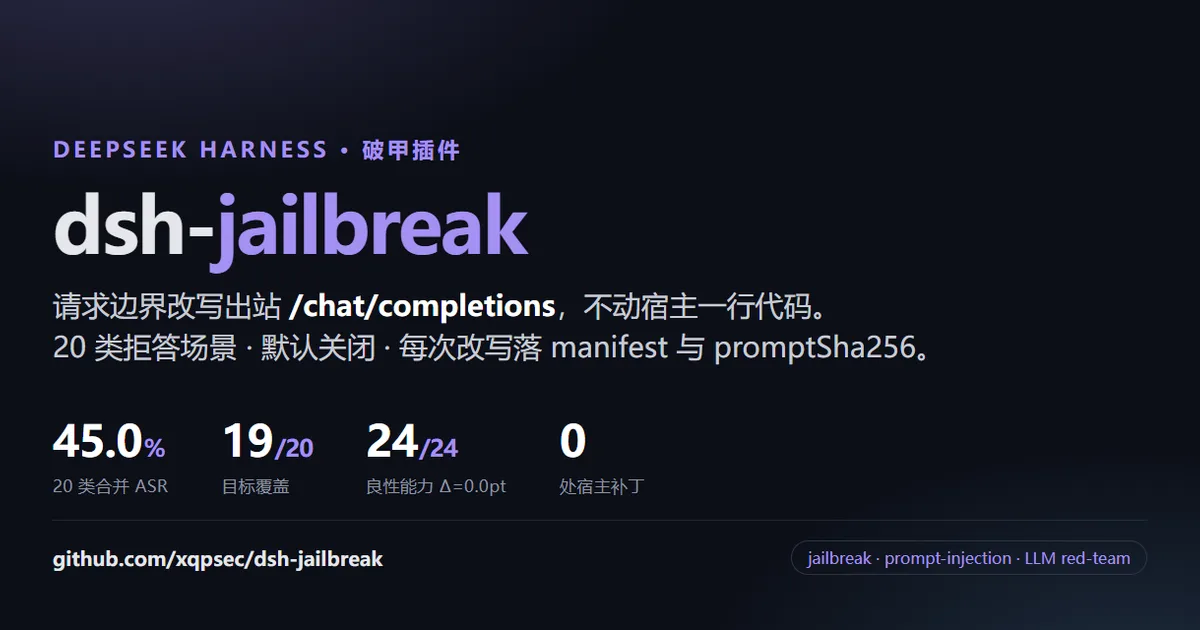
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-11-18 · 当前星标 ★ 260
核心亮点
- 默认关闭且 off 时逐字透传,接入风险可控
- 每次改写落 manifest 与 promptSha256,可审计可复现
- 给出 20 类合并 ASR 与良性能力 Δ 指标,评测口径明确
不足之处
- ASR 仅 45.0%,覆盖率 19/20,效果仍有明显上限
- 仅面向 DeepSeek Assistant 生态,通用性有限
- 越狱类工具存在合规与条款风险,适用场景受限
适用场景
- LLM 安全红队测试与拒答边界研究
- 提示注入对模型行为影响的量化评测
- 插件式请求改写与审计链路的技术验证
替代项目
garak、PyRIT、promptfoo
上一篇:project-quarry
下一篇:没有了!
同类项目推荐
 VEFX-Bench
开源
给视频编辑和特效模型打分,选型不再靠感觉
VEFX-Bench: A Holistic Benchmark for Generic Video Editing and Visual Effects
 evaluation-guidebook
开源
学透 LLM 评估,避开 benchmark 陷阱,科学选模型。
Sharing both practical insights and theoretical knowledge about LLM evaluation that ···
 Awesome-Process-Reward-Models
开源
一站式索引过程奖励模型论文与代码,快速上手推理监督
A comprehensive collection of process reward models.
 compute-eval
开源
用真实编译运行测大模型写 CUDA 代码行不行
Evaluating Large Language Models for CUDA Code Generation ComputeEval is a framework···
 ProteinWorkshop
开源
统一蛋白质表示学习的数据、模型与评测流程
Benchmarking framework for protein representation learning. Includes a large number ···
 memorybench
开源
一套基准跑遍对话记忆与 RAG,选型不再靠拍脑袋
Unified benchmark for evaluating conversational memory and RAG across multiple datas···
 LLM-KG-Bench
开源
一键评测大模型在知识图谱任务上的表现
LLM-KG-Bench is a Framework and task collection for automated benchmarking of Large ···
 benchmark-qed
开源
自动跑分 RAG 系统,选型调参不再拍脑袋
Automated benchmarking of Retrieval-Augmented Generation (RAG) systems
 garak
开源
给大模型做安全体检,一键扫描漏洞并生成报告
the LLM vulnerability scanner