
项目预览
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-10-22 · 当前星标 ★ 153
技术标签
核心亮点
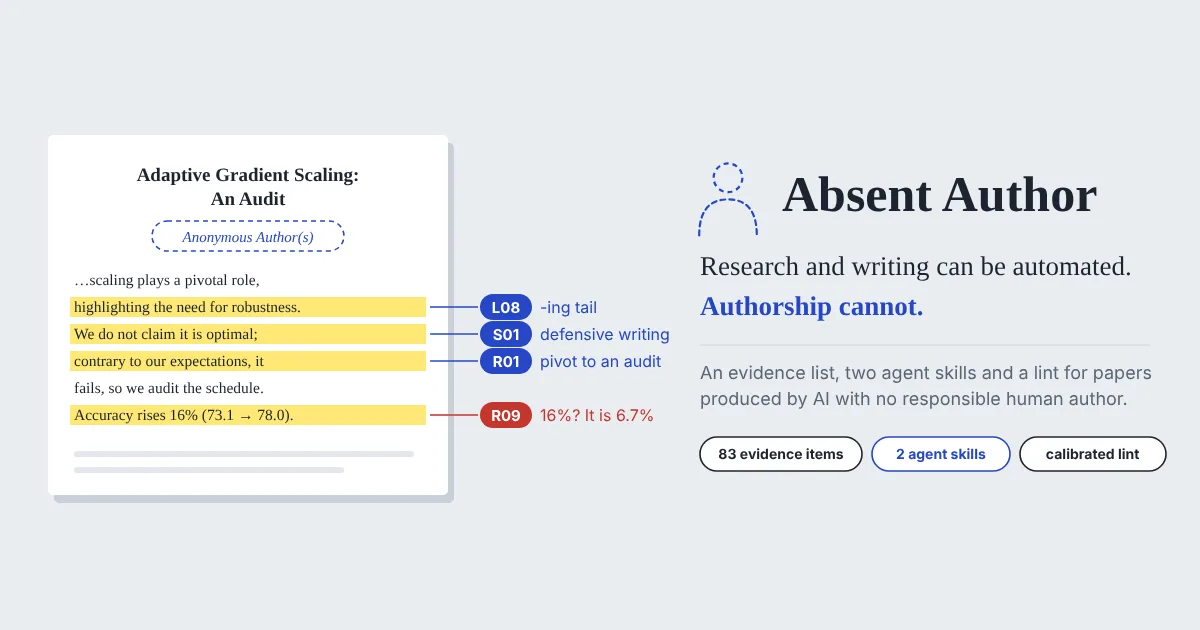
- 提供可核查的证据清单,而非黑箱式 AI 检测分数,便于评审者复核
- 以 agent skills 形式集成到 Claude Code、Codex 等现有 LLM 工作流,落地成本低
- 聚焦作者责任与人类参与度这一评审盲区,选题角度具体且实用
不足之处
- 早期项目,规则与证据模板覆盖面有限,需结合人工判断
- 依赖 LLM 工具链,检测效果受模型与提示词影响,稳定性待观察
适用场景
- 期刊编辑在送审前批量筛查投稿是否存在 AI 代写迹象
- 会议程序委员会辅助评审者判断稿件的人类参与度
- 高校科研诚信办公室调查可疑论文时整理证据链
替代项目
GPTZero、OpenAI detector
上一篇:ko-pii
下一篇:frontier-evals
同类项目推荐
 AdvUnlearn
开源
对抗训练让概念擦除更抗攻击,生成更安全
Official implementation of NeurIPS'24 paper "Defensive Unlearning with Adversarial T···
 Awesome-Offensive-AI-Agentic-Lan···
开源
一张图看懂 AI 攻防:渗透、红队、漏洞发现全收录
This document curates open-source projects, academic papers, capability benchmarks, ···
 awesome-rsi
开源
一张图看懂 AI 自我改进的研究版图
A curated research map of Recursive Self-Improvement (RSI): models, agents, harnesse···
 xFinder
开源
用AI自动评估AI,让模型评测更可靠、更省力
[ICLR 2025] xFinder: Large Language Models as Automated Evaluators for Reliable Eval···
 AutoControl-Arena
开源
自动给AI找茬,提前暴露危险行为
[ICML 2026] AutoControl Arena: Frontier AI Risk Auto-Discovery Platform
 ai-eval-platform
开源
一站式评测 AI 应用,让质量看得见
开源 AI 应用评测平台,支持 RAG、AI Agent、多轮对话、LLM-as-Judge、接口评测、评测报告···
 SREGym
开源
用真实生产事故考题,测出 AI Agent 会不会排障
Can AI agents resolve production incidents?
 Awesome-Mental-Health-LLMs
开源
一篇文章看懂LLM做心理健康的技术地图与风险
From Pattern Recognizers to Personalized Companions: A Survey of Large Language Mode···
 tts-bench
开源
一键跑遍主流 TTS,比速度、留样本
Speed and samples benchmark: for all types of text to speech (TTS) models on Windows···