

Auto-Synced-Translated-Dubs
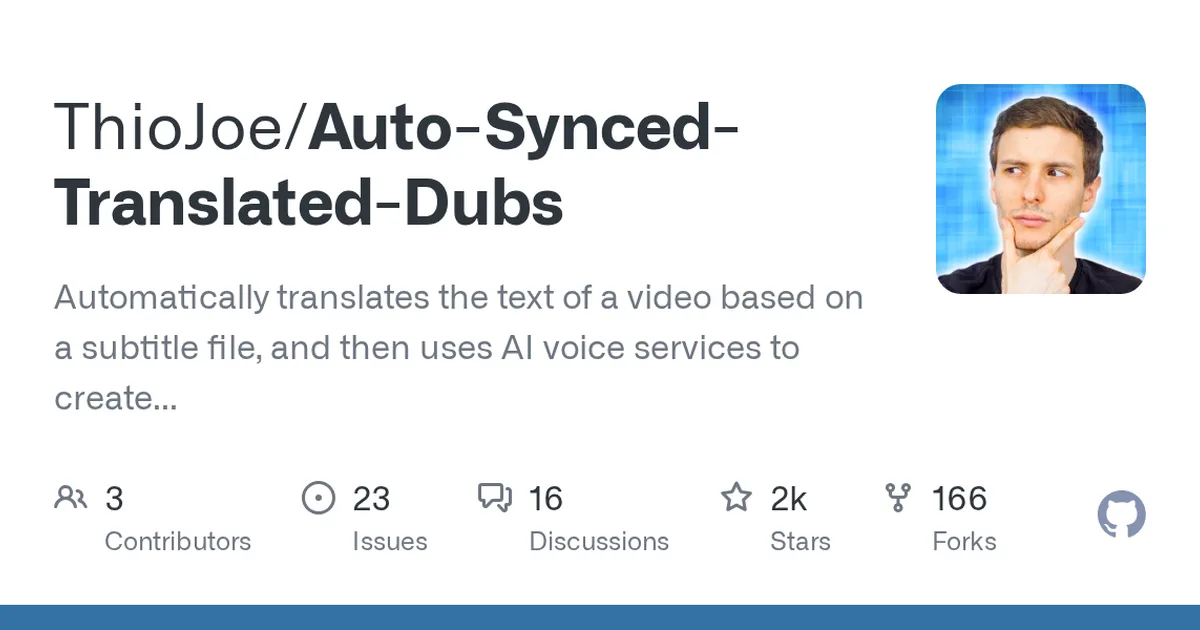
上传视频和字幕,自动生成多语言配音,音画同步无需手动。
项目预览
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-09 · 当前星标 ★ 1753
使用教程
环境要求
- Python 3.9(作者开发版本,更低版本可能也能运行)
- 已安装 pip,可执行 pip install -r requirements.txt
- README 中 External Requirements 列出的外部程序(使用 TrackAdder.py 时需 ffmpeg)
- Google Cloud、Microsoft Azure 或 DeepL 其中至少一家的 API 访问凭证
安装与启动步骤
-
1获取项目代码
把仓库下载或克隆到本地,后续所有配置文件都在该项目目录内修改。
git clone https://github.com/ThioJoe/Auto-Synced-Translated-Dubs.git -
2安装 Python 依赖
在项目根目录执行,安装 requirements.txt 中列出的全部 Python 依赖。
pip install -r requirements.txt -
3安装外部程序
按 README 的 External Requirements 安装所需外部程序;用 TrackAdder.py 合轨时还需要 ffmpeg。
-
4配置云服务密钥
在 cloud_service_settings.ini 中填入 Google Cloud、Azure 或 DeepL 的 API 凭证与相关变量。
-
5配置全局参数
编辑 config.ini,设置采样率、格式、是否跳过翻译、是否双遍合成等,默认值多数情况可用。
-
6配置语言与素材
编辑 batch.ini:在 [SETTINGS] 填原视频和原字幕路径,用 enabled_languages 指定要处理的语言编号。
-
7运行主程序
配置完成后执行脚本并等待其跑完,翻译字幕与配音音轨会输出到 output 文件夹。
python main.py
关键配置
| 配置项 | 必填 | 说明 | 示例 |
|---|---|---|---|
cloud_service_settings.ini | 是 | 存放 Google Cloud / Azure / DeepL 的 API 访问凭证等云服务变量 | xxxxxxxxxxxxxxxxxxxxxxxx |
config.ini | 是 | 翻译、合成、格式与采样率等全局设置,含跳过翻译、双遍合成开关 | 使用默认配置 |
enabled_languages | 是 | batch.ini 中列出本次要处理的语言编号,对应 [LANGUAGE-#] 段 | 1,2,3 |
batch.ini [SETTINGS] 原视频路径 | 是 | 原始视频文件路径,用于获取正确的音频长度 | /your/path/video.mp4 |
batch.ini [SETTINGS] 原字幕路径 | 是 | 原始字幕文件路径,作为翻译和计时的时间轴来源 | /your/path/subtitle.srt |
如何确认成功
运行结束后检查 output 文件夹,能看到新生成的翻译版 SRT 字幕文件和配音音轨即成功。
常见问题
Q:翻译和语音合成分别能用哪些服务?
A:翻译可用 Google Cloud 或 DeepL;TTS 可用 Google Cloud 或 Microsoft Azure。Azure 音质更好(最高 48KHz,Google 为 24KHz),Google 翻译更快更便宜且支持语言更多。
Q:译文语音怎么和原视频对齐?
A:程序根据字幕行的时间轴计算每段语音应有的时长,再拉伸或压缩音频。默认开启双遍合成以提升音质;若用 Azure TTS 可直接指定时长,无需这一步。
Q:怎么把配音轨道合进 mp4?
A:用可选的 TrackAdder.py 脚本,需要先安装 ffmpeg,并打开脚本修改顶部 User Settings 区域的值。
Q:一次能处理多种语言吗?
A:可以。在 batch.ini 的 enabled_languages 中列出语言编号,程序会按顺序批量处理这些语言,未列出的语言不会被处理。
Q:生成的成品会放在哪里?
A:翻译后的字幕文件和配音音轨都会放在项目下的 output 文件夹中,TitleTranslator.py 生成的标题描述文本也放在该文件夹。
注意事项
- 使用前需自行申请并配置 Google Cloud、Azure 或 DeepL 的 API 凭证
- 务必核对各云服务文档中支持的语言和语音,避免选了不支持的音色
- TrackAdder 生成的多音轨 MP4 需要 YouTube 频道权限支持,多数频道需联系创作者支持申请
- TitleTranslator.py 与 TrackAdder.py 均为可选脚本,不影响 main.py 主流程
核心亮点
- 全自动流水线,从字幕到配音一步到位,无需人工干预
- 支持多种翻译和TTS服务,可灵活替换,适配不同需求
- 时间轴同步机制成熟,确保配音与画面精准对齐
不足之处
- 依赖外部AI服务,需自备API密钥,可能产生费用
- 对字幕质量要求高,缺失或错误字幕会影响最终效果
适用场景
- 视频内容创作者快速制作多语言版本,扩大受众
- 教育机构将课程视频本地化,方便非母语学生
- 影视爱好者自制字幕配音,体验多语言观影
替代项目
VideoLingo、pyvideotrans、Dubify
上一篇:RHVoice
下一篇:read-aloud
同类项目推荐
 tts-audiobook-tool
开源
一个工具集成多种TTS模型,轻松制作高品质有声书
Audiobook creation app supporting too many TTS models (Qwen3-TTS, OmniVoice, VibeVoi···
 NeuralTextToAudio
开源
输入文字描述,自动生成对应音频片段
Text prompt steered synthetic audio generators
 SAPI4
开源
在浏览器里复活微软 Sam 老语音,一键合成怀旧音频
Web interface for Microsoft Sam & friends
 talk-to-fengge
开源
克隆声音性格,1秒内实时对话
Talk to 峰哥 — 克隆任何人的声音和性格,实时语音对话,工程延迟 < 1 秒 | Clone anyone···
 NATSpeech
开源
并行生成语音,速度翻倍,效果不输自回归
A Non-Autoregressive Text-to-Speech (NAR-TTS) framework, including official PyTorch ···
 FluidAudio
开源
在苹果设备上本地运行前沿音频 AI,实现离线语音交互。
Frontier CoreML audio models in your apps — text-to-speech, speech-to-text, voice a···
 DiffRoll
开源
用扩散模型把音频自动变成钢琴卷帘谱
PyTorch implementation of DiffRoll, a diffusion-based generative automatic music tra···
 GenVC
开源
零样本音色转换,用自监督语言模型保留情感和韵律
Self-supervised Generative LM-based Voice Conversion
 MsEdgeTTS
开源
免密钥免费调用 Edge 高质量语音合成,几行代码集成 TTS
A simple Azure Speech Service module that uses the Microsoft Edge Read Aloud API. ht···