

audio-diffusion
像画图一样生成音乐,给段描述就出专属旋律
项目预览
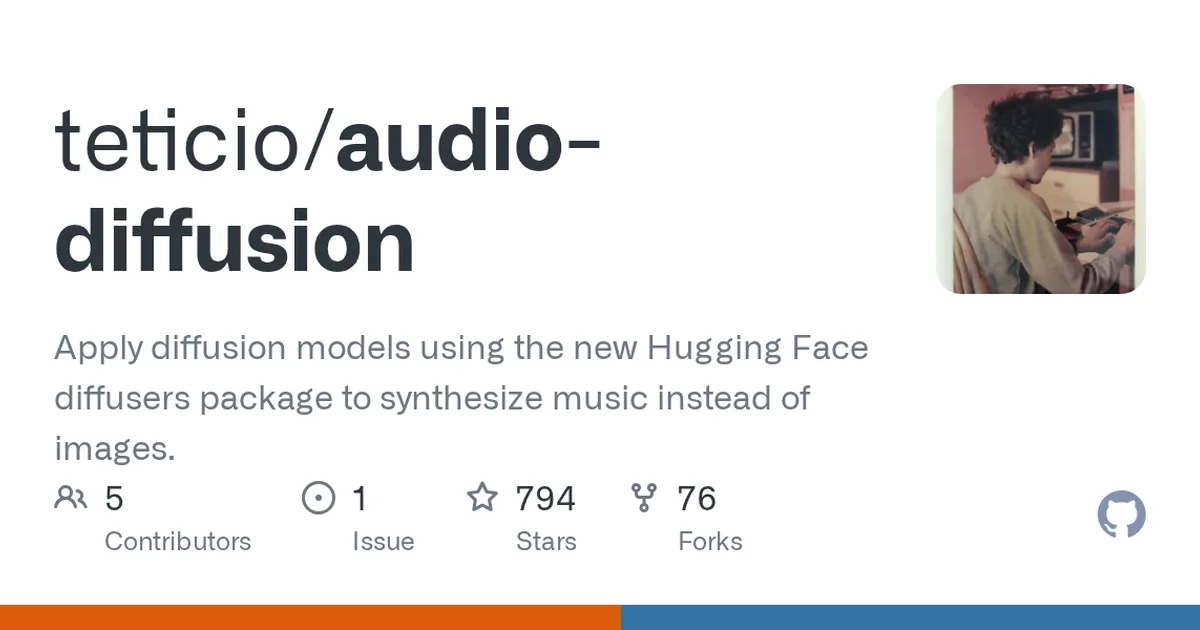
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-09 · 当前星标 ★ 795
使用教程
ℹ 本教程由 AI 依据该项目 README 整理,个别步骤可能需要按你的环境微调。
环境要求
- NVIDIA GPU 12G+
- Python 3.9+
- 音频数据集
安装与启动步骤
-
1克隆
音频扩散模型,可做音乐与音效生成。
git clone https://github.com/teticio/audio-diffusion.git cd audio-diffusion -
2装包
两种方式二选一,别都装。
pip install audiodiffusion -
3转成频谱图
先把音频转成图像表示,这是训练的前提。
python scripts/audio_to_images.py --input ./audio --output ./images -
4训练或采样
小数据集也能跑,注意采样率统一。
python scripts/train_vae.py --config configs/vae.yaml
如何确认成功
采样输出里能听到与训练集风格一致的片段。
注意事项
- 频谱图法本质是把音频当图像生成,胜在复用扩散模型。
- 采样率不统一会导致音调错乱,预处理时统一 44.1k。
- 长音频要切片,否则显存不够。
核心亮点
- 将 Hugging Face diffusers 包应用于音乐生成,降低了扩散模型在音频领域的上手门槛
- 基于 latent diffusion 技术,支持在潜在空间生成音频,计算效率较高
- 提供 Jupyter Notebook 示例,便于学习和复现
不足之处
- 项目处于早期阶段,功能相对简单,缺乏完善的训练和推理流程
- 文档/社区待观察
适用场景
- 音乐生成研究原型验证
- 学习扩散模型在非图像领域的应用
- 作为音频扩散模型的入门参考
替代项目
AudioLDM、Diffusion-LM、Jukebox
同类项目推荐
 VoiceStudio
开源
开源语音全能工作站,克隆、配音、转录一站式搞定
VoiceStudio is the open-source, fully-local ElevenLabs alternative — voice cloning,···
 jpreprocess
开源
用 Rust 重写 OpenJTalk,让日语 TTS 文本预处理更快更安全
Japanese text preprocessor for Text-to-Speech applications (OpenJTalk rewrite in rus···
 SpeakThat
开源
戴上耳机,重要通知自动念给你听,解放双眼。
The world's most comprehensive notification reader.
 Dia-Finetuning-Vietnamese
开源
用Dia微调越南语TTS,快速实现语音克隆
TTS Dia finetuning for Vietnamese
 tts-azure-web
开源
用 Azure Key 一键部署,网页上直接生成自然语音
TTS Azure Web 是一个 Azure 文本转语音(TTS)网页应用,可以在本地或者云端使用你的 Azu···
 viet-tts
开源
给越南语应用加上自然语音,开源免费即用
VietTTS: An Open-Source Vietnamese Text to Speech
 TTS
开源
训练并部署高拟真语音合成模型,轻松打造专属声音
:robot: :speech_balloon: Deep learning for Text to Speech (Discussion forum: https:···
 ddo-tts
开源
安装即用,Edge 语音秒变朗读神器
内置EdgeTTS大声朗读, 文字转语音无需额外部署 即装即听, 语音引擎采用rany2/edge-tts 稳···
 MusicGenerator
开源
用 TensorFlow 玩转多种深度学习音乐生成模型
Experiment diverse Deep learning models for music generation with TensorFlow