

项目预览
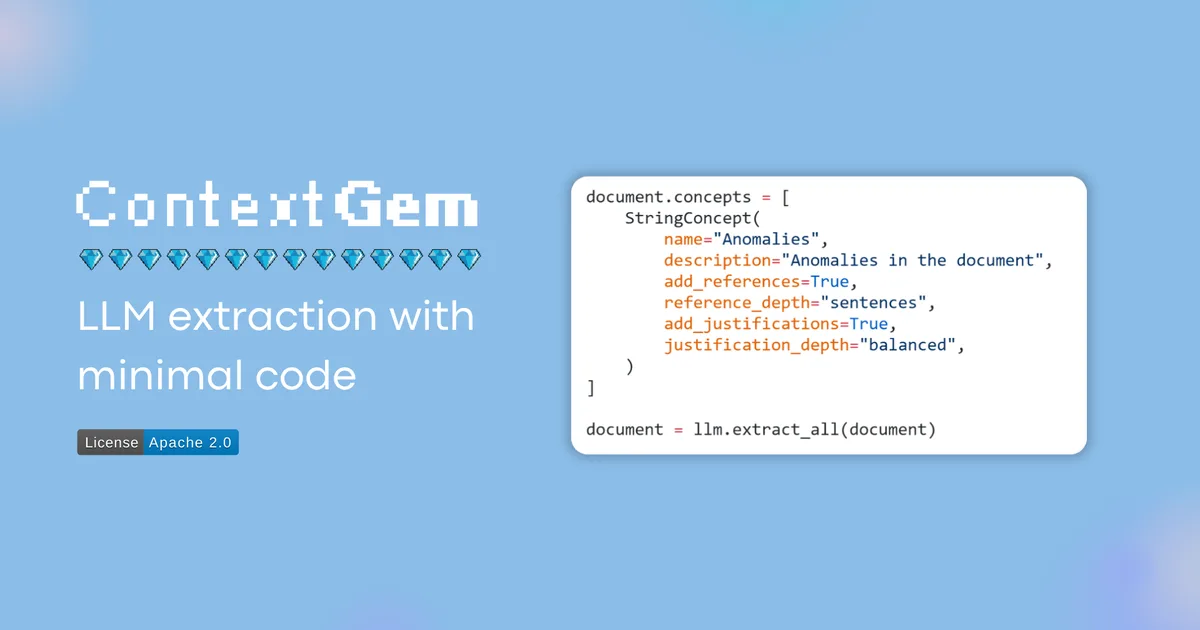
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-09 · 当前星标 ★ 2077
使用教程
ℹ 本教程由 AI 依据该项目 README 整理,个别步骤可能需要按你的环境微调。
环境要求
- Python 3.10 / 3.11 / 3.12 / 3.13 / 3.14
- 可用的 Python 包管理工具:pip 或 uv(uv 为官方推荐)
- 一个可调用的 LLM 后端及其 API Key(如 OpenAI)
安装与启动步骤
-
1安装 ContextGem
用 pip 安装官方发布的 contextgem 包,-U 参数确保升级到最新版本。
pip install -U contextgem -
2用 uv 安装(可选)
如果你使用 uv 管理依赖,可用 uv add 把 contextgem 加入项目依赖,README 中推荐这种方式。
uv add contextgem -
3导入核心类
ContextGem 的主要入口是 Document、DocumentLLM 和 StringConcept 三个类,按需导入即可。
from contextgem import Document, DocumentLLM, StringConcept -
4配置 LLM 后端
创建 DocumentLLM 实例,model 使用「提供商/模型名」格式,api_key 填你自己的密钥。
llm = DocumentLLM( model="openai/gpt-5-mini", # or another provider/LLM api_key="sk-xxxxxxxx", ) -
5执行抽取
把定义好的 Document 交给 LLM 一次性抽取全部 aspect 与 concept,返回填充好结果的 document。
document = llm.extract_all(document)
关键配置
| 配置项 | 必填 | 说明 | 示例 |
|---|---|---|---|
model | 是 | 指定使用的 LLM,格式为提供商/模型名 | openai/gpt-5-mini |
api_key | 是 | 调用对应 LLM 服务所需的 API 密钥 | sk-xxxxxxxx |
如何确认成功
extract_all 正常返回填充了抽取结果的 document 对象、且未抛出异常即视为运行成功。
常见问题
Q:支持哪些 Python 版本?
A:README 徽章显示支持 Python 3.10、3.11、3.12、3.13、3.14。
Q:一定要用 OpenAI 的模型吗?
A:不是。DocumentLLM 的 model 可换成其他提供商或本地 LLM,填写对应的 model 与 api_key 即可。
Q:单个模型效果不理想怎么办?
A:可使用 LLM Group:给一组 LLM 分配不同角色,把不同 aspect/concept 路由到专用模型,例如简单抽取与推理任务分开。
Q:pip 和 uv 装哪个?
A:README 推荐 uv(uv add contextgem),用 pip 时执行 pip install -U contextgem 即可,两者选其一。
注意事项
- README 的 Quick Start 示例被截断,完整用法请参考官网 Quick Start 页面。
- DocumentLLM 支持备用模型(fallback models)与基于角色的任务路由。
- 官方示例中的 api_key 需替换为你自己的真实密钥,不要提交到代码仓库。
- 更多 Aspect/Concept 抽取示例见官网 Basic usage 与 Advanced usage 章节。
核心亮点
- 基于 Pydantic 声明式定义提取模型,代码简洁且类型安全
- 自动处理文档分块和上下文窗口,降低长文档提取难度
- 内置结果校验与修正,提升提取准确性和可靠性
不足之处
- 主要面向 Python 生态,不支持其他语言
- 文档/社区待观察
适用场景
- 合同关键条款自动提取与审核
- 简历信息解析并录入 HR 系统
- 研究报告或论文中结构化数据抽取
替代项目
LangChain、LlamaIndex、Instructor
同类项目推荐
 xerj
开源
资料自动编好索引,AI 找答案省时又省钱
AI search engine and MCP server for bots and agents. One Rust binary indexes code, d···
 llm-rankers
开源
用大模型给搜索结果重排序,几行代码跑通评测
Document Ranking with Large Language Models.
 MimirQ
开源
中文企业知识库,从解析到引用全流程可控,直接接入 Dify 用
中文优先的企业 RAG 知识库:可控解析、治理、切块、混合检索、重排、引用、图谱、评测与 ···
 aixplora
开源
上传任意文件,用聊天方式秒速查询内容
AIxplora is a open-source tool which let's you query all kind of files not limited t···
 RAGNotebook
开源
让笔记变聪明,用自然语言问你的知识库
基于LangChain、LangGraph、FastAPI和React的RAG项目,主分支为基于知识图谱的知识管理平台···
 amazon-bedrock-rag
开源
在 AWS 上快速部署托管 RAG,无需自建向量库
Fully managed RAG solution implemented using Knowledge Bases for Amazon Bedrock
 getcito-worlds-first-open-source···
开源
监控并优化你的内容在 AI 搜索中的可见度。
GetCito the World's First Open Source AI Search Optimization (AIO) / Answer Engine O···
 haiku.rag
开源
用 LanceDB + Pydantic AI 快速搭建生产级智能 RAG 应用
Agentic RAG for local and self-hosted document search: hybrid retrieval, reranking a···
 VisRAG
开源
不解析文档,直接看图检索,提升 RAG 准确率
Parsing-free RAG supported by VLMs