

项目预览
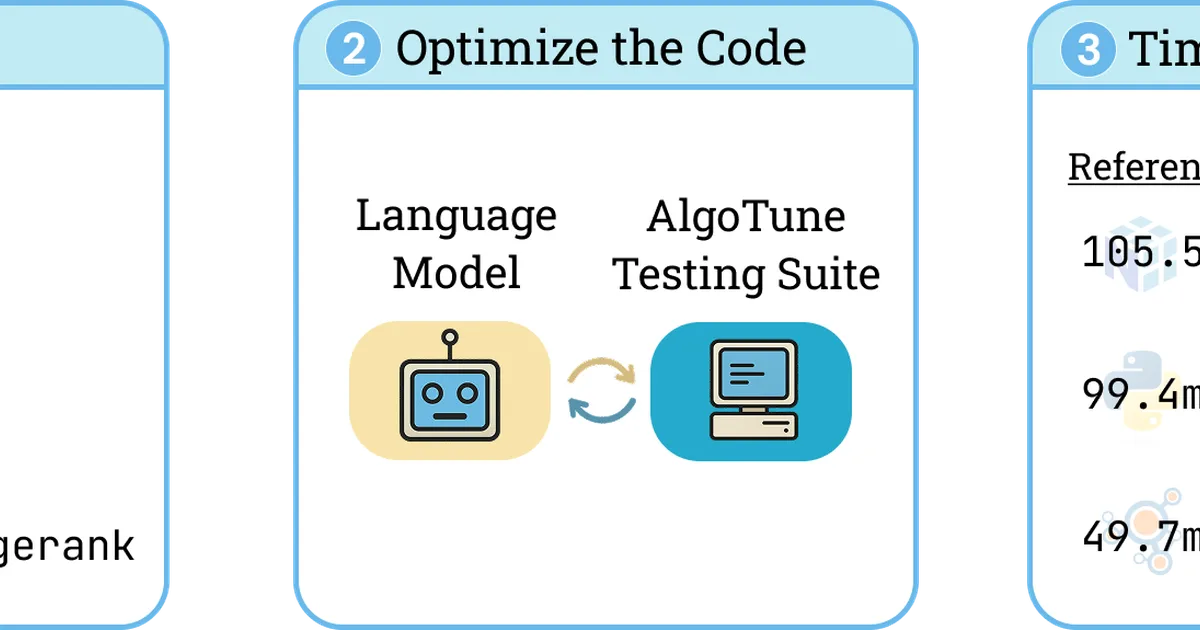
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-09 · 当前星标 ★ 119
核心亮点
- 覆盖数学、物理、CS 多领域,问题多样性高
- 明确要求超越现有实现,直接对标性能优化
- NeurIPS 背书,学术权威性强
不足之处
- 文档/社区待观察
- 基准规模较小(154题),可能不足以全面评估
适用场景
- 算法竞赛选手训练性能优化技巧
- 研究者评估新算法或代码生成模型的效率
- 开发者学习如何针对具体问题调优代码
替代项目
HumanEval、CodeContests、LeetCode Benchmark
上一篇:Auditor
下一篇:GitTaskBench
同类项目推荐
 Omni-SafetyBench
开源
给音视频大模型做安全体检,发现隐藏风险
[ACM MM 2026] Code for paper "Omni-SafetyBench: A Benchmark for Safety Evaluation of···
 PromptInject
开源
模块化组装提示词,量化评估LLM对抗攻击的鲁棒性。
PromptInject is a framework that assembles prompts in a modular fashion to provide a···
 defenseclaw
开源
给自主 AI Agent 套上可审计的安全护栏
Security Governance for Agentic AI
 RAGElo
开源
用 Elo 对战排名,快速选出最强 RAG 智能体
RAGElo is a set of tools that helps you selecting the best RAG-based LLM agents by u···
 appworld
开源
在真实模拟世界里,测试你的 AI 智能体会不会办事。
AppWorld: A Controllable World of Apps and People for Benchmarking Function Calling ···
 hypoarena
开源
埋好因果链的合成文献,用 Elo 赛出谁能挖出真假设
Scientific hypothesis-discovery workbench: grounded hypothesis-evidence graphs, synt···
 napolab
开源
一站式对比葡萄牙语AI模型,掌握最新性能排名
The Natural Portuguese Language Benchmark (Napolab). Stay up to date with the latest···
 TaskMeAnything
开源
自动生成多模态任务,全面评估模型能力
[NeurIPS 2024] A task generation and model evaluation system for multimodal languag···
 FollowBench
开源
用多级细粒度约束,精准测出大模型指令遵循的真实水平
[ACL 2024] FollowBench: A Multi-level Fine-grained Constraints Following Benchmark f···