

VQGAN-CLIP
本地运行 VQGAN+CLIP,文本秒变艺术图像
项目预览
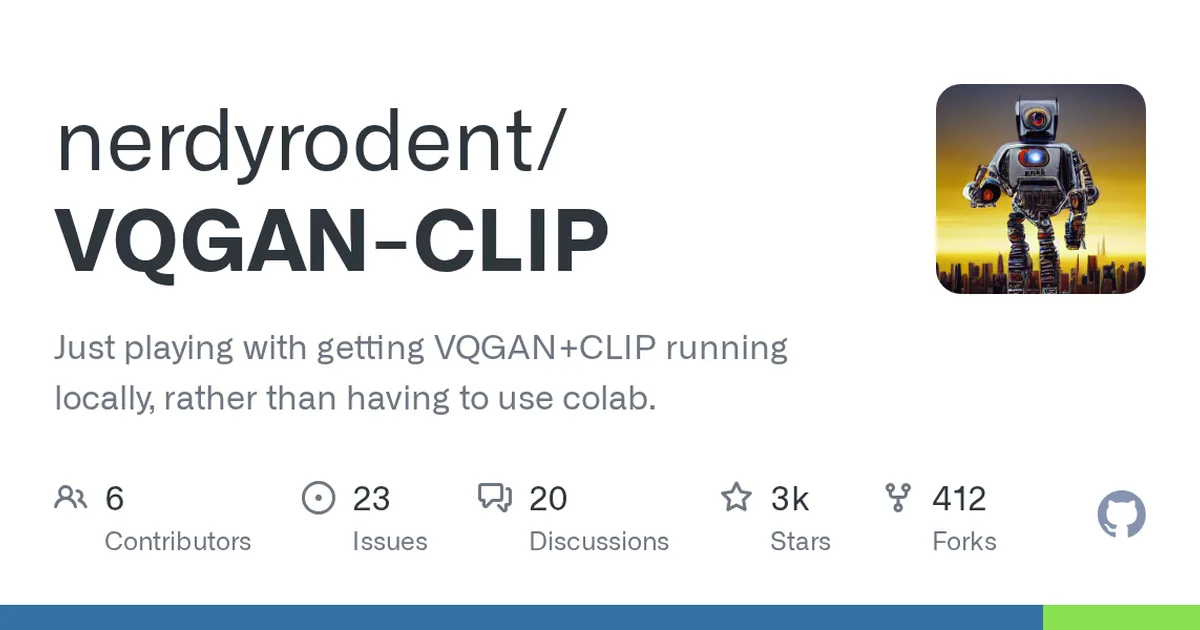
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-09 · 当前星标 ★ 2642
技术标签
使用教程
环境要求
- Ubuntu 20.04(README 测试环境),需具备 NVIDIA 显卡
- 显存要求:380x380 约 8GB、512x512 约 10GB、900x900 约 24GB
- 已安装 Anaconda,用于创建 Python 3.9 虚拟环境
- 需从 GitHub 克隆 CLIP 与 taming-transformers 两个依赖仓库,并下载至少 1 个 VQGAN 预训练模型
安装与启动步骤
-
1创建 conda 环境
使用 Anaconda 创建名为 vqgan 的虚拟环境,Python 版本指定 3.9,与 README 测试环境一致。
conda create --name vqgan python=3.9 -
2激活环境
后续所有安装和运行命令都要在激活后的 vqgan 环境中执行。
conda activate vqgan -
3安装 PyTorch
安装 CUDA 版 PyTorch 及 torchvision、torchaudio。若使用 AMD 显卡,请阅读 README 中的 AMD 章节,勿直接执行此命令。
pip install torch==1.9.0+cu111 torchvision==0.10.0+cu111 torchaudio==0.9.0 -f https://download.pytorch.org/whl/torch_stable.html -
4安装其余依赖
安装 README 列出的其余 Python 包,setuptools 固定为 59.5.0。也可改用仓库的 requirements.txt(含版本号)。
pip install ftfy regex tqdm omegaconf pytorch-lightning IPython kornia imageio imageio-ffmpeg einops torch_optimizer setuptools==59.5.0 -
5克隆仓库与依赖
克隆 VQGAN-CLIP 主仓库,并在其目录内继续克隆 OpenAI 的 CLIP 与 CompVis 的 taming-transformers。
git clone 'https://github.com/nerdyrodent/VQGAN-CLIP' cd VQGAN-CLIP git clone 'https://github.com/openai/CLIP' git clone 'https://github.com/CompVis/taming-transformers' -
6下载 VQGAN 模型
至少需要一个 VQGAN 预训练模型,默认放在 checkpoints 目录下。也可用仓库的 download_models.sh 脚本下载(默认只下一个)。Windows 下 curl 需用双引号。
mkdir checkpoints curl -L -o checkpoints/vqgan_imagenet_f16_16384.yaml -C - 'https://heibox.uni-heidelberg.de/d/a7530b09fed84f80a887/files/?p=%2Fconfigs%2Fmodel.yaml&dl=1' curl -L -o checkpoints/vqgan_imagenet_f16_16384.ckpt -C - 'https://heibox.uni-heidelberg.de/d/a7530b09fed84f80a887/files/?p=%2Fckpts%2Flast.ckpt&dl=1' -
7生成图像
用 -p 指定文本提示词运行 generate.py,即可在本地生成图像。具体参数(步数、学习率、尺寸等)可用 -h 查看脚本帮助。
python generate.py -p "A painting of an apple in a fruit bowl"
关键配置
| 配置项 | 必填 | 说明 | 示例 |
|---|---|---|---|
checkpoints 目录 | 是 | 模型 .yaml 与 .ckpt 文件默认期望存放的位置 | checkpoints/vqgan_imagenet_f16_16384.ckpt |
如何确认成功
python generate.py 成功执行且不报错,并在输出目录生成与提示词对应的图像文件,即为成功。
常见问题
Q:运行时提示 CUDA out of memory 怎么办?
A:说明请求超出显卡显存。按 README 建议减小图像尺寸和/或减少 cuts 数量,例如从 900x900 降到 512x512 或 380x380。
Q:必须克隆 CLIP 和 taming-transformers 吗?
A:README 的开发环境把两者放在本地目录,因此它们不在 requirements.txt / vqgan.yml 中。也可以改为直接 pip install taming-transformers 和 CLIP。
Q:Windows 上 curl 下载模型失败?
A:README 注明 Windows 用户使用 curl 时应改用双引号包裹 URL。
Q:怎么卸载?
A:执行 conda remove --name vqgan --all 删除虚拟环境,再删除 VQGAN-CLIP 目录即可。
Q:用 AMD 显卡怎么办?
A:README 提示存在 AMD 章节,安装 PyTorch 时不要照搬 CUDA 版命令,应参考该章节说明。
注意事项
- README 在 Ubuntu 20.04 + Nvidia RTX 3090 上测试通过,其他环境可能需自行调整
- CLIP 与 taming-transformers 被克隆到主仓库目录内,未列入 requirements.txt 或 vqgan.yml
- 需预先准备至少 1 个 VQGAN 预训练模型,可参考 CompVis/taming-transformers 的预训练模型说明
- README 提供 Linux 与 Windows 的视频教程链接,遇到问题可参考
核心亮点
- 提供本地运行方案,摆脱 Colab 依赖,保护隐私且可离线使用
- 支持灵活调整生成参数,方便探索不同艺术风格
- 代码简洁,易于二次开发和集成到其他项目
不足之处
- 生成图像分辨率较低,细节表现有限
- 文档和示例较少,新手上手门槛较高
适用场景
- 艺术家快速生成灵感草图
- 开发者研究文本到图像生成技术
- 教育场景演示生成模型原理
替代项目
Disco Diffusion、Stable Diffusion、DALL-E 2
上一篇:InfiniteYou
下一篇:big-sleep
同类项目推荐
 ComfyUI
开源
像搭积木一样连节点,生图流程自己搭
The most powerful and modular diffusion model GUI, api and backend with a graph/node···
 AttentionGAN
开源
用注意力机制精准控制图像变换区域,让生成结果更自然
AttentionGAN for Unpaired Image-to-Image Translation & Multi-Domain Image-to-Image T···
 ZPix
开源
本地运行,离线生成和编辑图片,隐私无忧。
A local AI image generator and editor powered by open image models.
 mono-pix
开源
像素图秒变高清真实图,免费且浏览器本地运行
Turn Fake Pixel Art Real — Fast, free, and runs in your browser.
 fastapi_ml_stablediffusion
开源
用 React+FastAPI 快速搭建 Stable Diffusion 文生图应用
A Stable Diffusion Demo with React and FastAPI
 nonebot-plugin-novelai
开源
在QQ群里直接喊话,AI帮你画图
Generate images by Stable-Diffusion-webui Based on Python | 使用Python的基于 SD-webu···
 nano-banana-2-skill
开源
终端一句话出图,还能挂进 Claude Code 工作流
AI image generation CLI powered by Gemini 3 Pro. Green screen transparency, referenc···
 flyreq-image-studio
开源
一个工作台搞定 AI 生图、视频与素材管理,支持自托管和手机端。
AI生图工作台 (AI Image Generator)、视频工作台。支持 Agent 与工作台模式、无限画布、素···
 automatic1111-colab
开源
在 Colab 上点几下,免费跑起 Stable Diffusion WebUI
Using StableDiffusion webui on Colab