

项目预览
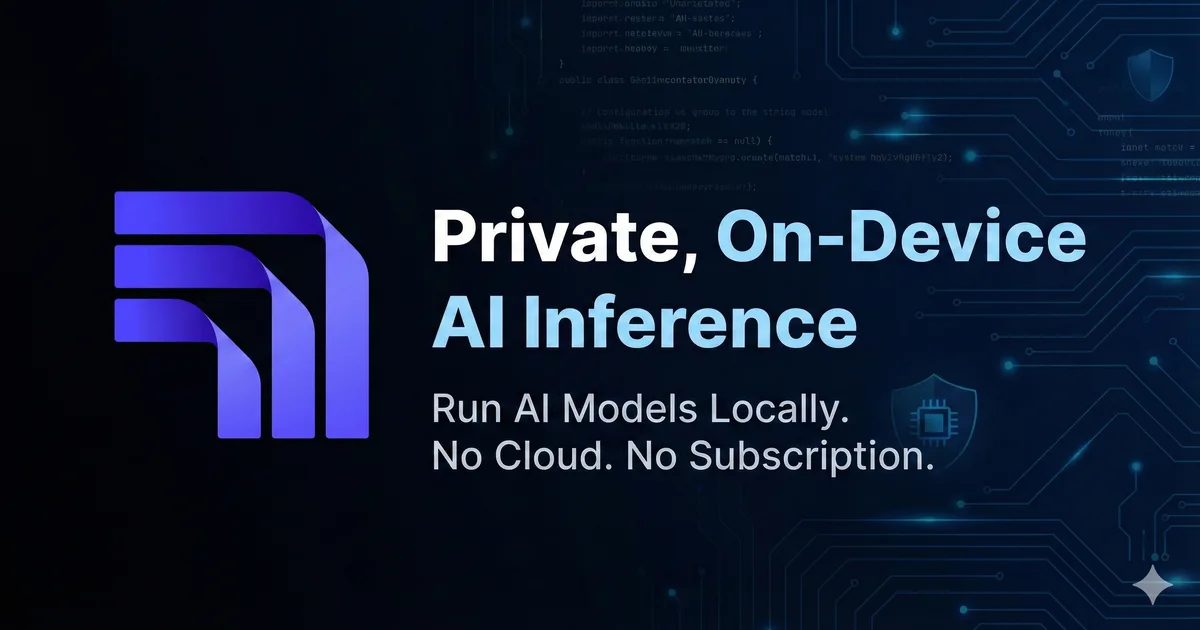
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-10 · 当前星标 ★ 2643
使用教程
环境要求
- Node.js 与 npm(使用 JavaScript SDK 时)
- Python 与 pip(使用 Python SDK 时)
- 本地设备可运行 ONNX Runtime 推理,运行时约 20 MB
- 官方也提供 C#、Rust 语言绑定以及安装包下载
安装与启动步骤
-
1安装 JS SDK
在 Node.js 项目中执行安装,包名 foundry-local-sdk,安装后即可在代码中引入 FoundryLocalManager。
npm install foundry-local-sdk -
2运行 JS 对话示例
把 README 示例存为 js 文件用 Node 运行;会自动按硬件选择最佳模型变体并下载 qwen2.5-0.5b。
import { FoundryLocalManager } from 'foundry-local-sdk'; const manager = FoundryLocalManager.create({ appName: 'my-app' }); // Download and load a model (auto-selects best variant for user's hardware) const model = await manager.catalog.getModel('qwen2.5-0.5b'); await model.download((progress) => { process.stdout.write(`\rDownloading... ${progress.toFixed(2)}%`); }); await model.load(); // Create a chat client and get a completion const chatClient = model.createChatClient(); const response = await chatClient.completeChat([ { role: 'user', content: 'What is the golden ratio?' } ]); console.log(response.choices[0]?.message?.content); // Unload the model when done await model.unload(); -
3安装 Python SDK
使用 pip 安装官方 Python 包 foundry-local-sdk,用于在 Python 应用中调用本地模型推理。
pip install foundry-local-sdk -
4运行 Python 对话示例
把示例保存为 py 文件运行;先初始化 Manager,再从模型目录选取 qwen2.5-0.5b 下载并加载。
from foundry_local_sdk import Configuration, FoundryLocalManager config = Configuration(app_name="foundry_local_samples") FoundryLocalManager.initialize(config) manager = FoundryLocalManager.instance # Select and load a model from the catalog model = manager.catalog.get_model("qwen2.5-0.5b") model.download() model.load() # Get a chat client client = model.get_chat_client() # Create and send message messages = [ {"role": "user", "content": "What is the golden ratio?"} ] response = client.complete_chat(messages) print(f"Response: {response.choices[0].message.content}") model.unload() -
5获取完整安装包
如需完整的本地运行时或非 npm/pip 的安装方式,可从官方下载页获取安装程序,文档见官方文档站。
关键配置
| 配置项 | 必填 | 说明 | 示例 |
|---|---|---|---|
appName | 是 | JavaScript 侧的应用名,用于标识调用方应用 | my-app |
app_name | 是 | Python 侧的应用名,用于初始化 Configuration | foundry_local_samples |
模型 ID | 是 | 从模型目录中选择要下载加载的模型 | qwen2.5-0.5b |
如何确认成功
示例程序控制台打印出模型对 “What is the golden ratio?” 的回答内容,即表示本地推理链路已跑通。
常见问题
Q:使用 Foundry Local 需要 API Key 或联网吗?
A:不需要 API Key、不需要 Azure 订阅,也没有按 token 计费;应用可离线运行,但首次仍需下载所选模型。
Q:可以把 Foundry Local 部署成服务器给多用户用吗?
A:它面向单用户设备端推理,不提供并发排队、连续批处理和 GPU 共享;多用户场景请用 vLLM 或 Triton Inference Server。
Q:支持哪些编程语言?
A:官方提供 C#、JavaScript、Python、Rust 四种原生 SDK,README 的快速开始演示了 JavaScript 和 Python,其余见 samples 目录。
Q:支持哪些 AI 任务?
A:支持 Chat Completions 与 Speech-to-Text 等常见任务,底层通过 ONNX Runtime 执行并自动做硬件加速适配。
Q:数据会上传到云端吗?
A:不会,用户数据始终留在设备本地,响应零网络延迟,没有后端基础设施需要维护。
注意事项
- 运行时体积很小(约 20 MB),便于随应用分发给最终用户。
- 模型首次使用需要下载,示例中用进度回调打印下载百分比。
- 示例代码用完后调用 unload() 释放模型,避免长期占用本地内存与显存。
- 本项目面向硬件受限的单用户设备优化,不适合作为高并发服务端推理栈。
核心亮点
- GPU 加速推理,本地响应快,不依赖网络
- 兼容 Microsoft AI SDK 接口,迁移成本低
- 支持语音转文字和聊天补全,覆盖常见 AI 场景
不足之处
- 文档/社区待观察
- C++ 实现,对非 C++ 开发者上手门槛较高
适用场景
- 数据敏感的企业内部 AI 助手,需本地处理
- 边缘设备上的实时语音交互,如智能家居
- 离线环境下的智能客服或文档问答
替代项目
llama.cpp、Ollama、ONNX Runtime
同类项目推荐
 MegaParse
开源
解析文档零丢失,直接喂给大模型
File Parser optimised for LLM Ingestion with no loss Parse PDFs, Docx, PPTx in a fo···
 a-guide-to-mlops
开源
从传统到现代,一份指南带你玩转MLOps工具链
A simple yet complete guide to MLOps tools and practices - from a conventional way t···
 llm-sandbox
开源
给 LLM 一个安全的代码沙箱,跑 AI 生成的代码不翻车
Lightweight and portable LLM sandbox runtime (code interpreter) Python library.
 kiji-proxy
开源
给 OpenAI 请求加层隐私滤镜,敏感信息不外泄。
Privacy proxy for your OpenAI requests
 Flash-Sparse-Attention
开源
让长序列注意力更快更省,即插即用替换标准注意力
Efficient implementations of Native Sparse Attention
 node-replicate
开源
在 Node.js 里几行代码调用 Replicate 上的 AI 模型
A Node.js client for Replicate.
 unstructured-inference
开源
把杂乱文档解析成带类型的结构化文本块
 Windows-Copilot-API
开源
把 Windows Copilot 变成 OpenAI 兼容接口,开箱即调
Reverse engineered Windows Copilot into an OpenAI-compatible API. Access GPT-4 and G···
 Awesome-Ollama-Server
开源
实时盯住 Ollama 服务,掉线卡顿一眼看到
这是一个用于监控和检测 Ollama 服务可用性和性能的系统。它提供了一个现代化的 Web 界面,···