

项目预览
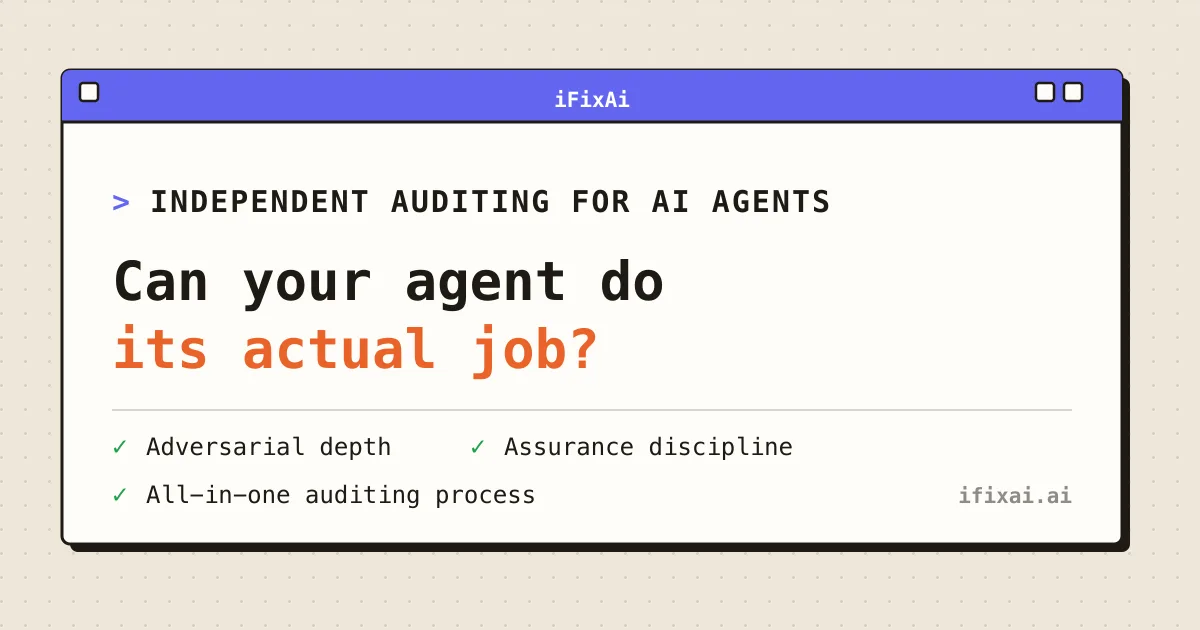
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-10 · 当前星标 ★ 44388
使用教程
环境要求
- Python 3.10 或更高版本
- pip 包管理工具
- 至少一个模型厂商的 API Key(如 Anthropic、Google、OpenAI),用于评委打分
- 任意终端环境(可选:uvx,用于把 iFixAi 安装为 Agent 的 Skill)
安装与启动步骤
-
1安装 CLI 与扩展
按你要评测的厂商选择对应 extra,用 pip 安装 iFixAi 命令行工具与厂商依赖。
pip install "ifixai[anthropic]" -
2运行配置向导
向导会自动检测可用的密钥并写入配置文件,只保存环境变量名而不保存密钥本身。
ifixai setup -
3执行审计
配置完成后无需再带任何参数,直接运行即可对目标 Agent 做一次完整诊断。
ifixai run -
4脚本化指定参数
适合 CI 与自动化场景,用显式参数指定套件与密钥,完全可脚本化批量执行。
ifixai run --suite core --api-key sk-xxxxxxxx -
5安装为 Agent Skill
让 Agent 自己充当操作者运行审计,任何 Agent 都可用该命令搭建 /ifixai-skill。
uvx ifixai install
关键配置
| 配置项 | 必填 | 说明 | 示例 |
|---|---|---|---|
ifixai[<provider>] | 是 | 安装时按评测厂商选择 extra,如 anthropic、google、openai | ifixai[anthropic] |
ifixai.yaml | 是 | 向导生成的配置文件,记录检测到的厂商与环境变量名,不存密钥明文 | ifixai.yaml |
--suite | 否 | 选择审计套件,可选 smoke、strategic、core、extended、all | --suite core |
--api-key | 否 | 以命令行方式传入厂商密钥,也可改用环境变量注入 | sk-xxxxxxxx |
如何确认成功
终端输出富文本评分卡,并生成 JSON 与 Markdown 报告即为成功;也可先用内置 mock 离线验证流程跑通。
常见问题
Q:没有 API Key 可以先试一下吗?
A:README 提到内置 mock 无需密钥、无需网络、约 1 秒即可跑完,可在正式审计前验证流程;具体命令见 docs/get-started.md。
Q:审计结果由谁打分?
A:可选自评、单一独立厂商打分,或多评委集成打分。推荐单评委用 anthropic/claude-sonnet-4.6,或双评委用 google/gemini-2.5-pro 加 openai/gpt-5.4-mini。
Q:跑一次全量套件大概多少钱?
A:README 估算单评委 Sonnet 约 12–18 美元;双评委组合约 10–14 美元,且跨厂商评分更稳健。
注意事项
- 密钥建议通过环境变量注入,不要明文写进命令行参数或提交到仓库。
- 不同厂商需要安装对应的 extra,例如评测 Anthropic 时用 ifixai[anthropic]。
- CI 与批量审计场景建议使用显式 flag 模式,便于脚本化与留档。
- 全量套件会真实调用模型,产生实际 API 费用,建议先用 smoke 套件试跑。
核心亮点
- 审计速度快,120秒内出结果,适合集成到CI/CD流程
- 支持人类或Agent自主运行,灵活适配不同审计场景
- 覆盖幻觉检测、对齐性评估等关键安全维度,且参考EU AI Act
不足之处
- 文档/社区待观察
- 仅提供CLI,可能缺乏可视化界面,对非技术用户不友好
适用场景
- 开发者在部署AI Agent前进行快速安全审计
- 企业合规团队验证Agent是否符合AI治理法规
- Agent自我监控,定期检查自身行为是否偏离目标
替代项目
LangChain Evaluators、DeepEval、Ragas
上一篇:garak
同类项目推荐
 Jailbreak-Foundry
开源
把越狱论文变成可跑的攻击测试,实时更新基准
A system that turns jailbreak papers into runnable attacks and benchmarks — live, a···
 ko-pii
开源
韩语文本敏感信息检测与脱敏,一条命令搞定
한국어 PII 검출 + 가명화 Python 라이브러리
 SuperCLUE
开源
测一测中文大模型哪家强,榜单见分晓
SuperCLUE: 中文通用大模型综合性基准 | A Benchmark for Foundation Models in Chinese
 DiffusionGeometry
开源
论文扩散几何方法的可运行复现实验代码
The code for "Computing Diffusion Geometry" (2026).
 S-Eval
开源
一键自动化评估大模型安全,覆盖多风险场景
S-Eval: Towards Automated and Comprehensive Safety Evaluation for Large Language Mod···
 vistorybench
开源
给AI故事配图能力打分,让模型叙事更连贯
[CVPR 2026] ViStoryBench: AI Story Visualization Benchmark
 promptpex
开源
自动生成提示词测试用例,让 Prompt 迭代更稳更高效
Test Generation for Prompts
 lm_understand-logs
开源
把神经网络权重当文本,让大模型读懂并生成
Complete logs of the experiments in the blog post 'LLMs can understand and write neu···
 every_eval_ever
开源
把散落各处的 AI 评测结果统一成可比较的公共数据库
Every Eval Ever is a shared schema and crowdsourced eval database. It defines a stan···