

项目预览
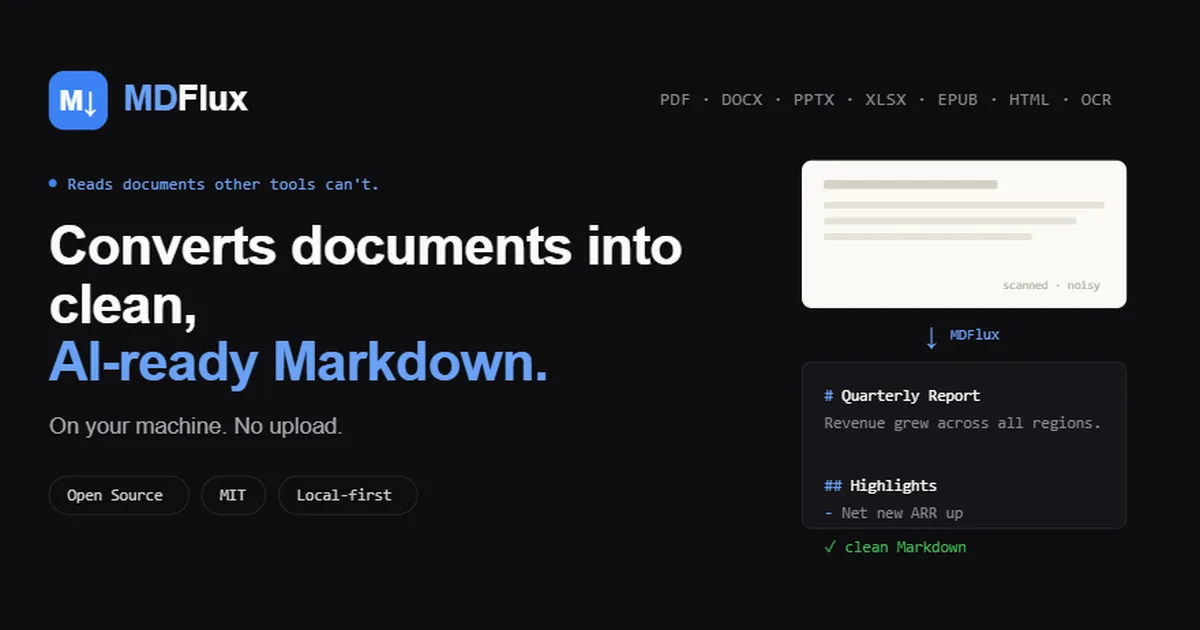
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-09 · 当前星标 ★ 586
技术标签
使用教程
ℹ 本教程由 AI 依据该项目 README 整理,个别步骤可能需要按你的环境微调。
环境要求
- Python 环境
- 扫描版 PDF
安装与启动步骤
-
1看它读什么
主打扫描版 PDF,先转成结构化文本再喂模型。
-
2装依赖
Python 项目,装完先跑一次自检。
pip install -r requirements.txt -
3转一份扫描件
拿一页清晰扫描件试,确认文字提取完整。
-
4比 token 消耗
同一份文档与视觉模型对比,看省了多少。
如何确认成功
一份 20 页扫描 PDF 转出的文本能覆盖正文要点,token 消耗明显低于直接把图喂给视觉模型
注意事项
- 它是文档预处理,不替代 OCR 服务。
- 扫描质量差时提取会明显下降。
- 省 token 的代价是多一步转换。
- 表格与多栏排版是弱项。
核心亮点
- 本地离线运行,文档不离开电脑,隐私安全
- 批量处理文件夹,效率高,适合大量文档
- token 消耗远低于视觉模型,省钱且输出更结构化
不足之处
- 早期项目,功能稳定性待验证
- 文档/社区待观察
适用场景
- 个人知识库构建:将纸质书扫描件转为 Markdown 存入笔记系统
- 企业文档数字化:批量处理合同、发票等扫描档案
- AI 数据预处理:为 LLM 训练或 RAG 准备干净文本
替代项目
OCRmyPDF、PaddleOCR、Mathpix
上一篇:humla
同类项目推荐
 tools
开源
浏览器打开就能用的小工具百宝箱,零安装零登录
Assorted useful tools, almost entirely generated using LLMs
 DataInfra-RedactionEverything
开源
本地大模型自动识别并遮盖文档图片里的敏感信息
DataInfra Series. Redact EVERYTHING with local llms and vlms.
 llama-scan
开源
本地大模型把扫描 PDF 转成可编辑文本
Transcribe PDFs with local LLMs
 pdfparser
开源
纯 PHP 从 PDF 里抽文本、Markdown 和图片,快且省内存
PHP library to read and extract text, markdown & images from PDFs - Fast & Low memor···
 crumbs
开源
把缩进文本一键变成思维导图,告别手动绘图。
Turn asterisk-indented text lines into mind maps
 docling-Studio
开源
浏览器里调文档解析,边看边界框边入库建 RAG
Visual document analysis studio powered by Docling — configure the extraction pipel···
 wordcraft
开源
用纯 Rust 重写 Word,开源免费跨平台
WordCraft: an open-source, clean-room word processor in pure Rust
 gridcraft
开源
纯 Rust 写的 Excel,安全又轻快
GridCraft: an open-source, clean-room spreadsheet in pure Rust. By ArtCraft.
 chatgpt-timestamp-extension
开源
给ChatGPT每条消息加上时间戳,对话时间一目了然
Free, open-source Chrome and Firefox extension to show local dates and times on Chat···