

exercises-dataset
一键接入1324个健身动作数据,快速构建专业健身应用
项目预览
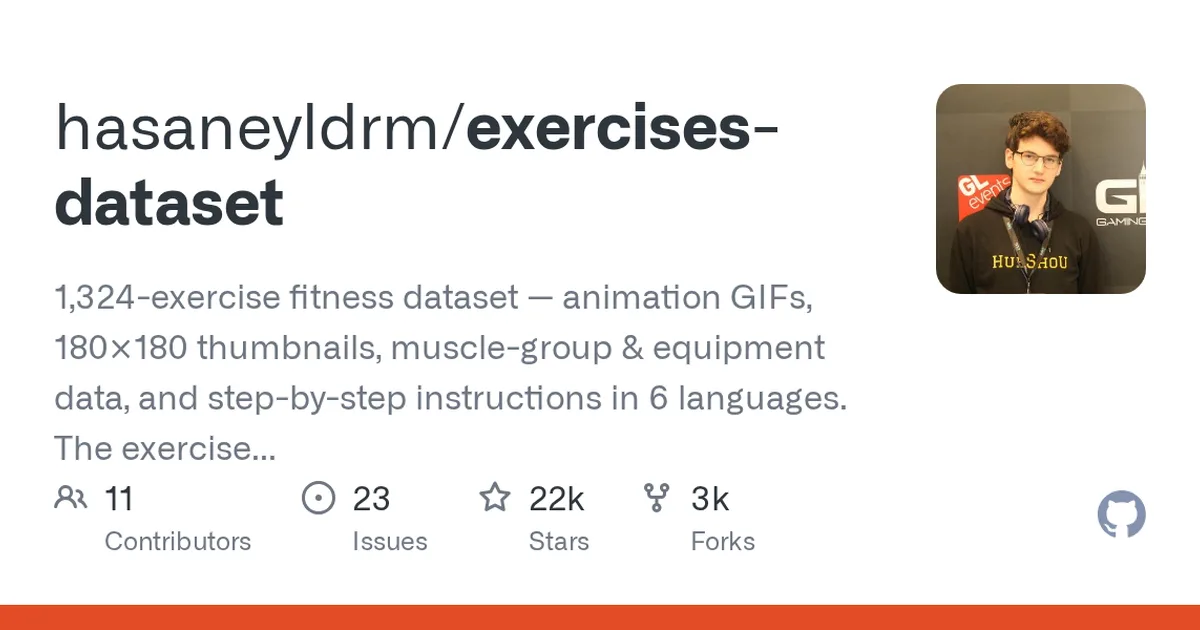
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-10 · 当前星标 ★ 23684
技术标签
使用教程
ℹ 本教程由 AI 依据该项目 README 整理,个别步骤可能需要按你的环境微调。
环境要求
- 现代浏览器(Chrome/Edge/Firefox 等),用于打开仓库内的 HTML 工具
- 任意能读取 JSON 与图片的开发环境(如 React Native / Node.js 后端)
- 磁盘空间用于存放 1,324 个动作的 GIF 与 180×180 缩略图
安装与启动步骤
-
1克隆仓库
把数据集仓库下载到本地,得到 JSON 数据、图片资源和两个 HTML 工具页面。
git clone https://github.com/hasaneyldrm/exercises-dataset -
2打开交互浏览器
直接双击打开 index.html,无需启动任何服务器。页面会展示每个动作的缩略图、动画 GIF、元数据和指导说明。
-
3生成建表 SQL
打开 setup.html,在 Database Setup 中选择 SQL Server、PostgreSQL、MySQL 或 SQLite,浏览器内生成含 1,324 条 INSERT 的 .sql 文件。
-
4复制接口调用示例
在 setup.html 的 API Integration 中填入自己的后端 base URL,即可实时获得 JavaScript、Python、C#、Java、PHP、Go、cURL 的调用示例代码。
-
5在代码中引入数据
按 README 示例从本地 JSON 导入动作数组,字段包含 name、category、equipment、instructions、gif_url 等。
import exercises from "./data/exercises.json";
关键配置
| 配置项 | 必填 | 说明 | 示例 |
|---|---|---|---|
base_url | 是 | 你的后端接口地址,填入 setup.html 后所有示例代码同步更新。 | https://api.example.com |
数据库类型 | 是 | 在 setup.html 的 Database Setup 中选择,决定生成的建表语句方言。 | PostgreSQL |
attribution | 否 | 数据中每个动作自带的媒体署名信息,展示时建议保留。 | Gym visual |
如何确认成功
用浏览器打开 index.html,能看到动作列表、180×180 缩略图与动画 GIF 正常显示即表示可用。
常见问题
Q:需要安装依赖或启动服务吗?
A:不需要。README 明确说明这两个 HTML 工具无需服务器,直接在浏览器打开即可。
Q:如何得到全部 1324 条数据的 INSERT 语句?
A:打开 setup.html 的 Database Setup,选择目标数据库,在浏览器中生成可直接运行的 .sql 文件。
Q:支持哪些语言的说明文案?
A:每个动作含英、西、意、土、俄、中、印地、波、韩、法共 10 种语言的逐步指导。
Q:动作图片和 GIF 能直接商用吗?
A:媒体版权归 Gym visual,README 要求查看 License & Use 章节,按授权条款使用。
注意事项
- 仓库以数据与静态 HTML 为主,无依赖安装步骤,不要自行添加包管理命令。
- 使用前请阅读 License & Use 章节,媒体素材版权归 Gym visual。
- 数据字段与取值以仓库内实际 JSON 文件为准,示例代码仅供类型参考。
核心亮点
- 数据规模大且结构化:1324个动作,涵盖肌群、器械、动画等多维度字段,JSON格式易于解析
- 多语言支持完善:6种语言的指导说明,降低全球化健身App的本地化成本
- 配套可视化素材:每个动作自带GIF和缩略图,可直接用于UI展示,省去素材制作时间
不足之处
- 数据更新频率未知,可能无法及时涵盖新兴健身动作
- 文档/社区待观察
适用场景
- 健身类App开发:快速搭建动作库和训练计划功能
- 健身教学平台:提供多语言的动作指导内容
- 数据科学研究:分析健身动作分类、肌群关联等
替代项目
wger-project/exercises、yuhonas/free-exercise-db、exercemus/exercise-db
同类项目推荐
 datasets
开源
一行代码加载海量数据集,高效处理 AI 数据
The largest hub of ready-to-use datasets for AI models with fast, easy-to-use and ef···
 DPSDA
开源
不训练模型,也能生成高质量差分隐私合成数据
Private Evolution: Generating DP Synthetic Data without Model Training [ICML 2026, I···
 DataProfiler
开源
快速摸清数据底细,自动识别敏感信息
What's in your data? Extract schema, statistics and entities from datasets
 LongICLBench
开源
测出长上下文模型在超长输入下的真实学习能力
Code and Data for "Long-context LLMs Struggle with Long In-context Learning" [TMLR20···
 awesome-industrial-datasets
开源
工业AI找数据,一页清单直接定位可用数据集
A curated collection of public industrial datasets.
 awesome-legal-data
开源
法律文本数据集一页汇总,省去全网搜数据时间
A collection of datasets and other resources for legal text processing.
 distilabel
开源
基于论文的合成数据流水线,快速生成高质量 AI 反馈数据。
Distilabel is a framework for synthetic data and AI feedback for engineers who need ···
 awesome-matchem-datasets
开源
材料化学数据集一网打尽,找数据不再东翻西找
 nepali-datasets
开源
尼泊尔语AI数据一页找齐,省去全网翻找
A comprehensive, curated collection of Nepali datasets aggregated from community sou···