
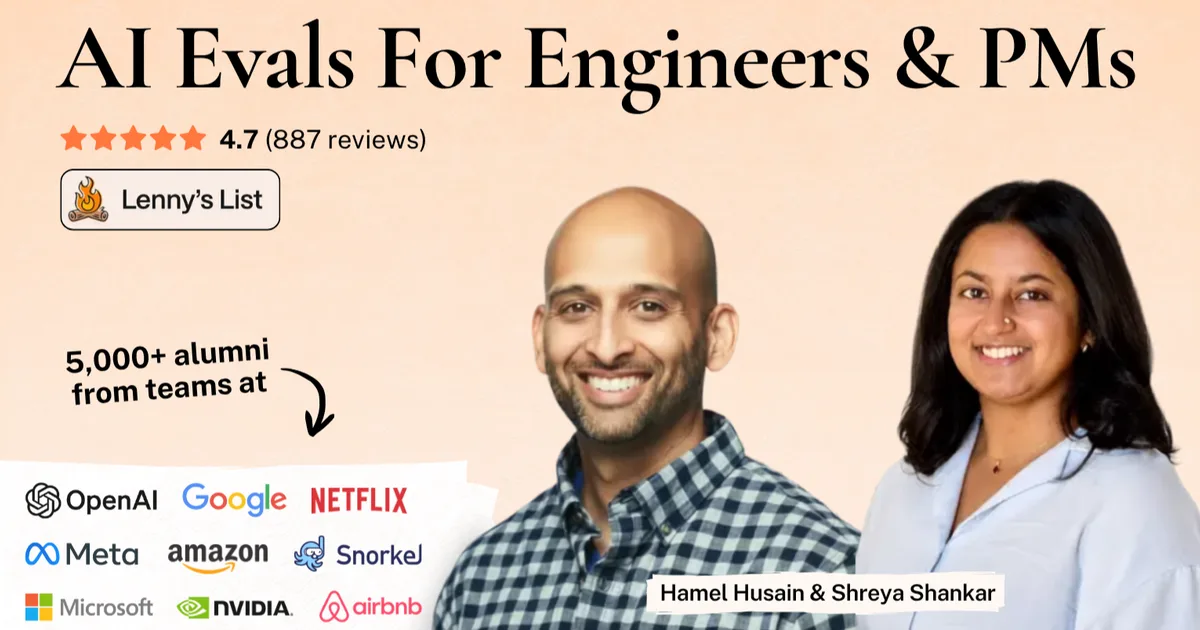
项目预览
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-09-14 · 当前星标 ★ 1675
使用教程
环境要求
- Claude Code(使用 /plugin 方式安装时需要)
- Node.js 环境,可用 npx 命令(使用 npx skills 方式时需要)
- 可访问 GitHub 的网络环境
安装与启动步骤
-
1注意仓库已迁移
本仓库已废弃,官方技能已迁移到 ai-evals-course/evals-skills 插件,建议直接用新地址安装。
-
2注册插件市场
在 Claude Code 中执行,把 hamelsmu/evals-skills 注册为插件来源仓库。
/plugin marketplace add hamelsmu/evals-skills -
3安装插件
仍在 Claude Code 中执行,安装 evals-skills 插件本体。
/plugin install evals-skills@hamelsmu-evals-skills -
4重启 Claude Code
安装完成后必须重启 Claude Code,插件中的技能才会加载生效。
-
5npx 方式安装
不使用 Claude Code 插件时,可通过开放 Skills CLI 从 GitHub 仓库安装。
npx skills add https://github.com/hamelsmu/evals-skills -
6只装单个技能
只想安装 eval-audit 这一个技能时,加 --skill 参数指定技能名。
npx skills add https://github.com/hamelsmu/evals-skills --skill eval-audit -
7运行评测审计
在 Claude Code 中对你的评测流程调用 eval-audit 技能,逐项排查并汇总报告。
/evals-skills:eval-audit
如何确认成功
重启 Claude Code 后,输入 / 能看到 /evals-skills:<skill-name> 形式的技能,并能成功调用 eval-audit。
常见问题
Q:原仓库 hamelsmu/evals-skills 还能用吗?
A:该仓库已标记废弃,技能迁移到 ai-evals-course/evals-skills,官方推荐直接安装新仓库版本。
Q:不装 Claude Code 插件可以用吗?
A:可以。使用开放 Skills CLI,执行 npx skills add 从仓库地址安装即可。
Q:如何升级已安装的插件或技能?
A:插件方式执行 /plugin update evals-skills@hamelsmu-evals-skills;npx 方式执行 npx skills check 再 npx skills update。
Q:安装后技能没有出现怎么办?
A:确认安装命令执行成功,并重启 Claude Code;技能会以 /evals-skills:<skill-name> 形式出现。
注意事项
- 本仓库已废弃,技能已迁移至 ai-evals-course/evals-skills,建议优先使用新地址安装。
- 插件安装完成后必须重启 Claude Code 才会加载技能。
- eval-audit 不是完整解决方案,但能发现评测中的常见问题,并推荐其他技能来修复。
核心亮点
- 与课程内容强绑定,方法论到实操的路径清晰,适合边学边用
- 把评测拆成可复用技能模块,便于团队按环节逐步引入而非一次性重构
- 面向工程师和 PM 双角色设计,有助于产品与研发对齐评测标准
不足之处
- 项目以课程配套技能为主,缺少开箱即用的完整评测平台或自动化流水线
- 语言和技术栈信息不明确,实际落地时需要自行适配现有工程环境
适用场景
- 团队要为 RAG 问答产品建立上线前的质量回归测试
- PM 想把用户反馈中的主观问题转化为可量化的评测维度
- 工程师在课程学习后,需要一套可复用的评测用例与评分器模板
替代项目
promptfoo、DeepEval
上一篇:inspect_evals
下一篇:gbrain-evals
同类项目推荐
 botsim
开源
自动仿真对话,快速揪出聊天机器人短板
BotSIM - a data-efficient end-to-end Bot SIMulation toolkit for evaluation, diagnosi···
 python-sdk
开源
官方 Python 客户端,几行代码接入标准化 AI 评测
The official Python SDK for Eval Protocol
 hallucination-leaderboard
开源
看哪个大模型摘要最不容易瞎编
Leaderboard Comparing LLM Performance at Producing Hallucinations when Summarizing S···
 aiewf-eval
开源
专测大模型长上下文下的安全表现
A long-context eval
 WorfBench
开源
给AI工作流生成能力打分,让模型编排更靠谱
[ICLR 2025] Benchmarking Agentic Workflow Generation
 crust
开源
给 AI Agent 装上行为拦截闸,危险操作发生前就挡住
Open Source AI Agent Security Infrastructure — intercepts and blocks dangerous agen···
 Jailbreaks-GPT-Gemini-deepseek-
开源
多模型越狱提示样本库,用于安全评测对比
Jailbreaks GPT, Sora, Claude, Gemini ,deepseek this prompt unlocks rage mode
 opencompass
开源
一站式评测大模型,百个数据集横向对比,快速选出最强模型。
OpenCompass is an LLM evaluation platform, supporting a wide range of models from Op···
 harbor-cookbook
开源
照着示例搭 agent 评测与调优闭环
Realistic examples of building evals and optimizing agents with Harbor