
项目预览
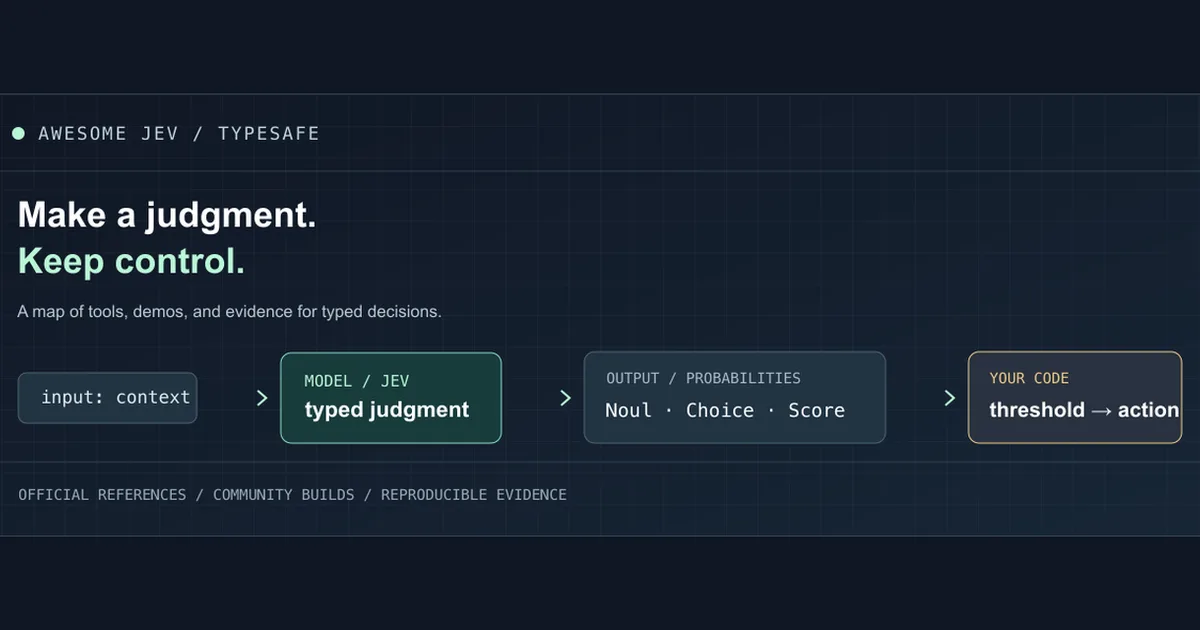
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-10-25 · 当前星标 ★ 605
核心亮点
- 把 SDK、演示、Agent 工具和独立评测集中索引,省去零散搜索
- 每项资料标注来源,便于回溯核实而非纯二手转述
- 以 HTML 静态页呈现,浏览门槛低,适合快速通读
不足之处
- 本质是清单页,不含可复用代码或模型实现
- 内容依赖人工维护,更新频率与覆盖面待观察
适用场景
- 调研 TypeSafe System One 模型能力边界
- 为 Agent 项目选型时对比第三方评测结论
- 给团队做技术分享时快速整理参考资料
替代项目
awesome-llm、awesome-ai-agents、Awesome-LLM-App
下一篇:没有了!
同类项目推荐
 prompttools
开源
一键对比测试提示词,选对模型和参数不再靠猜
Open-source tools for prompt testing and experimentation, with support for both LLMs···
 promptmap
开源
给 LLM 应用做安全体检,防提示注入攻击
a security scanner for custom LLM applications
 HallusionBench
开源
测出多模态模型的视觉幻觉,看清谁在瞎猜
[CVPR'24] HallusionBench: You See What You Think? Or You Think What You See? An Imag···
 DeepSec
开源
AI 写码,DeepSec 把关,实时防漏洞,自动测安全。
DeepSec — AI Security Offense & Defense Platform. Shield audits AI-generated code f···
 VBench
开源
给视频生成模型打分,16个维度看清谁强谁弱
[CVPR2024 Highlight] VBench - We Evaluate Video Generation
 InferenceX
开源
多模型多硬件推理压测,一键跑出可比性能数据
Open Source AI Accelerator Research Platform Standard / 开源推理研究平台
 foundation-model-benchmarking-to···
开源
在 AWS 上跑任意模型,一键测出性能选型最优解
Foundation model benchmarking tool. Run any model on any AWS platform and benchmark ···
 VLABench
开源
一站式公平评测VLA与具身智能模型,让模型实力一目了然
A large-scale benchmark for evaluating vision-language-action models, embodied agent···
 clawseccheck
开源
给 OpenClaw 智能体做安全体检,一键出 A-F 安全分。
Local, read-only security audit for your OpenClaw agent. Finds config, prompt-inject···