

项目预览
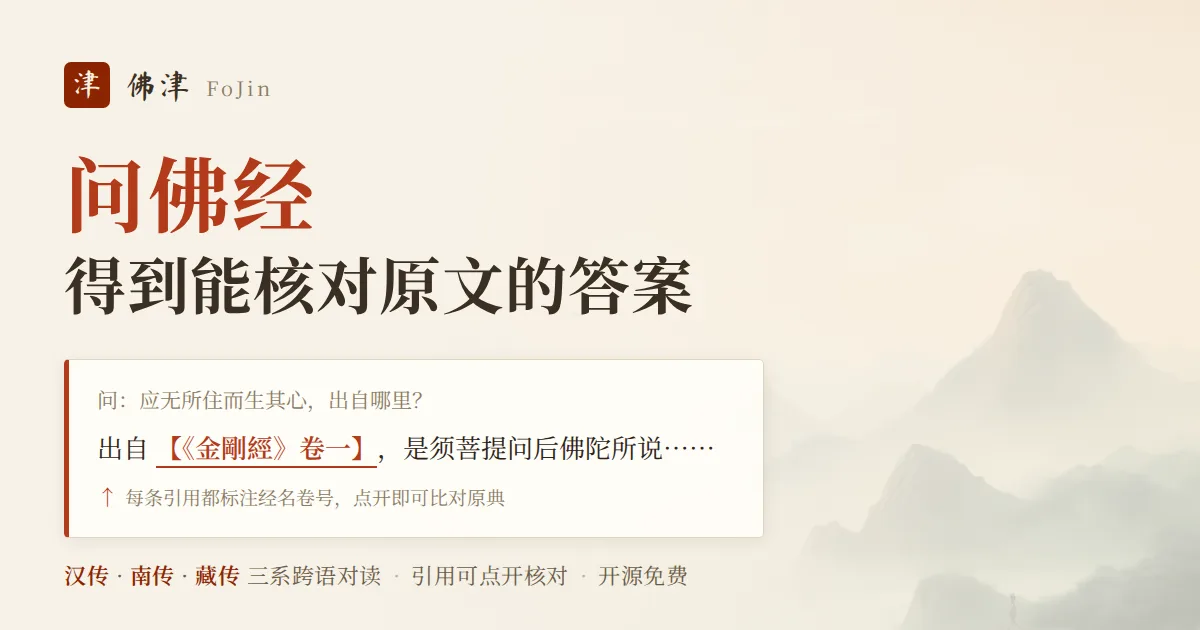
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-09 · 当前星标 ★ 359
使用教程
ℹ 本教程由 AI 依据该项目 README 整理,个别步骤可能需要按你的环境微调。
环境要求
- Docker 与 Compose
- 16GB 内存以上
- 经藏 XML 数据
- 嵌入模型
安装与启动步骤
-
1起服务
克隆后直接起容器,数据库迁移会自动跑
git clone https://github.com/xr843/fojin.git && cd fojin && docker compose up -d -
2导目录
把经藏目录导进去,先有目录再有正文
docker exec fojin-backend python scripts/import_catalog.py -
3导正文
按 XML 目录批量导入正文,耗时较长
docker exec fojin-backend python scripts/import_content.py --all --xml-dir /data/xml-p5 -
4生成向量
为正文生成嵌入,之后才能检索
docker exec fojin-backend python -m scripts.archive.misc.generate_embeddings --source cbeta
如何确认成功
问一句经文出处,助手能给出带出处的回答,点开能定位到具体卷次。
注意事项
- 这是古籍检索增强系统,不是通用问答机器人。
- 导入全量数据耗时以小时计,先把小样本跑通再全量。
- 向量生成最吃资源,纯 CPU 会很慢。
- 回答的准确性取决于语料完整性,缺卷就会答偏。
- 另有免安装的命令行版本,可先用它试检索效果。
核心亮点
- 数据规模可观:超 1 万篇文本和 600+ 来源,覆盖面广
- 三语对照和跨经典检索,适合比较研究
- 集成 RAG 问答和知识图谱,降低使用门槛
不足之处
- 早期项目,文档和社区生态待观察
- 依赖外部数据源,文本质量与版权需自行评估
适用场景
- 佛学研究中的跨语言经典对照与检索
- 佛教知识库的智能问答应用开发
- 数字人文领域的文本数据挖掘与分析
替代项目
BuddhaNexus、SuttaCentral、CBETA
上一篇:rag-all-in-one
下一篇:go-rag
同类项目推荐
 Medical-Graph-RAG
开源
让医疗AI回答有据可查,告别凭空捏造
A Graph RAG System for Evidenced-based Medical Information Retrieval [ACL 2025]
 HilbertRaum
开源
断网也能问 AI,本地维基百科直接答
AI, fully local on your computer.
 rag-all-in-one
开源
一站式搞定 RAG 应用开发,从入门到落地少走弯路
Guide to Building RAG (Retrieval-Augmented Generation) Applications
 nosia
开源
自托管 AI 知识库,私有部署 RAG 问答
Self-hosted AI RAG + MCP Platform
 needle-mcp
开源
给大模型装个长期记忆,私有知识秒级检索
Find perfect leads and run outreach campaigns on Linkedin, email, Instagram and more···
 CHRONOS
开源
让AI自动梳理新闻事件,按时间线生成摘要
Repo for NAACL 2025 Paper "Unfolding the Headline: Iterative Self-Questioning for Ne···
 Aix-DB
开源
一句话问数据,自动出图出结论
Aix-DB 基于 LangChain/LangGraph 框架,结合 MCP Skills 多智能体协作架构,实现自然语言···
 rag-search
开源
快速搭建语义搜索 API,让应用具备私有知识问答能力
RAG Search API
 pdfstract
开源
把 PDF 变成可检索的向量,RAG 预处理一步到位。
PDFStract - Extract, Chunking and Embedding Layer in Your RAG Pipeline - Available a···