
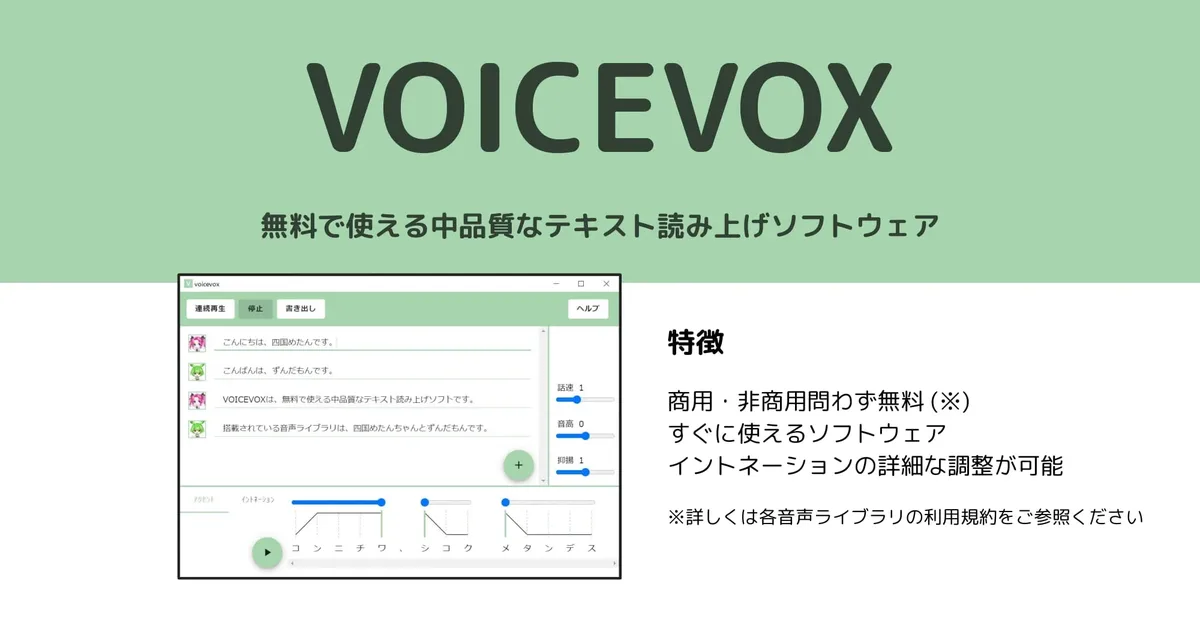
项目预览
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-10-27 · 当前星标 ★ 1147
使用教程
⚠ 本教程由 AI 依据该项目 README 整理;原始文档不完整,部分步骤为通用流程推断,实际安装请以项目官方文档为准。
⚠ 该项目 README 未提供完整安装说明,以下步骤为通用流程,请以官方文档为准。
环境要求
- 从 Releases 获取与操作系统、CPU 架构匹配的预编译库
- Python 方式需具备可安装 .whl 的 Python 环境
- C++ 示例需按目录说明准备 CMake 或 Visual Studio 环境
- 按用户指南和示例目录 README 准备运行所需文件
安装与启动步骤
-
1选择接口
按项目选择 Python wheel 或 C API 动态库;前者适合 Python 应用,后者供 C/C++ 等调用。
-
2下载预编译库
到 GitHub Releases 下载与系统架构匹配的 .whl,或 .so/.dll/.dylib。
-
3安装 Python 包
如使用 Python API,用 pip 安装已下载的 wheel 文件;具体文件名以 Releases 为准。
-
4阅读用户指南
查看 docs/guide/user/usage.md,按其中说明准备运行所需文件与调用方式。
-
5运行示例
进入 example/python、example/cpp/unix 或 example/cpp/windows,按各自 README 执行。
-
6验证合成
按示例完成一次文本转语音,能输出可播放音频即表示库加载与推理正常。
如何确认成功
按示例 README 运行示例,成功生成并播放语音即表示启动成功。
常见问题
Q:应该选 Python 还是 C API?
A:README 提供 Python wheel 和 C 动态库;Python 项目优先 wheel,其他语言可用 C API 或社区绑定。
Q:找不到安装命令怎么办?
A:README 将详细步骤放在用户指南和示例目录 README;按对应目录说明执行,不要自行猜测参数。
Q:示例运行失败先查什么?
A:确认下载的库与系统架构、Python 版本匹配,并已按示例目录 README 准备所需文件。
Q:是否必须自行训练模型?
A:不需要自行训练模型,使用发布包中的库并按示例接入即可。
注意事项
- README 未给出具体 pip 包名、端口或路径,教程不虚构这些值。
- 预编译库分 C API 与 Python API,下载时注意平台和架构。
- 示例代码的执行方式以各 example 目录内 README 为准。
核心亮点
- Rust 实现核心推理,性能与内存控制较好,便于跨平台嵌入
- 提供 C/Python 等多语言绑定,集成成本低
- 音色与韵律参数可调,支持多角色切换,适合游戏与内容创作
不足之处
- 主要面向日语,其他语种支持有限
- 需自行准备并管理模型文件,首次部署有一定门槛
- 文档以日文为主,中文/英文资料较少
适用场景
- 游戏或视觉小说中的角色语音实时合成
- 视频与有声内容批量生成日语旁白
- 桌面辅助工具为视障用户朗读日文文本
替代项目
Open JTalk、Piper、Coqui TTS
上一篇:noise-suppression-for-voice
下一篇:没有了!
同类项目推荐
 Awesome-Text-to-Speech
开源
一份清单,带你速览 TTS 最新工具和模型,少走弯路。
A curated list of the latest and most influential tools, models, and resources in th···
 KAN-TTS
开源
快速搭建定制语音合成系统,开箱即用
KAN-TTS is a speech-synthesis training framework, please try the demos we have poste···
 mmt
开源
用 Transformer 一键生成多轨协调的完整音乐
Official Implementation of "Multitrack Music Transformer" (ICASSP 2023)
 LA-Studio
开源
本地跑通语音克隆和翻译,一站式测试音频模型
LA Studio is a local-first AI audio platform for exploring, downloading, and testing···
 Cognitive-Speech-TTS
开源
微软官方TTS示例,快速实现文本转高质量语音
Microsoft Text-to-Speech API Samples
 Multilingual_Text_to_Speech
开源
一个模型搞定多语言混合语音合成,还能克隆声音
An implementation of Tacotron 2 that supports multilingual experiments with paramete···
 wyoming-piper
开源
把 Piper 接入 Home Assistant,本地离线合成语音
Wyoming protocol server for Piper text to speech system
 cs224n-gpu-that-talks
开源
用注意力机制端到端合成语音,简化传统TTS流程
Attention, I'm Trying to Speak: End-to-end speech synthesis (CS224n '18)
 STYLER
开源
快速且可控地合成富有表现力的语音,风格随心调。
Official repository of STYLER: Style Factor Modeling with Rapidity and Robustness vi···