

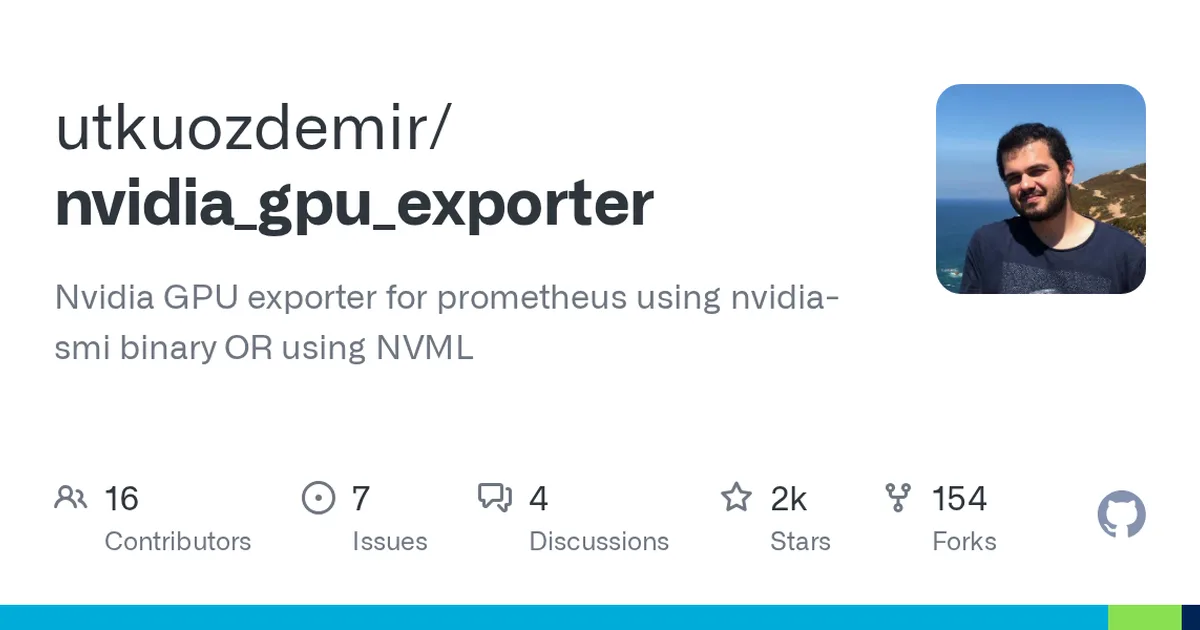
nvidia_gpu_exporter
一条命令把 NVIDIA GPU 监控接入 Prometheus,实时掌握显卡状态。
项目预览
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-09 · 当前星标 ★ 1584
使用教程
环境要求
- Linux 机器(README 快速开始针对 Linux)
- 已安装 NVIDIA 驱动
- 已安装 NVIDIA Container Toolkit
- 可访问 Docker Hub 或 GHCR 拉取镜像
安装与启动步骤
-
1确认前置环境
在一台已装 NVIDIA 驱动和 NVIDIA Container Toolkit 的 Linux 机器上操作,否则容器无法识别 GPU。
-
2启动导出器容器
后台运行官方镜像,暴露 9835 端口,并把 GPU 与工具能力传给容器,重启策略为 unless-stopped。
docker run -d --name nvidia_gpu_exporter --restart unless-stopped --gpus all -e NVIDIA_DRIVER_CAPABILITIES=utility -p 9835:9835 utkuozdemir/nvidia_gpu_exporter:latest -
3验证指标输出
请求本地 9835 端口的 /metrics,看到 Prometheus 文本格式的 GPU 指标说明采集成功。
curl http://localhost:9835/metrics -
4无 GPU 时用演示后端
手头没有 GPU 可用 demo 后端输出合成的真实感指标,便于先打通 Prometheus 链路。
nvidia_gpu_exporter --collect.backend demo -
5按平台补充安装
Windows、macOS、Kubernetes、deb/rpm 包或裸机二进制安装,均按官方 INSTALL.md 与 Helm chart 操作。
关键配置
| 配置项 | 必填 | 说明 | 示例 |
|---|---|---|---|
-p 9835:9835 | 是 | 映射容器端口,Prometheus 从该端口抓取指标 | 9835:9835 |
NVIDIA_DRIVER_CAPABILITIES | 是 | 授予容器使用 nvidia-smi 所需的驱动能力 | utility |
--gpus all | 是 | 把宿主机全部 GPU 暴露给容器 | all |
如何确认成功
执行 curl http://localhost:9835/metrics,返回 Prometheus 文本格式的 GPU 指标即启动成功。
常见问题
Q:没有 NVIDIA GPU 能跑起来吗?
A:可以。使用 --collect.backend demo 启动,会在任意机器上输出合成的仿真指标,方便先验证采集链路。
Q:Windows 或 macOS 怎么安装?
A:官方 INSTALL.md 覆盖各平台:Windows 支持 winget、Scoop、原生服务或一键脚本,macOS 也有对应说明,无需 Docker。
Q:容器启动后抓不到 GPU 指标怎么办?
A:先确认宿主机已装 NVIDIA 驱动与 NVIDIA Container Toolkit,并且运行容器时带了 --gpus all 和 NVIDIA_DRIVER_CAPABILITIES=utility。
Q:如何调整采集行为或过滤指标?
A:具体配置项见官方 CONFIGURE.md 文档,README 未列全部参数,请以该文档为准。
注意事项
- README 明确说明这是作者业余维护的 side project,issue 和 PR 可能响应很慢。
- 除 Docker 外还支持裸机二进制、deb/rpm 包、Kubernetes Helm chart、Windows 与 macOS,详见 docs/INSTALL.md。
- 容器镜像同时发布在 Docker Hub 与 GHCR,Helm chart 发布在 Artifact Hub,二进制包在 releases 页面。
核心亮点
- 直接调用 nvidia-smi,无需安装额外驱动或复杂权限,部署简单
- 指标覆盖全面,包括利用率、显存、温度、功耗、风扇等关键项
- 支持多 GPU 自动发现,并通过标签区分不同设备,便于集群监控
不足之处
- 依赖 nvidia-smi 输出解析,性能开销随 GPU 数量增加而上升
- 文档/社区待观察
适用场景
- Kubernetes 集群中监控 GPU 节点资源使用情况
- 深度学习训练任务中实时跟踪 GPU 温度和功耗,防止过热
- 多机多卡环境下统一收集 GPU 指标用于容量规划和成本分析
替代项目
dcgm-exporter、nvidia_gpu_exporter (Prometheus 官方)、gpu-monitoring-tools
上一篇:rwkv.cpp
下一篇:llmgateway
同类项目推荐
 oracle-ai-developer-hub
开源
用 Oracle 数据库和云服务,快速上手构建企业级 AI 应用
Technical resources for AI developers to build applications, agents, and systems usi···
 reader
开源
本地部署,给任意网页加个前缀,秒变LLM可读文本
This is an adapted version of Jina AI's Reader for local deployment using Docker. Co···
 dama
开源
一键容器化部署,快速跑通机器学习自动化流程
a simplified machine learning container platform that helps teams get started with a···
 rerun
开源
实时可视化多模态机器人数据,让调试和训练更高效
Visualize, query, and stream to train on multimodal robotics data.
 kubeflow-chart
开源
用 Helm 一键部署 Kubeflow,省去复杂配置。
Kubeflow helm chart
 afm-Server
开源
把苹果设备端模型变成本地 OpenAI API,一键调用
macOS menu bar app that exposes Apple's on-device Foundation Models as an OpenAI-com···
 llm-on-openshift
开源
在 OpenShift 上快速跑通 LLM 部署与推理
Resources, demos, recipes,... to work with LLMs on OpenShift with OpenShift AI or Op···
 HiRoute
开源
本地分流代理请求,省钱模型干杂活,强模型只啃硬骨头
Make Codex and Claude Code subscriptions go further: a local model router that gives···
 privacy-filter
开源
给 LLM 请求装个隐私过滤器,毫秒级脱敏,防数据泄露
LLM privacy gateway in Go — millisecond-latency PII and secret redaction. Used in p···