
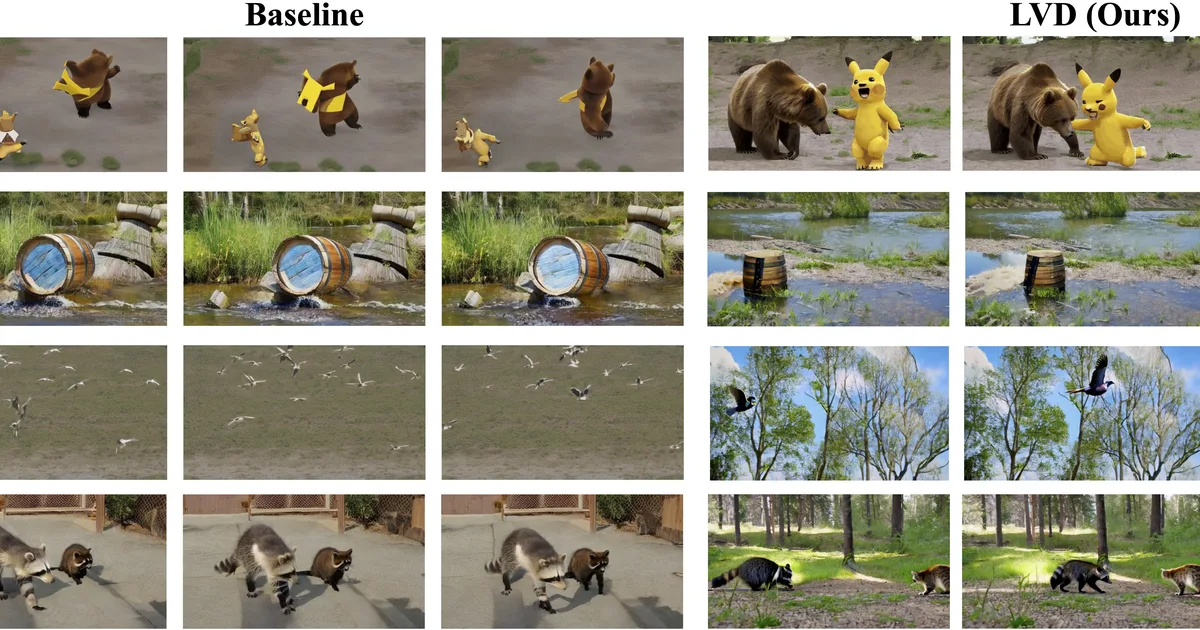
项目预览
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-09 · 当前星标 ★ 172
核心亮点
- 创新性地用LLM做场景分解,显著提升文本-视频语义对齐
- 支持场景级编辑,可精准修改视频某段内容
- 官方ICLR 2024实现,代码结构清晰,含训练推理脚本
不足之处
- 视频生成质量受限于基础扩散模型,分辨率较低
- 依赖LLM的规划质量,复杂文本可能生成不连贯场景
- 文档/社区待观察
适用场景
- 研究文本到视频生成的语义控制方法
- 需要根据详细脚本生成多场景短视频
- 对生成视频进行局部内容修改或重生成
替代项目
ModelScope Text-to-Video、VideoFusion、Imagen Video
同类项目推荐
 muapi-comfyui
开源
在 ComfyUI 里一键调用 100+ 主流 AI 生成模型
ComfyUI custom nodes for 600+ AI models — Seedance, Kling, Veo3, Flux, HiDream, GPT···
 qiaomu-cut-skill
开源
让 AI 自动当导演,素材到成片一键可复现
乔木智能视频导演 Skill:素材治理、双语字幕、品牌包装与可复现渲染 | Agent-native vide···
 AlayaRenderer
开源
用扩散模型直接渲染游戏世界,告别传统管线
Generative World Renderer: an AI-native Renderer for Games and Virtual Worlds.
 LynnReal-Omni
开源
一个框架搞定文生视频到长视频流式生成,四步出片
LynnReal-Omni brings text-to-video, image-to-video, human- and hand-pose guided gene···
 UltraFlash
开源
实时流式生成高分辨率视频
⚡ Ultra Flash: Scaling Real-Time Streaming Video Generation to High Resolutions
 Seedance-ShotDesign-Skills
开源
用结构化镜头设计,让文本秒变专业视频片段
Seedance 2.5 Shot Design Skills
 lingbot-world
开源
给个开头画面,AI 自动接续成片
Advancing Open-source World Models
 text2video-from-scratch
开源
手把手从零实现视频扩散模型,看懂每一步
A Straightforward, Step-by-Step Implementation of a Video Diffusion Model
 AI-Faceless-Video-Generator
开源
输入主题,AI 自动生成脚本、配音和虚拟人脸视频
Generate a video script, voice and a talking face completely with AI