
项目预览
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-10-29 · 当前星标 ★ 1453
使用教程
环境要求
- Windows 64 位系统(安装包为 x64 setup)
- NVIDIA 显卡且显存 6 GB 以上(官方主测试路径)
- 如需训练 LoRA:NVIDIA 显卡且显存 11 GB 以上
- Microsoft Edge WebView2 运行时(安装包会在系统缺失时自动获取)
- 可写入的安装/解压目录(不要放在只读位置)
安装与启动步骤
-
1下载安装包
打开 GitHub Releases 页面,下载最新版 YuE2.Studio_x.y.z_x64-setup.exe 安装包。
-
2运行安装程序
双击安装包,或在 PowerShell 中执行;安装路径选一个当前用户可写的目录。
.YuE2.Studio_x.y.z_x64-setup.exe -
3或用便携版
也可把便携压缩包解压到任意目录,直接运行 YuE2-Studio.exe,无需安装。
.YuE2-Studio.exe -
4补齐 WebView2
若安装器卡在 WebView2 获取失败(如 0x80040902),先装微软独立安装包 Evergreen Standalone x64,再重跑安装器。
-
5下载模型集
首次启动会按显卡能力预选模型集,点下载即可;只拉取缺失文件,中断后可续传。
-
6生成第一首歌
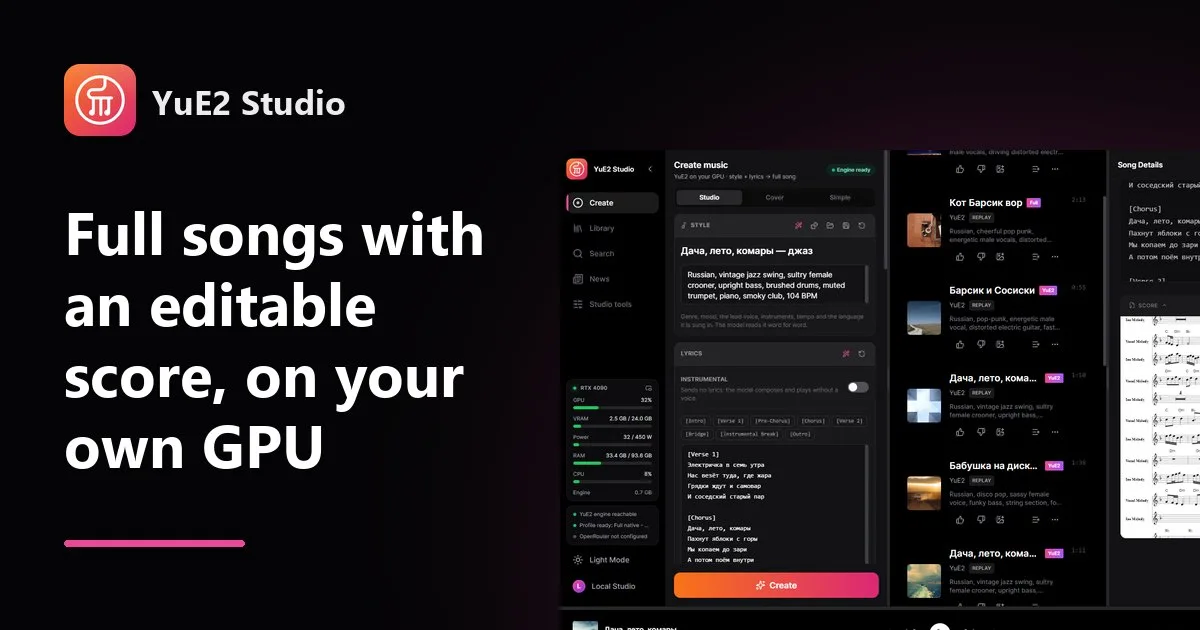
在创建页填写风格与歌词(或载入示例),点 Create,引擎自动启动,歌曲与乐谱进入曲库。
关键配置
| 配置项 | 必填 | 说明 | 示例 |
|---|---|---|---|
MCP 服务地址 | 否 | 供外部 AI 代理连接工作室的本地 MCP 端点 | http://127.0.0.1:8791/mcp |
模型与歌曲存放目录 | 否 | 模型、歌曲、设置、日志、临时文件与 WebView2 配置均在 exe 同目录 | D:AppsYuE2-Studio |
设备选择 | 否 | 设置 → Models 中选择设备,Auto 表示有运行时用显卡,否则用处理器 | Auto |
如何确认成功
安装器执行完毕后 YuE2-Studio 窗口正常打开,首屏出现模型集下载页即表示安装成功。
常见问题
Q:需要安装 Python 或 Node.js 吗?
A:不需要。运行时链路不含 Python,安装包为 Windows 原生程序,装完即可使用。
Q:安装时报 WebView2 相关错误怎么办?
A:从微软下载 Evergreen Standalone x64 独立安装包装好,再重新运行 YuE2 的安装程序。
Q:AMD、Intel 显卡或无独显能用吗?
A:可以启动,但走 Vulkan/DirectML 或处理器路径,官方标注为实验性,主测试路径仍是 NVIDIA 显卡。
Q:软件会不会联网上传我的数据?
A:生成过程完全离线;只有首次下载模型集和安装版自动更新时会联网。
Q:怎么彻底卸载?
A:安装到可写目录或使用便携版时,直接删除该文件夹即可;装在 Program Files 时数据会回退到 %LOCALAPPDATA%YuE2 Studio。
注意事项
- 模型、歌曲、设置与日志都存放在 YuE2-Studio.exe 所在目录,删除文件夹即等于卸载。
- 安装到 Program Files 等只读位置时,数据目录会回退到 %LOCALAPPDATA%YuE2 Studio。
- 安装版本支持应用内提示并原地自动更新,便携版需自行替换文件。
- LoRA 训练仅支持 NVIDIA 显卡;AMD、Intel 与处理器路径部分功能不可用。
核心亮点
- Windows 原生安装包,免 Python 环境,带自动更新,上手门槛低
- 生成结果以可编辑乐谱呈现,可改谱后重生成,比纯音频黑盒更可控
- 支持固定参数精确复现同一首歌,便于迭代调优和对比
不足之处
- 仅支持 Windows + NVIDIA CUDA,Mac 与 AMD 显卡用户无法使用
- 依赖本地显卡显存,低配机器生成速度慢或无法运行
- 项目较新,模型版本与功能仍在快速变化,稳定性待观察
适用场景
- 音乐爱好者在本地显卡上生成带人声的原创小样
- 创作者用可编辑乐谱微调旋律后重新生成歌曲
- 为已有歌曲制作翻唱风格版本并精确复现调参结果
替代项目
YuE、ACE-Step、DiffRhythm
上一篇:SpatialFlow
下一篇:没有了!
同类项目推荐
 text-to-speech-api
开源
几行代码接入 Play.ht 语音合成,快速实现文本朗读
Play.ht's Text to Speech API
 ViSAudio
开源
给视频自动配上带方向感的双耳空间音效
ViSAudio: End-to-End Video-Driven Binaural Spatial Audio Generation
 Kazakh_TTS
开源
哈萨克语语音合成,271小时多说话人数据直接可用
An expanded version of the previously released Kazakh text-to-speech (KazakhTTS) syn···
 DragonianVoice
开源
用 C++ 把 SVC/TTS 模型跑起来,性能拉满,部署无忧。
多个SVC/TTS的C++推理库
 AdaSpeech
开源
用少量样本快速定制专属语音合成模型
AdaSpeech: Adaptive Text to Speech for Custom Voice
 pdf-to-podcast
开源
把 PDF 变成能听的播客,通勤路上轻松吸收知识。
Transform PDFs into AI podcasts for engaging on-the-go audio content.
 linuxwave
开源
把系统随机数变成音乐,听见 Linux 的脉搏
Generate music from the entropy of Linux
 LLMVoX
开源
让任意LLM秒变语音助手,流式对话零延迟
LLMVoX: Autoregressive Streaming Text-to-Speech Model for Any LLM
 HiggsAudio-Studio
开源
离线一键生成多角色播客和有声书,支持声音克隆。
Portable Windows TTS — Higgs Audio v3 + AI text director, podcast & audiobook multi···