
项目预览
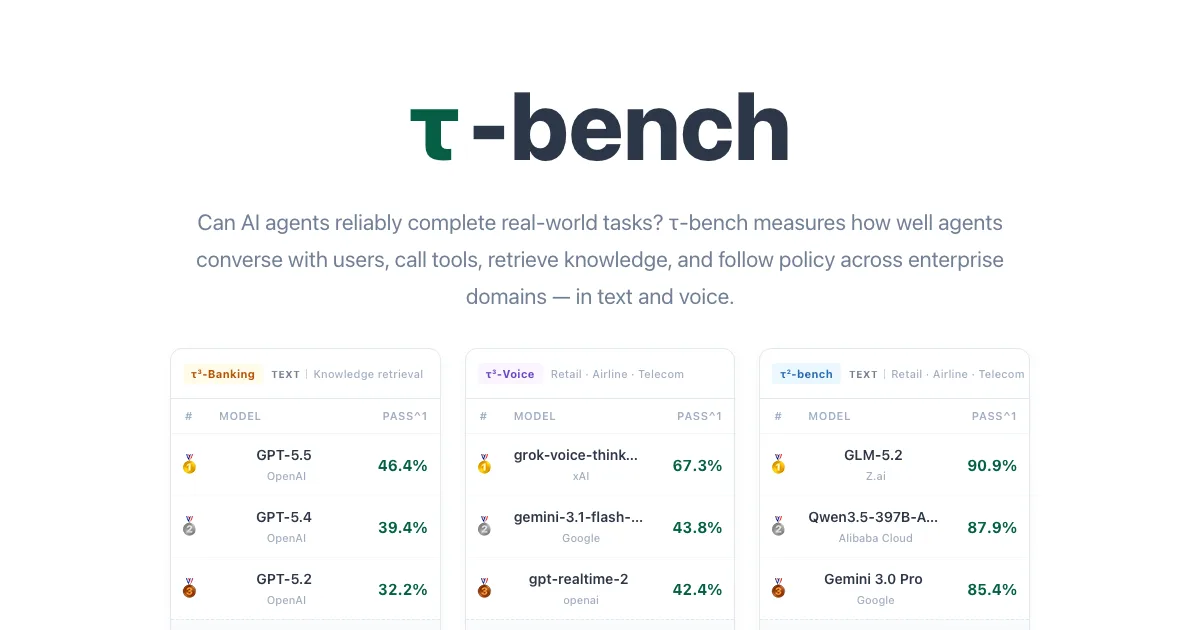
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-09 · 当前星标 ★ 2413
使用教程
环境要求
- 已安装 uv 包管理器(README 指明必须使用 uv,未指定 Python 版本)
- 可用的 LLM API 密钥(用于 --agent-llm / --user-llm 指定的模型)
- 如需语音功能,需额外系统依赖:macOS 上 brew install portaudio ffmpeg
- git,用于克隆仓库
安装与启动步骤
-
1克隆仓库
从 GitHub 拉取 tau2-bench 源码并进入项目目录,后续所有命令都在该目录执行。
git clone https://github.com/sierra-research/tau2-bench cd tau2-bench -
2安装核心依赖
README 指定的标准安装方式,安装后支持 text-mode 的 airline、retail、telecom、mock 领域。
uv sync -
3按需安装可选功能
只装自己用得到的扩展:语音、banking_knowledge、gym RL 接口、开发工具,也可用 --all-extras 全装。
uv sync --extra voice uv sync --extra knowledge uv sync --extra gym uv sync --extra dev -
4配置 API 密钥
复制示例环境变量文件生成 .env,再按 README 提示在其中填入模型 API 密钥(README 未列出具体变量名)。
cp .env.example .env -
5查看可用命令
运行内置介绍命令,快速了解可用领域、命令和示例,确认安装是否正常。
tau2 intro -
6运行一次评估
在 airline 领域上用 gpt-4.1 同时作为 agent 与用户模拟模型,跑 1 次试验、5 个任务。
tau2 run --domain airline --agent-llm gpt-4.1 --user-llm gpt-4.1 --num-trials 1 --num-tasks 5 -
7查看评估结果
评估结果自动保存到 data/simulations/,用 view 命令浏览已生成的模拟记录。
tau2 view
关键配置
| 配置项 | 必填 | 说明 | 示例 |
|---|---|---|---|
.env | 是 | 存放模型 API 密钥的配置文件,由 .env.example 复制而来 | cp .env.example .env |
--domain | 是 | 指定评估领域,如 airline、retail、telecom、banking_knowledge 等 | airline |
--agent-llm | 是 | 被评估智能体所使用的模型 | gpt-4.1 |
--user-llm | 是 | 用户模拟器所使用的模型 | gpt-4.1 |
--num-trials | 否 | 每个任务重复试验次数,README 示例为 1 | 1 |
--num-tasks | 否 | 本次评估运行的任务数量,README 示例为 5 | 5 |
如何确认成功
tau2 run 执行完成后,结果文件出现在 data/simulations/ 目录,且能用 tau2 view 正常浏览,即表示环境配置成功。
常见问题
Q:语音(voice)相关功能安装失败怎么办?
A:语音特性除 uv sync --extra voice 外还需系统依赖,macOS 上执行 brew install portaudio ffmpeg,其他系统参见官方完整安装指南 docs/getting-started.md。
Q:为什么跑不了 banking_knowledge 知识检索领域?
A:该领域属于可选依赖,需要先执行 uv sync --extra knowledge 安装检索流水线相关组件,仅 uv sync 只包含 text-mode 领域。
Q:旧的评估结果还能和新版本对比吗?
A:不能。v1.0.1 修复了 banking_knowledge 的任务错误,1.0.1 之前版本产生的分数与 1.0.1 及以后不可比;旧结果文件可用 tau2 evaluate-trajs --fresh-tasks 重新评分。
Q:结果保存在哪里、怎么看?
A:结果写入 data/simulations/,直接运行 tau2 view 即可浏览;tau2 intro 可查看可用领域、命令与示例。
注意事项
- README 明确要求使用 uv 进行依赖管理,不要改用 pip 手动安装。
- 只有参与贡献才需要安装 --extra dev(pytest、ruff、pre-commit)。
- 若需复现 1.0.1 修复前的行为,可切换到 pre-v1.0.1 标签版本。
- README 未给出具体的环境变量名称与 Python 版本,配置密钥时请以 .env.example 和 docs/getting-started.md 为准。
核心亮点
- 基于真实零售和航空场景,任务设计贴近实际业务,评估结果更有说服力
- 提供完整的用户模拟器和自动化评分工具,无需人工参与即可批量测试
- 支持多轮对话和工具调用评估,能有效暴露智能体在复杂交互中的短板
不足之处
- 领域覆盖有限,目前仅包含零售和航空,其他行业场景需自行扩展
- 文档和社区生态相对较新,示例和最佳实践有待丰富
适用场景
- 大模型智能体开发者在发布前进行自动化回归测试
- 企业评估不同AI客服或业务助手模型的选型参考
- 学术研究用于对比不同工具调用策略或提示词设计
替代项目
ToolBench、API-Bank、BFCL
上一篇:Awesome-LM-SSP
同类项目推荐
 uqlm
开源
量化 LLM 不确定性,精准识别幻觉,提升 AI 输出可信度。
[JMLR 2026] UQLM: A Python package for LLM hallucination detection using uncertainty···
 AgentCapture
开源
给 AI 攻击代理布下诱饵,抓行为还能反制
Deception-layer honeypot that captures & reverse-controls AI pentest agents — embed···
 Awesome-AIGC-Image-Video-Detecti···
开源
一页看全 AIGC 图像视频检测论文、数据集与基准
A curated collection of the latest research and resources on AI-Generated Image and ···
 openai-guardrails-python
开源
给 LLM 应用加一层安全护栏,自动拦截违规输入输出
OpenAI Guardrails - Python
 llm_benchmark
开源
跑一遍评测,快速发现大模型安全短板
 halo-record
开源
给 AI 代理装上防篡改黑匣子,操作记录人人可验
Tamper-evident audit trails for AI agents: hash-chained Runtime Records, dependency-···
 aiewf-eval
开源
专测大模型长上下文下的安全表现
A long-context eval
 promptpex
开源
自动生成提示词测试用例,让 Prompt 迭代更稳更高效
Test Generation for Prompts
 RVCBench
开源
给语音克隆模型做安全体检,防伪造保隐私
Comprehensive voice cloning evaluation: seven automatic speech metrics and ready-to-···