

项目预览
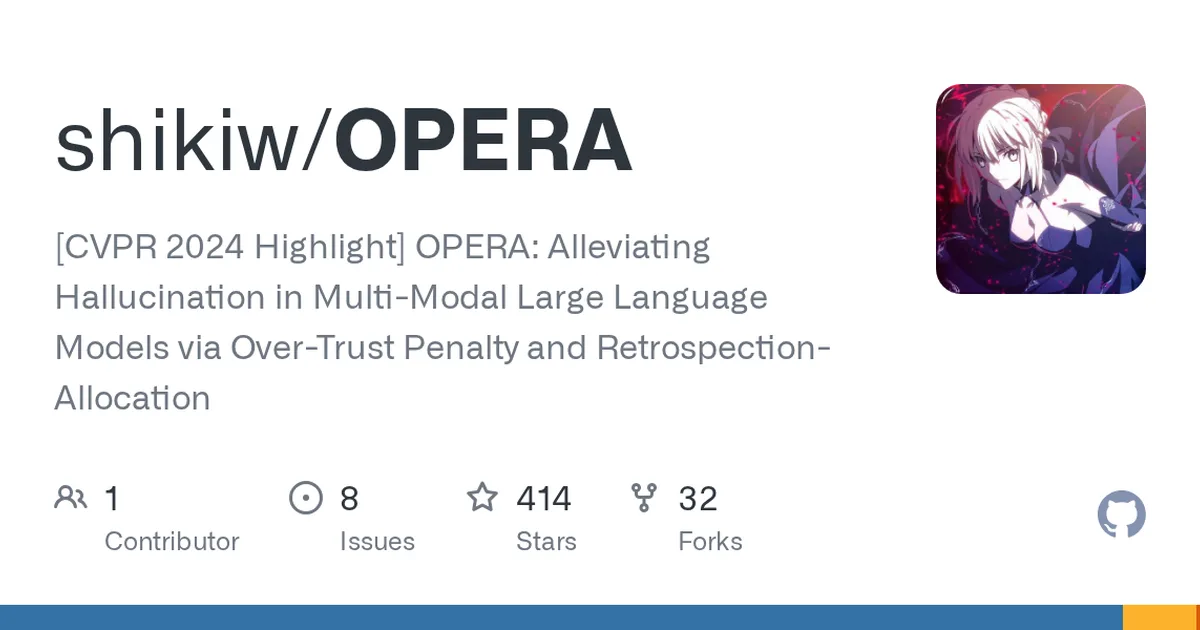
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-09 · 当前星标 ★ 416
使用教程
ℹ 本教程由 AI 依据该项目 README 整理,个别步骤可能需要按你的环境微调。
环境要求
- NVIDIA GPU(显存 24GB 起)
- CUDA
- 评测数据集
安装与启动步骤
-
1拉仓库
论文官方实现,含评测脚本。
-
2装依赖
指定版本的转换器库要单独装,别用新版。
python -m pip install -e transformers-4.29.2 -
3准备评测数据
按说明放到指定路径。
-
4跑对比评测
同参数下比较有无该方法的差异。
python gpt4v_eval.py --model <模型名> --data_path <数据路径> --gpu-id 0
如何确认成功
应用该方法后模型在评测集上的幻觉类指标明显下降,而通用能力分数基本不变
注意事项
- 它针对多模态模型的幻觉问题做干预,属于推理期方法。
- 复现强依赖指定版本的依赖库,版本错位结果不可信。
- 评测集与模型训练数据可能重叠,结论要看多个集。
- 干预会增加推理开销,需要权衡。
- 研究代码,参数与路径要按本机改。
核心亮点
- 提出over-trust penalty和retrospection-allocation两种机制,从注意力层面直接干预幻觉生成
- 无需微调或重新训练模型,可即插即用集成到现有LLaVA等模型中
- 在多个基准数据集上显著降低幻觉率,且附带CVPR论文和官方实现,学术可信度高
不足之处
- 项目处于早期阶段,文档和社区支持相对薄弱
- 依赖特定模型架构(如LLaMA),通用性可能受限
适用场景
- 多模态对话系统中减少错误图像描述
- 视觉问答场景提升回答准确性
- 自动驾驶或医疗影像等高风险场景的辅助分析
替代项目
LLaVA、MiniGPT-4、InstructBLIP
同类项目推荐
 guardrails
开源
给大模型输出装上安全阀,让生产更可靠
Adding guardrails to large language models.
 VLABench
开源
一站式公平评测VLA与具身智能模型,让模型实力一目了然
A large-scale benchmark for evaluating vision-language-action models, embodied agent···
 mt-rag-benchmark
开源
多轮对话下测 RAG,暴露单轮评测看不到的短板
Multi-Turn RAG Benchmark
 Awesome-MCoT
开源
一张图看懂多模态推理研究脉络与代表工作
Multimodal Chain-of-Thought Reasoning: A Comprehensive Survey
 autoguardrails
开源
用 policy.md 自动搜索最优 LLM 护栏策略
Alignment-research scaffold (autoresearch-style) for LLM guardrails: search over a s···
 NISQA
开源
无参考也能给语音质量打分,TTS自然度一测便知
NISQA - Non-Intrusive Speech Quality and TTS Naturalness Assessment
 SemBench
开源
给语义查询引擎跑分,选型不再靠猜
Benchmarking Semantic Query Processing Engines
 frouros
开源
实时监控模型漂移,提前预警性能下降
Frouros: an open-source Python library for drift detection in machine learning syste···
 superbenchmark
开源
一键体检 AI 集群,跑分定位硬件瓶颈
A validation and profiling tool for AI infrastructure