

项目预览
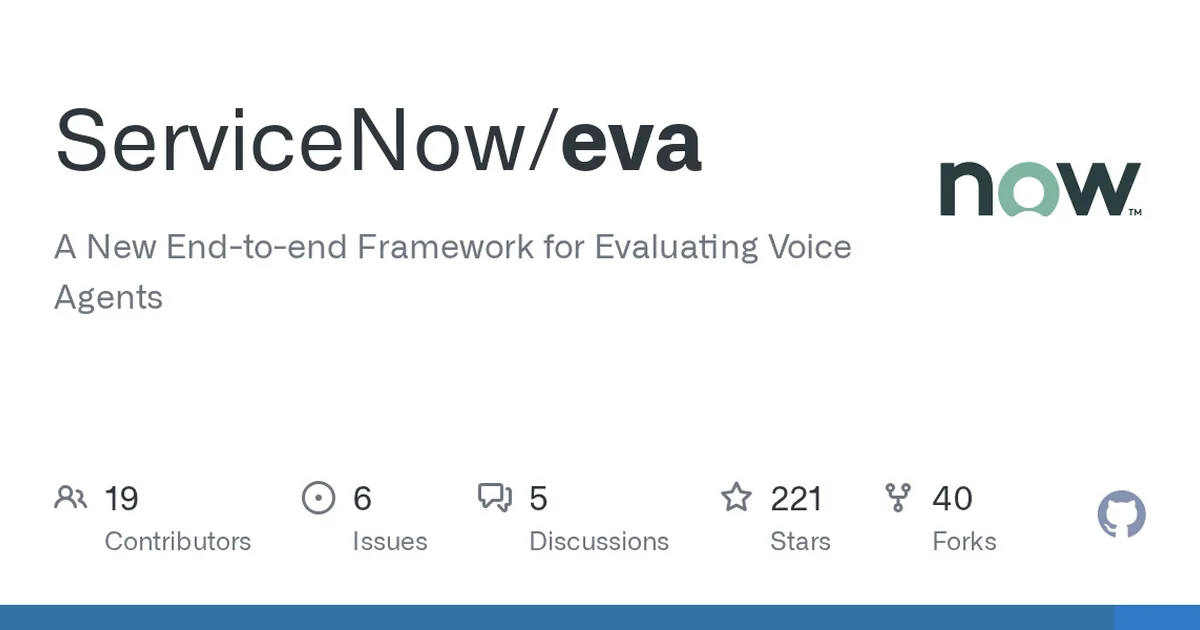
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-09 · 当前星标 ★ 236
核心亮点
- 端到端评估,覆盖 ASR 到 TTS 全链路,避免单点测试盲区
- 专为 agentic AI 设计,支持复杂对话场景的自动化评测
- Python 实现,易于集成到现有 ML/NLP 开发流程
不足之处
- 项目处于早期阶段(194 星),API 和功能可能不稳定
- 文档和社区生态待观察,实际使用案例较少
适用场景
- 语音助手开发中,对比不同 ASR/TTS 供应商组合的整体效果
- 智能客服系统上线前,自动化回归测试对话流畅度与任务完成率
- 研究语音代理评测方法论,作为学术实验的基准框架
替代项目
OpenAI Evals、Ragas、DeepEval
上一篇:RVCBench
下一篇:UltraEval-Audio
同类项目推荐
 SWE-bench_Pro-os
开源
用长周期工程任务,真实测出 AI Agent 的软件工程上限
SWE-Bench Pro: Can AI Agents Solve Long-Horizon Software Engineering Tasks?
 TrustEval-toolkit
开源
一键评估生成模型可信度,量化风险更安心
[ICLR'26, NAACL'25 Demo] Toolkit & Benchmark for evaluating the trustworthiness of g···
 EvalForge
开源
给 AI 评测加回归门禁,指标一降 CI 就拦。
Evaluator-neutral AI evaluation evidence, baseline regression gates, and JSON, JUnit···
 superagent
开源
给 AI 应用装上安全盾,防注入防泄露
Superagent protects your AI applications against prompt injections, data leaks, and ···
 MathVista
开源
测测AI看图算数行不行,一套基准见分晓
MathVista: data, code, and evaluation for Mathematical Reasoning in Visual Contexts
 llm-leaderboard
开源
一站式对比LLM基准分数和价格,快速选型
A comprehensive set of LLM benchmark scores and provider prices. (deprecated, read m···
 next-evals-oss
开源
给 AI 出 Next.js 考题,看它到底会不会写
Evals for Next.js up to 15.5.6 to test AI model competency at Next.js
 crust
开源
给 AI Agent 装上行为拦截闸,危险操作发生前就挡住
Open Source AI Agent Security Infrastructure — intercepts and blocks dangerous agen···
 Jailbreak-Foundry
开源
把越狱论文变成可跑的攻击测试,实时更新基准
A system that turns jailbreak papers into runnable attacks and benchmarks — live, a···