

项目预览
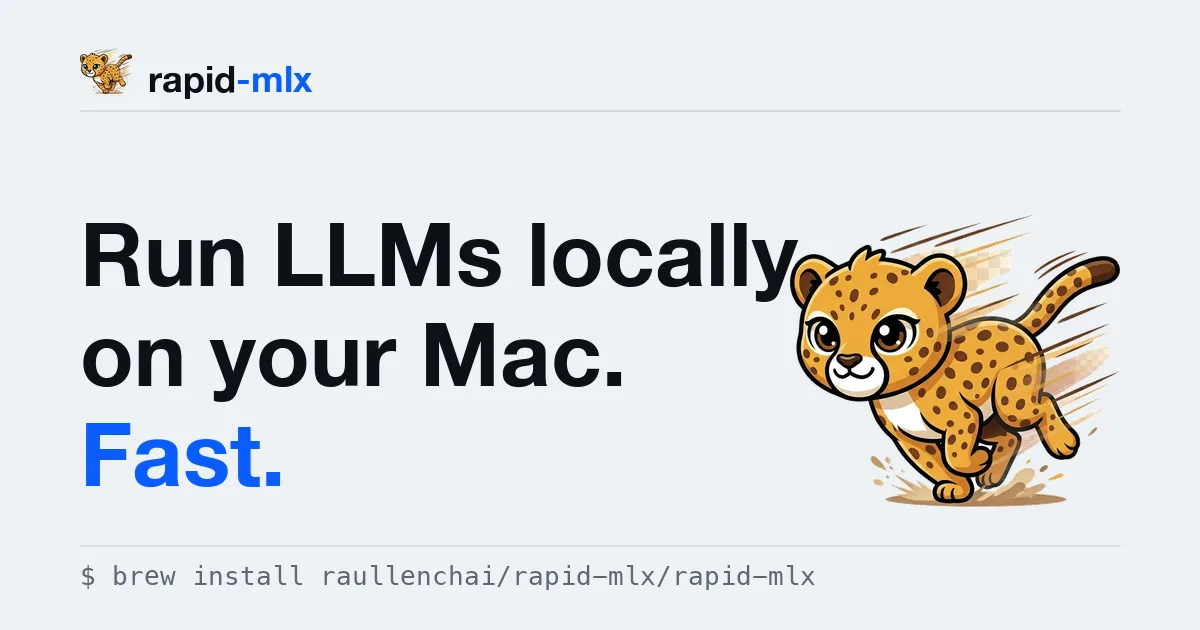
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-09 · 当前星标 ★ 4123
使用教程
环境要求
- Apple Silicon Mac(M1/M2/M3/M4),不支持 Intel Mac
- macOS 系统,pip 方式需 Python 3.10+(macOS 自带 3.9 偏低)
- 首次运行需下载约 3GB 模型权重,预留磁盘空间
- 基础安装为纯文本版,约 460MB;视觉/音频等需额外 extras
安装与启动步骤
-
1安装 Rapid-MLX
引导式安装脚本会自动检测内存并推荐入门模型;也可用 Homebrew 直接安装。
curl -fsSL https://rapidmlx.com/install.sh | bash -
2命令行对话测试
默认使用 qwen3.5-4b-4bit,首次运行下载约 3GB 权重后进入 REPL,用 /help 看命令、/exit 退出。
rapid-mlx chat -
3启动本地推理服务
启动 OpenAI 兼容的 HTTP 服务,默认绑定 http://localhost:8000,供其他客户端调用。
rapid-mlx serve qwen3.5-4b-4bit -
4验证接口可用
向 /v1/chat/completions 发一条请求,能返回 JSON 即说明服务正常。
curl http://localhost:8000/v1/chat/completions \ -H "Content-Type: application/json" \ -d '{"model":"default","messages":[{"role":"user","content":"Say hello"}]}' -
5接入 Claude Code
在服务已启动的前提下,该命令自动改写 ~/.claude/settings.json 指向本地端点,无需手填环境变量。
rapid-mlx launch claude-code
关键配置
| 配置项 | 必填 | 说明 | 示例 |
|---|---|---|---|
RAPID_MLX_API_KEY | 否 | 仅当把服务通过公网 HTTPS 隧道暴露时设置,避免无鉴权裸奔 | your-secret |
如何确认成功
执行 curl 能收到聊天补全 JSON,或 rapid-mlx chat 进入 REPL 正常对话,即安装并启动成功。
常见问题
Q:pip 安装提示 no matching distribution 怎么办?
A:说明 Python 版本过低(macOS 自带 3.9)。先执行 brew install python@3.12,再用 python3.12 -m pip install rapid-mlx 安装。
Q:可以在 Cursor 里用吗?
A:Cursor 的 BYOK 请求经由其自有服务器,无法访问 localhost。README 说明需通过公网 HTTPS 隧道暴露,并同时设置 RAPID_MLX_API_KEY,此时已不是纯本地连接。
Q:如何支持视觉、音频等模型?
A:基础安装仅文本。视觉装 pip install 'rapid-mlx[vision]',音频装 'rapid-mlx[audio]',全功能装 'rapid-mlx[all]'。
Q:后续怎么升级版本?
A:Homebrew 用 brew upgrade rapid-mlx;uv 用 uv tool upgrade rapid-mlx;pip 用 pip install -U rapid-mlx。
注意事项
- 仅支持 Apple Silicon(M1/M2/M3/M4)的 Mac,Intel 机器不可用。
- 引导安装按内存推荐模型:低于 16GB 用 lfm2.5-1b-4bit,16GB 及以上用 qwen3.5-4b-4bit。
- 基础安装是纯文本版(约 460MB),首次对话还会额外下载约 3GB 权重。
- 接入 Claude Code 必须先启动 rapid-mlx serve,launch 命令会修改 ~/.claude/settings.json。
核心亮点
- 性能激进:宣称比 Ollama 快 4.2 倍,缓存 TTFT 仅 0.08 秒,实测感知明显
- 工具调用完整:支持 17 种工具解析器,100% 兼容 OpenAI 工具协议,适配 Claude Code 等
- 智能缓存与路由:提示词缓存降低重复请求延迟,本地资源不足自动路由云端,兼顾速度与容量
不足之处
- 仅支持 Apple Silicon,Intel Mac 和 Linux/Windows 用户无法使用
- 文档/社区待观察:项目较新,生态和稳定性验证尚未充分
适用场景
- Mac 上本地运行大模型作为 OpenAI API 的替代,用于开发调试
- 配合 Claude Code、Cursor 等工具,实现低延迟的代码生成与工具调用
- 对隐私敏感或网络不稳定的场景,利用本地推理+云端路由兜底
替代项目
Ollama、LM Studio、llama.cpp
上一篇:basic-memory
下一篇:eidos
同类项目推荐
 LLMKube
开源
用 kubectl 在混搭 GPU 集群上跑大模型推理
Kubernetes operator for self-hosted LLM inference across a heterogeneous GPU fleet: ···
 llm.report
开源
记录 OpenAI 调用日志,分析成本,优化提示词
llm.report is an open-source logging and analytics platform for OpenAI: Log your Cha···
 python-sdk
开源
用 Python 轻松操作 Pinecone 向量库,快速实现向量检索
Official Python SDK for the Pinecone vector database
 LongLive
开源
让视频生成突破时长限制,轻松产出长视频。
Long Video Gen / World Model / World Action Model (Embodied) Infrastructure
 TypeGPT
开源
把大模型装进操作系统,随处唤起 AI 助手
Integrate LLM's into your OS. For any issues or ideas, message us in the discord ser···
 a-guide-to-mlops
开源
从传统到现代,一份指南带你玩转MLOps工具链
A simple yet complete guide to MLOps tools and practices - from a conventional way t···
 vox-serve
开源
让 TTS/STS 模型秒变低延迟流式在线服务
A Streaming-Native Serving Engine for TTS/STS Models
 mlrun
开源
一键编排ML流水线,从开发到上线全自动
MLRun is an open source MLOps platform for quickly building and managing continuous ···
 krasis
开源
显存不够也能跑大模型,混合推理榨干硬件性能
Krasis is a Hybrid LLM runtime which focuses on efficient running of larger models o···