
项目预览
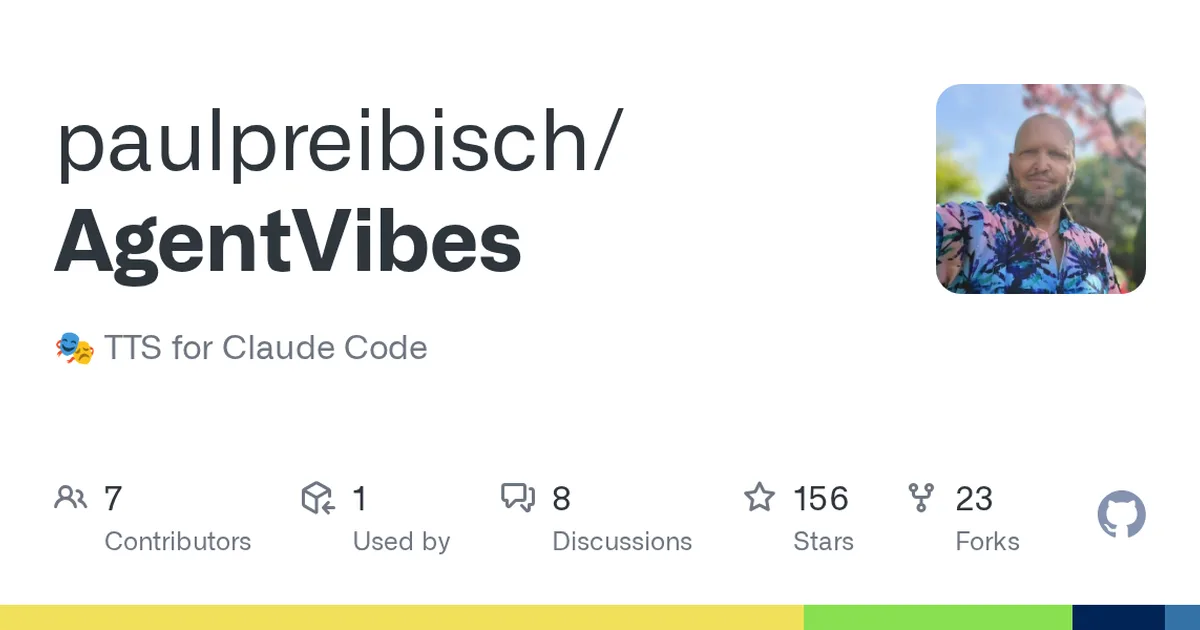
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-11-08 · 当前星标 ★ 156
核心亮点
- 把 Claude Code 的文本输出实时转为语音,终端编码时可听反馈,减少盯屏阅读
- 基于 JavaScript 实现,接入和二次开发门槛低,便于自定义音色与播报规则
- 提供 Docker 部署方式,环境依赖相对可控,方便快速试用
不足之处
- 项目处于早期,星标约 156,功能稳定性和长期维护待观察
- 语音播报会增加音频依赖与配置成本,对安静环境或远程会议场景不友好
适用场景
- 终端里用 Claude Code 写代码时,用语音收听 AI 的回复与提示
- 需要边做其他事边跟进 AI 编程任务进度时
- 为团队演示或教学场景增加语音交互反馈
替代项目
piper、Coqui TTS、edge-tts
上一篇:qwen-tts-webui
下一篇:Hojo-TTS-Light
同类项目推荐
 MOSS-Audio-Tokenizer
开源
把音频变成 token,让大模型能听会说
A 1.6B causal Transformer audio tokenizer with streaming, variable bitrates, and sem···
 wtonec
开源
给微信/QQ加装语音增强和文字转语音,聊天更个性
Wtonec:微信 / QQ / 小红书 / 抖音文字转语音、语音包、语音播报、克隆音色、表情包。上百···
 youtube-auto-dub
开源
本地免费给YouTube视频配音,克隆原声换语言,自动同步字幕
Local-first, open-source YouTube dubbing: clones the original voice into another lan···
 Voice-Cloning-App
开源
上传几秒音频,即刻克隆人声并合成任意文本
A Python/Pytorch app for easily synthesising human voices
 CosyVoice2-Ex
开源
3秒复刻音色,自然语言控声音,开箱即用的语音合成增强包
CosyVoice2 功能扩充(预训练音色推理/3s极速复刻/自然语言控制/自动识别/音色模型保存/AP···
 nano-qwen3tts-vllm
开源
给 Qwen3-TTS 装上轻量推理引擎,语音生成快约 3 倍
Qwen3-TTS with nano vLLM-style optimizations for fast text-to-speech generation. Ach···
 ha-tts-bluetooth-speaker
开源
让 Home Assistant 用蓝牙音箱说话,无需额外硬件
TTS Bluetooth Speaker for Home Assistant
 MSVAE
开源
把音乐压成语义隐空间,理解、生成、重建一网打尽
A Music Semantic VAE for music understanding, generation, and high-fidelity reconstr···
 tacotron
开源
用 TensorFlow 复现谷歌 Tacotron,快速实现文本转语音
A TensorFlow implementation of Google's Tacotron speech synthesis with pre-trained m···