

项目预览
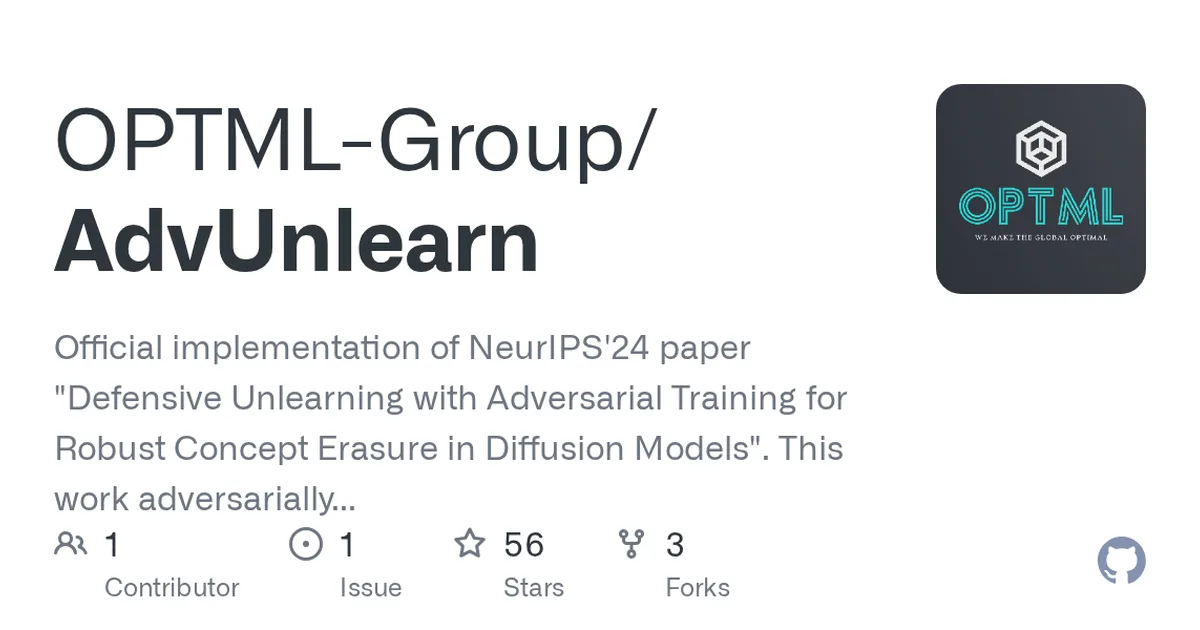
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-09 · 当前星标 ★ 56
技术标签
核心亮点
- 提出对抗性未学习框架,显著提升擦除模型对对抗提示的鲁棒性
- 官方实现,代码与论文对应,便于复现实验
- 在擦除效果和生成质量间取得更好平衡,优于现有方法
不足之处
- 项目处于早期阶段,文档和社区支持待观察
- 依赖特定扩散模型版本,迁移到新架构需适配
适用场景
- 安全 AI 内容生成,防止生成违规或侵权内容
- 个性化模型定制,精准移除特定风格或对象
- 对抗性攻击防御,提升生成模型的鲁棒性
替代项目
EraseDiff、SAFE、Forget-Me-Not
下一篇:VideoGen-Eval
同类项目推荐
 WorldLens
开源
给自动驾驶世界模型做全科体检,从生成到重建一测到底
[CVPR 2026 Oral] WorldLens: Full-Spectrum Evaluations of Driving World Models in Rea···
 evals
开源
用真实 React Native 任务,测出 AI 编码真本事。
A benchmark suite for evaluating how coding models solve real React Native tasks.
 VisualWebBench
开源
测一测多模态大模型在真实网页上有多能打
Evaluation framework for paper "VisualWebBench: How Far Have Multimodal LLMs Evolved···
 tensor-trust
开源
玩游戏,收集提示注入数据,助力AI安全研究
A prompt injection game to collect data for robust ML research
 LLMeBench
开源
一键跑分,快速对比各大语言模型效果
Benchmarking Large Language Models
 ADR
开源
给企业 AI 智能体装上安全监控与威胁拦截系统
ADR secures enterprise AI agents through observability, security benchmarking, and t···
 openai-guardrails-js
开源
给 LLM 应用加一道输入输出安检门,拦截越狱与敏感内容
OpenAI Guardrails - TypeScript / JavaScript
 Ai-jailbreak
开源
拿来即用的越狱提示库,快速测模型安全底线
A collection of jailbreak prompts and exploit techniques for local and frontier AI m···
 TransformerLens
开源
像调试代码一样拆开GPT,定位每个注意力头的作用
A library for mechanistic interpretability of GPT-style language models