

项目预览
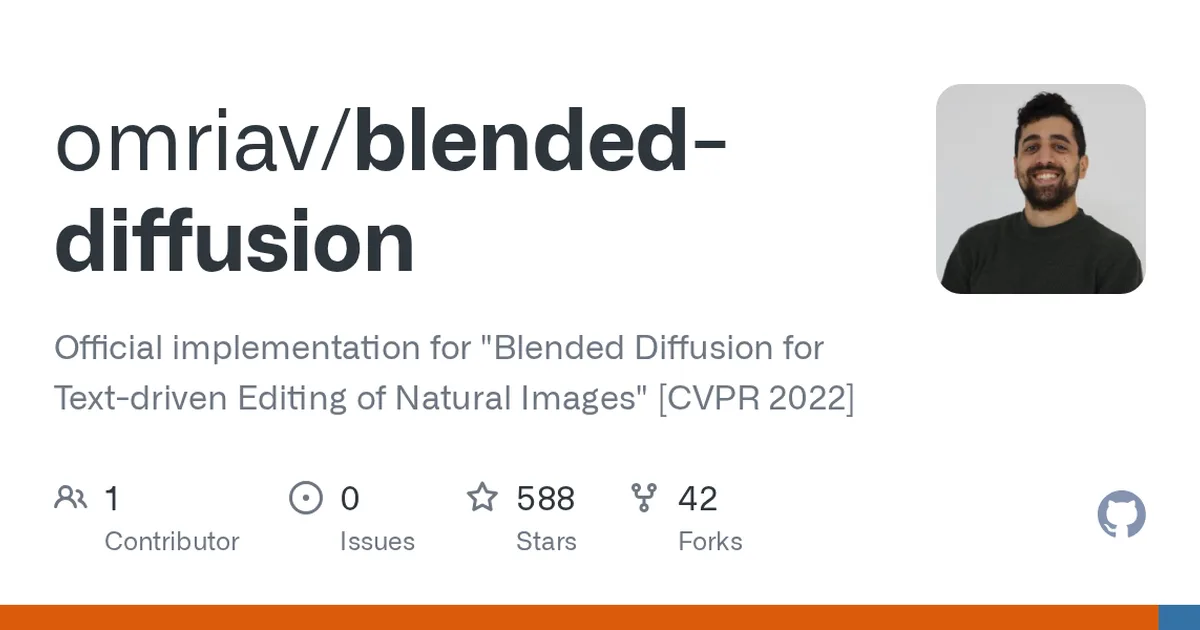
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-09 · 当前星标 ★ 588
使用教程
环境要求
- NVIDIA 显卡
- conda 环境
- 扩散模型权重
安装与启动步骤
-
1建老环境
指定 Python 版本,新版装不上当年那套框架。
conda create -n blended python=3.9 -
2装对应框架
框架版本与显卡驱动必须匹配,照 README 的版本抄。
pip install torch==1.9.0+cu111 -
3下预训练权重
扩散底座与文本编码器分开放,路径写进参数。
-
4跑混合示例
它演示的是两张图在潜空间里按提示词融合。
python main.py -p 'rock' -
5调融合强度
混合比例决定结果更靠哪一侧,多试几档。
如何确认成功
用同一提示词与两张不同素材重复三次,能看到主体概念被交换而构图大体保留
注意事项
- 这是早期潜空间混合的实验代码,不是产品级工具。
- 依赖版本很旧,在新驱动上可能装不起来,做好折腾准备。
- 生成质量受底座限制,现在有更强的编辑方案。
- 想复现论文结论就按原参数跑,改参数会偏离原文。
核心亮点
- 无需微调,直接利用预训练扩散模型和 CLIP 实现零样本编辑
- 支持局部区域编辑,保持背景和未编辑区域像素不变,混合自然
- 官方实现,代码结构清晰,附带演示和预训练权重加载说明
不足之处
- 依赖特定扩散模型和 CLIP 版本,环境配置较复杂
- 编辑效果受文本描述和区域掩码质量影响,复杂场景可能不稳定
- 文档/社区待观察
适用场景
- 设计师快速替换产品图中的背景或物体
- 用户用自然语言修图,如把照片中的猫换成狗
- 研究者探索扩散模型在图像编辑中的应用
替代项目
GLIDE、DALL-E 2、Stable Diffusion
上一篇:semantic-draw
下一篇:T2F
同类项目推荐
 comfyui-on-amazon-sagemaker
开源
把 ComfyUI 一键部署到 AWS,用 SD/FLUX 出图
This project demonstrates how to generate images using Stable Diffusion or FLUX.1 mo···
 eccv16_attr2img
开源
从属性描述生成逼真图像,复现 ECCV16 经典论文
Torch Implemention of ECCV'16 paper: Attribute2Image
 Vec2Face
开源
用松散向量一键生成海量多样人脸数据集,省时省力
This is the official implementation of "Vec2Face: Scaling Face Dataset Generation wi···
 cpa-image
开源
本地跑起 OpenAI 兼容图像生成,调试部署一步到位
CPA Image 是一个本地优先的 OpenAI 兼容图像生成与编辑控制台。
 AI-Playground
开源
Intel Arc 显卡上开箱即用的本地 AI 图像与对话应用
AI PC starter app for doing AI image creation, image stylizing, and chatbot on a PC ···
 KnpSnappyBundle
开源
在 Symfony 中一键将 HTML 转为 PDF 和图片
Easily create PDF and images in Symfony by converting html using webkit
 stable-diffusion-webui-docker
开源
把 Stable Diffusion 装进 Docker,一条命令跑起 WebUI
stable-diffusion-webui in docker
 gansformer
开源
用 Transformer 注意力机制生成全局协调的场景图像
Generative Adversarial Transformers
 Generative-Art
开源
用 Python 脚本一键生成独特艺术图像
A selection of generative art scripts written in Python