
项目预览
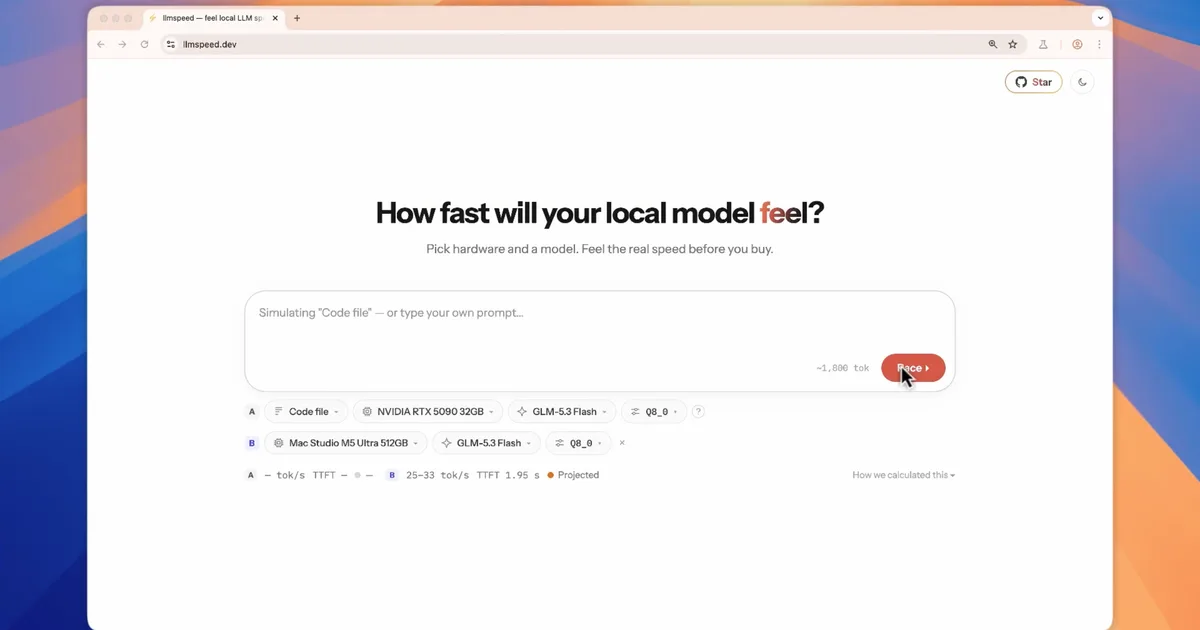
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-11-07 · 当前星标 ★ 171
核心亮点
- 围绕「买硬件前先测速」设计,直接输出首 token 延迟和每秒 token 数等可对比指标
- 对接 Ollama 等本地推理后端,无需自建评测框架即可跑通完整测试流程
- TypeScript 实现,安装和二次开发门槛低,结果结构化便于记录与横向比较
不足之处
- 项目处于早期,测试维度与硬件覆盖范围有限,结论外推需谨慎
- 缺少成熟的基准数据集与统计显著性设计,多次运行波动可能影响对比
适用场景
- 个人装机前对比不同 GPU 跑同一模型的推理速度
- 团队评估自托管 LLM 的硬件成本与吞吐是否满足业务需求
- 开发者调整量化等级或上下文长度后做性能基线复测
替代项目
llama.cpp、vLLM、Ollama
上一篇:SurrogateShield
同类项目推荐
 DSBench
开源
测测你的AI助手能不能像数据科学家一样干活
[ICLR 2025] DSBench: How Far are Data Science Agents from Becoming Data Science Expe···
 ProteinWorkshop
开源
统一蛋白质表示学习的数据、模型与评测流程
Benchmarking framework for protein representation learning. Includes a large number ···
 ClawProBench
开源
在真实 OpenClaw 里反复跑 Agent,用确定性打分比出谁更稳
ClawProBench is a live-first benchmark harness for evaluating LLM agents in the Op···
 aiewf-eval
开源
专测大模型长上下文下的安全表现
A long-context eval
 arksim
开源
模拟真实用户对话,上线前自动揪出智能体错误。
Find your agents errors be fore your real users do
 Video-MME-v2
开源
评测视频大模型,从看懂片段到理解长视频全场景。
Video-MME-v2: Towards the Next Stage in Benchmarks for Comprehensive Video Understan···
 overmind
开源
追踪+评测+微调,让 Agent 越用越准
The platform for continuously improving AI agents.
 ResolveLab
开源
给 Agent 工具注入故障,用副作用打分验真本事
Fault-injected tool environments with side-effect grading for evaluating and post-tr···
 llm-self-correction-papers
开源
一页看尽LLM自我纠正论文,快速跟上研究热点
List of papers on Self-Correction of LLMs.