
项目预览
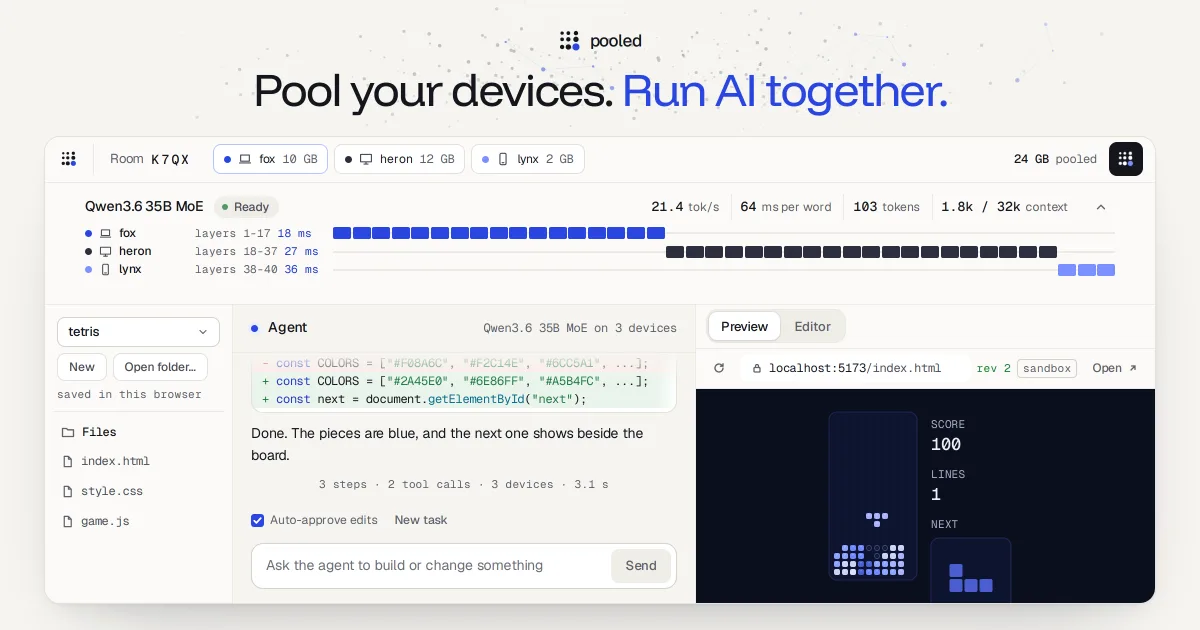
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-10-04 · 当前星标 ★ 658
使用教程
⚠ 该项目 README 未提供完整安装说明,以下步骤为通用流程,请以官方文档为准。
环境要求
- 支持新图形接口的浏览器
- 两台以上设备
安装与启动步骤
-
1确认浏览器支持
它依赖较新的图形接口做推理,老浏览器直接跑不起来。
-
2开一个节点
打开页面即成为参与推理的一个设备。
-
3多设备组网
再开几台设备加入同一会话,节点之间点对点直连。
-
4看分层效果
模型被拆到不同设备上跑,弱设备只承担一部分。
-
5对比单机基线
和单机跑同一模型比,重点看首字延迟与吞吐的差异。
如何确认成功
两台设备组网后能完成一次生成,且能观察到计算确实被分摊
注意事项
- 实验性项目,稳定性和兼容性都还在早期。
- 点对点意味着要把设备暴露在网络上,隐私环境要想清楚。
- 设备间带宽会成为瓶颈,局域网内体验远好于跨网。
- 适合验证思路,不适合当生产推理服务。
核心亮点
- 利用 WebRTC 和 WebGPU 把多台普通设备连成推理池,降低单机显存门槛
- 全程在浏览器内运行,无需安装客户端或配置 CUDA 环境,跨平台即开即用
- 引入投机解码等推理优化,在分布式环境下提升生成吞吐
不足之处
- 依赖 WebGPU 和 WebRTC 的浏览器支持,老旧设备或 Safari 兼容性有限
- 分布式推理的通信开销和调度复杂度可能影响实际体验,文档与社区尚在早期
适用场景
- 个人开发者用笔记本+台式机联合运行 70B 级开源模型做本地聊天
- 小团队在无 GPU 服务器的情况下,用办公电脑浏览器组池跑编码代理
- 隐私敏感场景下,在本地设备间分布式推理,避免数据上传云端
替代项目
exo、petals、llama.cpp
上一篇:TensorFold
下一篇:casadi
同类项目推荐
 bodywork-core
开源
用声明式配置,在 Kubernetes 上自动跑通 ML 流水线和模型上线。
ML pipeline orchestration and model deployments on Kubernetes.
 statewave
开源
给AI智能体装上可追溯的长期记忆,告别查询式检索
Open-source memory runtime for AI agents — reproducible, provenance-tagged context ···
 Deep-learning-in-cloud
开源
一张清单,快速选对深度学习云服务商
List of Deep Learning Cloud Providers
 gemini-cli-openai
开源
让 OpenAI 客户端不改代码直接调用 Gemini
Expose Gemini CLI endpoints as OpenAI API with Cloudflare Workers
 anemll-flash-llama.cpp
开源
让 Mac 统一内存也能跑动超大 MoE 模型
Flash-MoE sidecar slot-bank runtime for large GGUF MoE models on Apple Silicon — ll···
 grok2api-egress-enhancements
开源
代理出口质量自动守护,故障秒级隔离迁移,运维省心。
Grok2API & CPA egress quality guard with proxy recovery, quarantine, migration, and ···
 langfuse-docs
开源
一站式调试和优化你的 LLM 应用,从追踪到评估全搞定
Open source agent evals & observability: Trace, evaluate, and improve LLM applicatio···
 vllm-radiance
开源
让 R9700 显卡也能顺畅跑 vLLM 推理服务
Codeberg fork of StillDeadcode / vllm-radiance which is a custom vllm tuned for R970···
 k3ai
开源
几分钟搭好 AI 环境,不用再折腾 K8s 和工具部署。
A lightweight tool to get an AI Infrastructure Stack up in minutes not days. K3ai wi···