

stable-diffusion-videos
两张图之间自动过渡,静态画面秒变动画
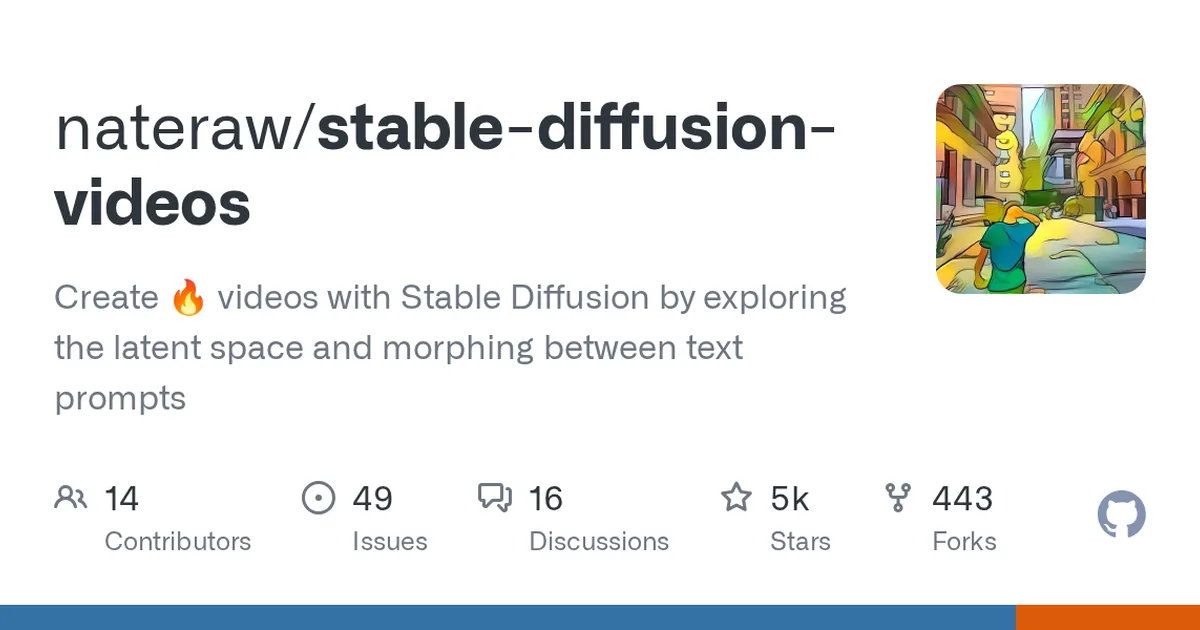
项目预览
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-09 · 当前星标 ★ 4709
使用教程
ℹ 本教程由 AI 依据该项目 README 整理,个别步骤可能需要按你的环境微调。
环境要求
- Python 环境(可用 pip 安装依赖)
- 建议具备 NVIDIA GPU 与 CUDA,示例代码使用 .to("cuda") 与 torch.float16
- Apple M1 芯片需使用 torch.float32,MPS 不支持 float16
- 能访问 Hugging Face 以下载 CompVis/stable-diffusion-v1-4 模型权重
安装与启动步骤
-
1安装依赖库
用 pip 从 PyPI 安装 stable_diffusion_videos,它会一并带出所需的推理依赖。建议在独立虚拟环境中执行,避免污染全局环境。
pip install stable_diffusion_videos -
2准备 Python 脚本
新建一个 .py 文件,导入 StableDiffusionWalkPipeline 与 torch,按 README 示例从预训练模型加载管线并迁移到 cuda。
touch make_video.py -
3填写提示词与参数
在脚本中调用 pipeline.walk,填写起止提示词、随机种子、插值步数、分辨率与输出目录。分辨率大于 512 用 64 的倍数,小于 512 用 8 的倍数。
-
4运行生成视频
执行脚本,管线会在两个提示词的潜在空间之间插值生成画面并合成视频,首次运行需要下载模型权重,耗时较长。
python make_video.py -
5或使用 Colab
不想本地配置环境,可直接打开 README 提供的 Colab 笔记本在线跑通流程,无需本地 GPU。
关键配置
| 配置项 | 必填 | 说明 | 示例 |
|---|---|---|---|
CompVis/stable-diffusion-v1-4 | 是 | from_pretrained 传入的模型 ID,决定使用的 Stable Diffusion 权重 | CompVis/stable-diffusion-v1-4 |
torch_dtype | 否 | 推理精度,CUDA 用 float16 省显存,Apple M1 必须改为 float32 | torch.float16 |
prompts | 是 | 变形起止的文本提示词列表,至少两个 | ['a cat', 'a dog'] |
seeds | 是 | 与提示词一一对应的随机种子,保证画面可控可复现 | [42, 1337] |
num_interpolation_steps | 是 | 两个提示词之间的插值步数,越大过渡越平滑、耗时越长 | 3 |
output_dir | 是 | 生成的图片与视频的保存目录 | dreams |
如何确认成功
脚本正常跑完后,检查 output_dir(如 dreams)目录下是否生成了插值图片和视频文件。
常见问题
Q:在 Apple M1 上运行报错怎么办?
A:MPS 不支持 torch.float16,按 README 提示把 torch_dtype 改成 torch.float32 即可。
Q:分辨率可以随便设吗?
A:README 要求 height/width 大于 512 时用 64 的倍数,小于 512 时用 8 的倍数,否则可能报错或画面异常。
Q:没有本地 GPU 能玩吗?
A:可以,使用 README 中提供的 Colab 笔记本在线运行,免费 GPU 即可完成示例生成。
Q:运行很慢或提示显存不足?
A:首次运行需下载模型权重;显存不足可改用 float16、降低分辨率或减少 num_interpolation_steps。
注意事项
- README 未给出 Python 版本与 CUDA 版本要求,请自行确认环境兼容性
- 示例代码在 README 中被截断,output_dir 之后的内容请参考仓库 examples 目录
- 生成的视频与图片会写入 output_dir,注意磁盘空间占用
核心亮点
- 通过潜在空间插值实现文本提示间的平滑过渡,生成连贯视频,而非简单帧拼接
- 基于Hugging Face Diffusers构建,易于集成和扩展,支持自定义Stable Diffusion模型
- 提供CLI和Python API,使用门槛低,适合快速原型验证和创意实验
不足之处
- 文档/社区待观察
- 视频生成速度较慢,依赖GPU资源,长视频生成可能不稳定
适用场景
- 创意广告和短视频制作,实现文本到动态视觉的快速生成
- 艺术家的生成艺术探索,用于制作风格迁移或概念可视化视频
- AI教育演示,展示Stable Diffusion的潜在空间特性
替代项目
Deforum Stable Diffusion、Stable Diffusion WebUI (AUTOMATIC1111) 的动画扩展、RunwayML
下一篇:video
同类项目推荐
 Tapdance
开源
用命令行快速生成和管理 AI 视频,导演级工作流一步到位。
对接 Seedance 2.0 API & CLI 的AI 导演工作台
 ComfyUI-MiniMax-H3-LongMedia
开源
低显存也能跑长视频音频生成,ComfyUI 一键接入
ComfyUI custom nodes for MiniMax H3 long-form video/audio generation with streamed S···
 OmniVAE
开源
让AI同时生成音视频,跨模态对齐一步到位
A unified audio-video variational autoencoder with cross-modal alignment for joint r···
 short-video-maker
开源
输入主题,自动生成适配多平台的短视频。
Creates short videos for TikTok, Instagram Reels, and YouTube Shorts using the Model···
 articulated-animation
开源
用一张图和一段视频,生成逼真的关节动画
Code for Motion Representations for Articulated Animation paper
 hve-video-director
开源
一句话让 AI 助手跑完视频制作全流程
AI-powered video production pipeline for Claude Code, Github Copilot, Codex, Cursor,···
 swiftube-frontend
开源
像聊天一样,用文字自动生成视频
It's like ChatGPT for videos.
 LTX-2
开源
官方工具包,本地跑通音视频生成还能LoRA微调
Official Python inference and LoRA trainer package for the LTX-2 audio–video genera···
 digan
开源
用隐式表示生成任意长度视频,动态更真实
[ICLR'22] Generating Videos with Dynamics-aware Implicit Generative Adversarial Netw···